Hiểu rõ ollama là gì đang trở thành yêu cầu cấp thiết cho các kỹ sư phần mềm khi nhu cầu tự chủ AI gia tăng. Thay vì phụ thuộc vào đám mây với chi phí token đắt đỏ và rủi ro bảo mật, nền tảng mã nguồn mở này cho phép chạy các mô hình ngôn ngữ lớn ngay trên máy chủ nội bộ. Nắm vững ollama là gì giúp tổ chức làm chủ trọn vẹn tài sản dữ liệu của mình.
Trong vận hành thực tế, gửi dữ liệu khách hàng lên đám mây tiềm ẩn nguy cơ rò rỉ nghiêm trọng. Hiểu rõ ollama là gì mở ra cánh cửa giúp doanh nghiệp hiện thực hóa mục tiêu chạy LLM cục bộ với độ trễ thấp tính bằng mili-giây và không tốn chi phí token. Khi triển khai chạy LLM cục bộ, hệ thống hoàn toàn vận hành ngoại tuyến và an toàn.
Bài cẩm nang chuyên sâu này sẽ đồng hành cùng bạn khám phá toàn diện từ định dạng file GGUF, bảng đối chiếu kỹ thuật, quy trình cài đặt Ollama trên Linux, Docker GPU, macOS và Windows, đến kỹ nghệ Modelfile và chiến lược tối ưu Ollama server chuẩn an ninh production. Nắm vững ollama là gì là bước đi chiến lược cho hạ tầng số tự trị.
Bản chất công nghệ của Ollama và nền tảng suy luận cục bộ
Để trả lời câu hỏi ollama là gì, cần phân biệt giữa mô hình AI và runtime suy luận. Ollama không phải mô hình trí tuệ nhân tạo; Ollama là inference runtime mã nguồn mở giúp quản lý vòng đời, phân bổ bộ nhớ và phục vụ các mô hình như Llama, Mistral hay Qwen trên phần cứng máy chủ. Khái niệm ollama là gì gắn liền với hạ tầng suy luận tinh gọn và tin cậy.
Kiến trúc đóng gói runtime và cơ chế bọc llama.cpp
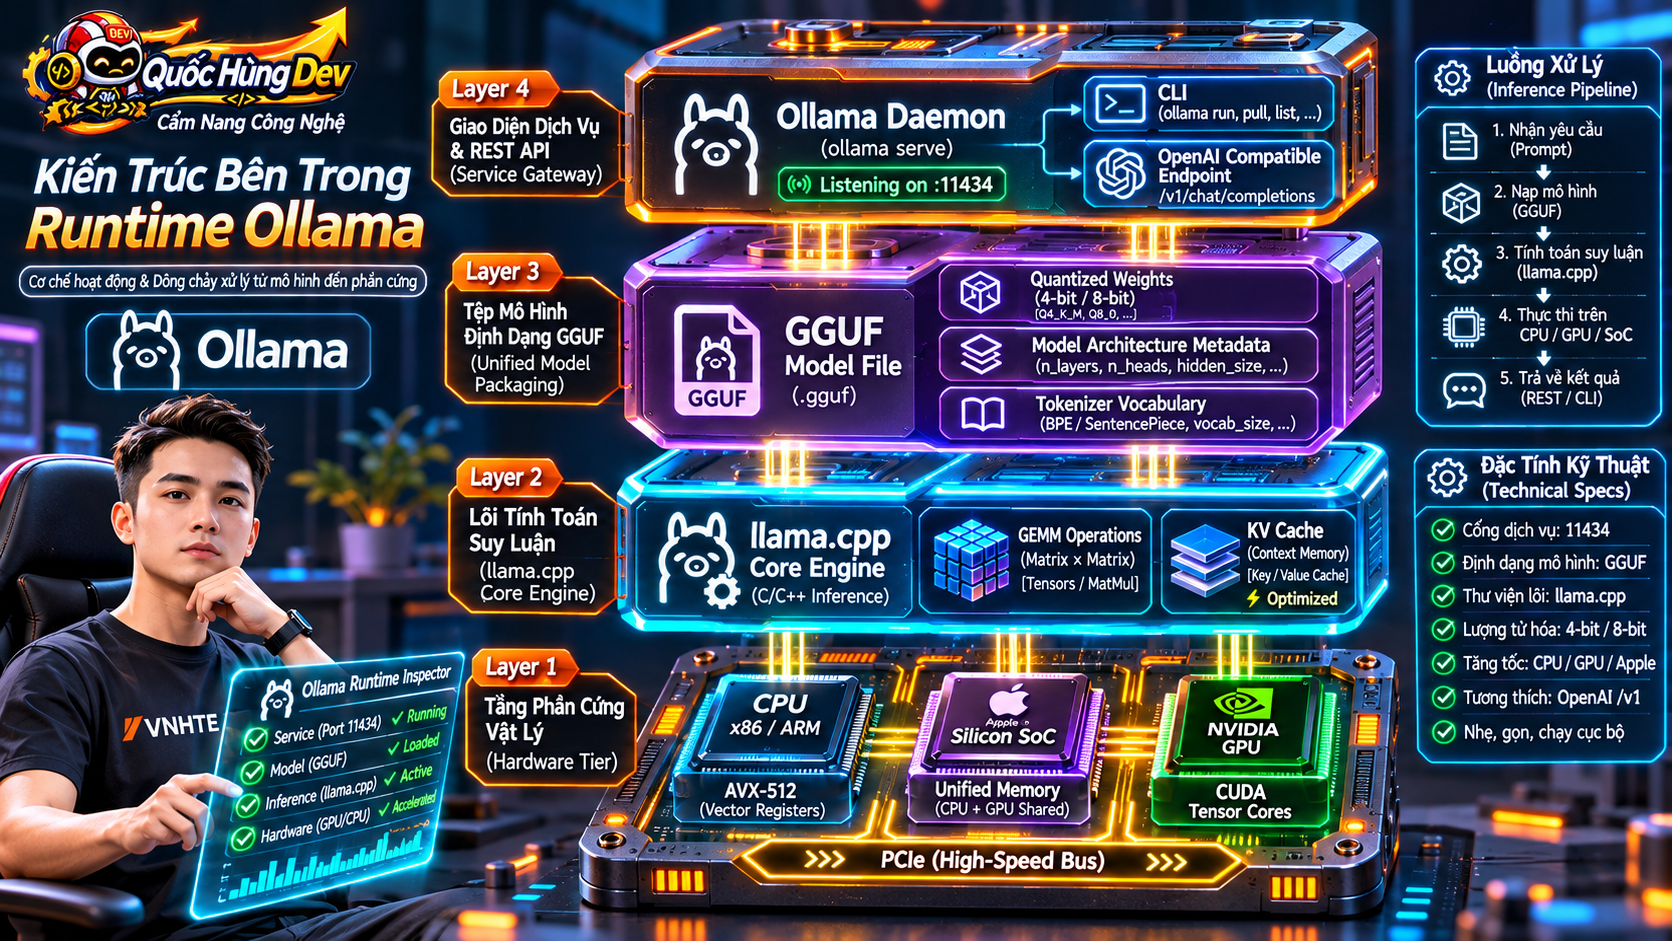
Trọng tâm kỹ thuật giúp hiểu rõ ollama là gì nằm ở lớp lõi tính toán bên dưới. Ollama bọc thư viện llama.cpp bằng C/C++ thuần do Georgi Gerganov phát triển, tối ưu hóa xung nhịp CPU qua tập lệnh vector hóa AVX, AVX2, AVX-512 và tăng tốc phần cứng qua CUDA, ROCm và Apple Metal. Cơ chế này giúp người dùng chạy LLM cục bộ với tốc độ tiệm cận phần cứng gốc. Bất kỳ ai tìm hiểu ollama là gì đều đánh giá cao sự tiện lợi này.
Định dạng mô hình GGUF và các cấp độ quantization
Yếu tố cốt lõi khi tìm hiểu ollama là gì chính là định dạng GGUF. Chuẩn nhị phân này tích hợp trọng số, siêu dữ liệu cấu trúc, từ điển mã hóa và mẫu hội thoại trong một file duy nhất. Định dạng GGUF giúp quy trình chạy LLM cục bộ an toàn, ngăn chặn lỗi thiếu file phụ thuộc khi cài đặt Ollama trên máy chủ mới.
Nhờ định dạng GGUF, Ollama thực thi lượng tử hóa linh hoạt từ 16-bit float xuống 8-bit, 4-bit hoặc 2-bit, giúp giảm dung lượng RAM từ 3 đến 4 lần trong khi giữ trọn 95% đến 98% năng lực tư duy. Hệ thống tự động chọn bản nén chuẩn cân bằng tốt nhất cho dung lượng VRAM. Điều này giải thích vì sao ollama là gì lại vận hành trơn tru trên cả máy tính văn phòng.
Giao diện dòng lệnh CLI và REST API tại cổng 11434
Sức mạnh của Ollama nằm ở tính lưỡng tính: vừa là CLI tương tác nhanh, vừa là daemon chạy ngầm lắng nghe cổng http://127.0.0.1:11434. Bất kỳ ứng dụng nào trong mạng nội bộ đều có thể tương tác với mô hình qua HTTP REST API tiêu chuẩn. Nắm bắt cổng dịch vụ này là bước đầu tiên để làm chủ ollama là gì trong hạ tầng mạng doanh nghiệp.
Khả năng tương thích chuẩn OpenAI API endpoint
Điểm đột phá nhất của Ollama là cung cấp sẵn điểm cuối tương thích chuẩn OpenAI tại http://localhost:11434/v1/chat/completions. Kỹ sư có thể chuyển đổi hệ thống phần mềm sẵn có từ OpenAI sang máy chủ riêng mà không cần sửa code ứng dụng. Bất kỳ ai băn khoăn ollama là gì sẽ tìm thấy câu trả lời tại đây. Bạn có thể kết hợp thêm chiến lược caching với Redis để giảm tải khi chạy LLM cục bộ.
Bảng so sánh tổng quan nhanh & phân loại giải pháp chạy LLM
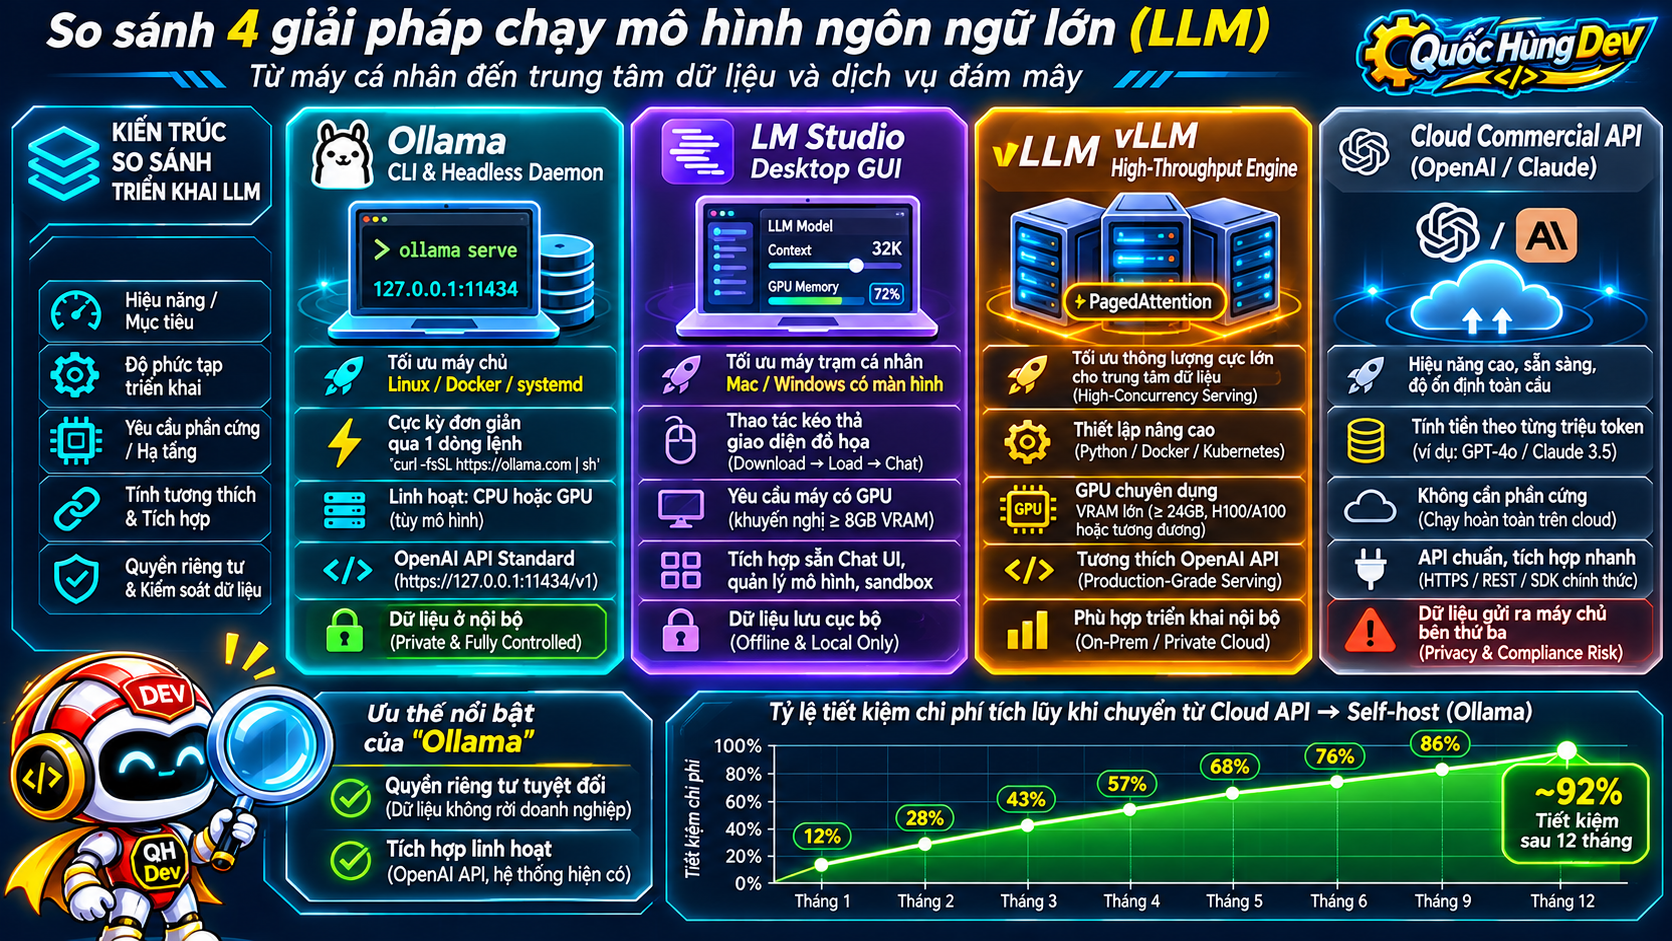
Để định vị vị thế công nghệ của Ollama, việc đối chiếu giữa Ollama, LM Studio, vLLM và OpenAI ChatGPT mang lại góc nhìn đa chiều cho nhà quản trị. Trong phép so sánh Ollama và LM Studio, bản chất ollama là gì thể hiện rõ nét qua các tiêu chí về tính tự động hóa máy chủ và năng lực mở rộng hạ tầng.
| Tiêu chí đánh giá | Ollama | LM Studio | vLLM | OpenAI API (Cloud) |
|---|---|---|---|---|
| Mục đích chính | CLI & REST API máy chủ | Desktop GUI cá nhân | Production High-Throughput | Dịch vụ đám mây công cộng |
| Giao diện người dùng | CLI dòng lệnh thuần túy | Giao diện đồ họa máy tính | API Endpoint / WebUI phụ trợ | Web Dashboard & REST API |
| Định dạng mô hình | GGUF (tối ưu hóa llama.cpp) | GGUF (llama.cpp engine) | AWQ, GPTQ, FP16, BF16 | Mô hình độc quyền đóng gói |
| Triển khai máy chủ Linux | Rất xuất sắc (systemd/Docker) | Hạn chế (yêu cầu màn hình) | Chuyên dụng cho cụm máy chủ | Không cần máy chủ tự host |
| Yêu cầu phần cứng | Linh hoạt (CPU, Metal, GPU) | Máy trạm cá nhân có màn hình | Bắt buộc GPU dung lượng lớn | Chỉ cần kết nối Internet |
| Bảo mật dữ liệu nội bộ | 100% On-Premise tuyệt đối | 100% On-Premise tuyệt đối | 100% On-Premise tuyệt đối | Dữ liệu gửi lên đám mây |
| Chi phí vận hành | Chi phí điện & phần cứng | Chi phí điện máy trạm | Chi phí hạ tầng máy chủ lớn | Tính tiền theo từng token |
| Tương thích OpenAI API | Có sẵn tại cổng 11434 | Có sẵn cổng cục bộ | Có sẵn cổng tương thích | Chuẩn gốc thương mại |
Bảng đối chiếu khẳng định rằng khi tìm hiểu ollama là gì trong bài toán doanh nghiệp, công cụ này vượt trội hoàn toàn về khả năng tích hợp hệ sinh thái so với phần mềm thuần GUI. Để vận hành hệ thống ổn định khi chạy LLM cục bộ, áp dụng quy trình tối ưu Ollama server sẽ đảm bảo hiệu năng phục vụ liên tục.
Điểm khác biệt cốt lõi: so sánh Ollama và LM Studio cùng các runtime khác
Khi lựa chọn công cụ thực thi mô hình AI, kỹ sư thường phân vân giữa Ollama và LM Studio. Việc so sánh Ollama và LM Studio dựa trên kiến trúc và kịch bản thực tế là rất cần thiết. Hiểu rõ bản chất ollama là gì giúp bạn xác định đúng ranh giới ứng dụng giữa hai giải pháp hàng đầu này.
Trải nghiệm người dùng giữa CLI headless và giao diện desktop GUI
Khác biệt rõ nhất trong phép so sánh Ollama và LM Studio nằm ở giao diện người dùng. LM Studio là ứng dụng desktop đồ họa hoàn chỉnh, hỗ trợ tìm kiếm mô hình Hugging Face và tinh chỉnh tham số trực quan. Đây là giải pháp phù hợp cho nhà nghiên cứu thử nghiệm nhanh trên máy tính cá nhân có màn hình.
Ngược lại, Ollama theo đuổi triết lý UNIX tối giản và tập trung vào chế độ không màn hình. Ollama giao tiếp thuần túy qua CLI và REST API, biến máy chủ thành trung tâm tính toán AI phục vụ nhiều người đồng thời. Vì thế, ollama là gì luôn là chủ đề được kỹ sư DevOps quan tâm hàng đầu khi chạy LLM cục bộ.
Khả năng triển khai production trên máy chủ Linux không màn hình
Trên máy chủ Linux hoặc máy chủ ảo VPS không cài giao diện đồ họa, phép so sánh Ollama và LM Studio chứng minh ưu thế của Ollama khi LM Studio gặp nhiều rào cản thư viện GUI. Bạn có thể tham khảo cẩm nang dùng Claude Code quản trị VPS để tối ưu hóa quản trị hệ thống Linux từ xa.
Ollama hoạt động hoàn hảo trên máy chủ Linux thuần túy với một tệp nhị phân duy nhất, hỗ trợ systemd daemon và Docker NVIDIA GPU. Đối với quản trị viên hệ thống, câu trả lời cho ollama là gì chính là một dịch vụ backend chuẩn mực để chạy LLM cục bộ trong môi trường sản xuất.
Đánh đổi giữa tính tiện lợi đóng gói và khả năng tinh chỉnh tham số sâu
Về mặt đánh đổi kỹ thuật khi so sánh Ollama và LM Studio, Ollama trừu tượng hóa các tham số phức tạp vào Modelfile cấp cao, giúp người dùng tiếp cận nhanh nhưng hạn chế can thiệp vi mô vào kernel tính toán sâu của llama.cpp.
Dù vậy, đối với đại đa số nhu cầu doanh nghiệp, cấu hình mặc định của Ollama đã đạt độ cân bằng tối ưu. Hiểu rõ ollama là gì cùng những ưu nhược điểm này giúp bạn tự tin quyết định công cụ phù hợp cho từng giai đoạn dự án.
Phân tích kỹ thuật & hướng dẫn cài đặt Ollama trên mọi nền tảng
Nắm vững quy trình cài đặt Ollama trên từng hệ điều hành là nền tảng để thiết lập hạ tầng trí tuệ nhân tạo ổn định. Dù thao tác trên laptop cá nhân hay cụm máy chủ doanh nghiệp, việc cài đặt Ollama đều diễn ra nhanh chóng nhờ các gói cài đặt tối ưu. Sau khi cài đặt, bản chất ollama là gì sẽ thể hiện qua từng lệnh thực thi.
Cài đặt native trên Ubuntu và Debian Linux qua bash script
Trên môi trường Linux như Ubuntu hay Debian, quy trình cài đặt Ollama được tự động hóa qua tập lệnh shell chính thức, tự nhận diện kiến trúc phần cứng và tích hợp trình điều khiển CUDA thích hợp:
# Tải và thực thi tập lệnh cài đặt Ollama tự động trên Linux
curl -fsSL https://ollama.com/install.sh | sh

# Kiểm tra trạng thái dịch vụ nền sau khi cài đặt thành công
systemctl status ollama

# Kiểm tra phiên bản thực thi để xác nhận cài đặt chuẩn xác
ollama --version
Tiến trình Ollama daemon sẽ tự động khởi chạy dưới dạng dịch vụ nền của hệ điều hành, giúp tiết kiệm bộ nhớ RAM tối đa cho việc tính toán tensor. Hiểu rõ ollama là gì giúp quản trị viên tự tin kiểm soát tài nguyên khi thực hiện tối ưu Ollama server.
Thiết lập trên macOS với Apple Silicon Metal và Windows với WSL2
Trên macOS sử dụng Apple Silicon, Ollama khai thác tối đa bộ nhớ hợp nhất Metal với băng thông cực cao. Người dùng chỉ cần tải gói cài đặt từ trang chủ và khởi chạy là toàn bộ tăng tốc phần cứng được kích hoạt tự động khi khám phá ollama là gì.
Trên Windows, bạn có thể dùng file cài đặt hoặc triển khai trong môi trường WSL2 Ubuntu để tận dụng card đồ họa NVIDIA GeForce qua cầu nối CUDA, đảm bảo tốc độ tương đương Linux nguyên bản. Việc nắm vững ollama là gì giúp quy trình vận hành đồng bộ trên mọi nền tảng.
Triển khai container hóa với Docker và hỗ trợ NVIDIA GPU
Trong môi trường điều phối container, việc container hóa khi cài đặt Ollama giúp quản lý phiên bản dễ dàng. Tham khảo thêm bài viết so sánh Docker vs Podman và cẩm nang MicroVM vs Container để lựa chọn giải pháp ảo hóa tối ưu khi chạy LLM cục bộ. Dưới đây là tệp Docker Compose chuẩn mực:
services:
  ollama:
    image: ollama/ollama:latest
    container_name: ollama-server
    restart: always
    ports:
      - "11434:11434"
    volumes:
      - ./ollama_data:/root/.ollama
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]
Cấu hình Docker này giúp đội ngũ vận hành sao lưu dữ liệu trọng số mô hình và đồng bộ vào luồng CI/CD an toàn. Hiểu thấu ollama là gì trong môi trường container chính là chìa khóa mở rộng quy mô hệ thống.
Làm chủ Modelfile và kỹ thuật tùy biến mô hình chuyên sâu
Tính năng nổi bật khẳng định giá trị của ollama là gì chính là cơ chế đóng gói Modelfile. Tương tự Dockerfile, Modelfile cho phép thiết lập hành vi, nhân cách và tham số suy luận của mô hình trong file text thuần túy, nâng tầm hiệu quả khi chạy LLM cục bộ.
Cấu trúc cơ bản của Modelfile và các chỉ thị cốt lõi
Cấu hình Modelfile gồm các chỉ thị FROM chỉ định mô hình gốc, PARAMETER tinh chỉnh lấy mẫu, và SYSTEM thiết lập vai trò. Sau khi cài đặt Ollama, bạn có thể tạo mô hình chuyên môn bằng file mẫu dưới đây:
# Chỉ định mô hình nền tảng gốc từ thư viện Ollama
FROM qwen2.5:7b-instruct

# Cấu hình cửa sổ ngữ cảnh mở rộng lên 8192 token
PARAMETER num_ctx 8192

# Kiểm soát mức độ sáng tạo và độ ngẫu nhiên của câu trả lời
PARAMETER temperature 0.3

# Kiểm soát đa dạng từ vựng trong thuật toán lấy mẫu
PARAMETER top_p 0.85

# Định nghĩa vai trò chuyên gia kỹ thuật cho mô hình
SYSTEM """Bạn là chuyên gia kiến trúc phần mềm cao cấp tại VNHTE. Bạn luôn phản hồi bằng tiếng Việt chuyên môn chính xác, đưa ra mã nguồn sạch, tối ưu và giải thích cặn kẽ từng quyết định thiết kế hệ thống."""
Để biên dịch Modelfile thành mô hình hoàn chỉnh sẵn sàng phục vụ khi tìm hiểu ollama là gì, bạn chỉ cần thực thi hai câu lệnh đơn giản trên terminal:
# Biên dịch mô hình tùy biến mới từ tệp Modelfile
ollama create vnhte-architect -f ./Modelfile

# Khởi chạy thử nghiệm mô hình vừa tạo lập
ollama run vnhte-architect
Nhập mô hình GGUF tùy chỉnh từ Hugging Face
Ngoài kho mô hình chính thức, bạn có thể nhập bất kỳ file GGUF tùy biến nào từ Hugging Face qua chỉ thị FROM ./model.gguf. Sự linh hoạt này chứng minh vì sao nắm vững ollama là gì lại mang đến lợi thế vượt bậc cho doanh nghiệp.
Tích hợp lập trình: gọi Ollama từ Python, Node.js và curl
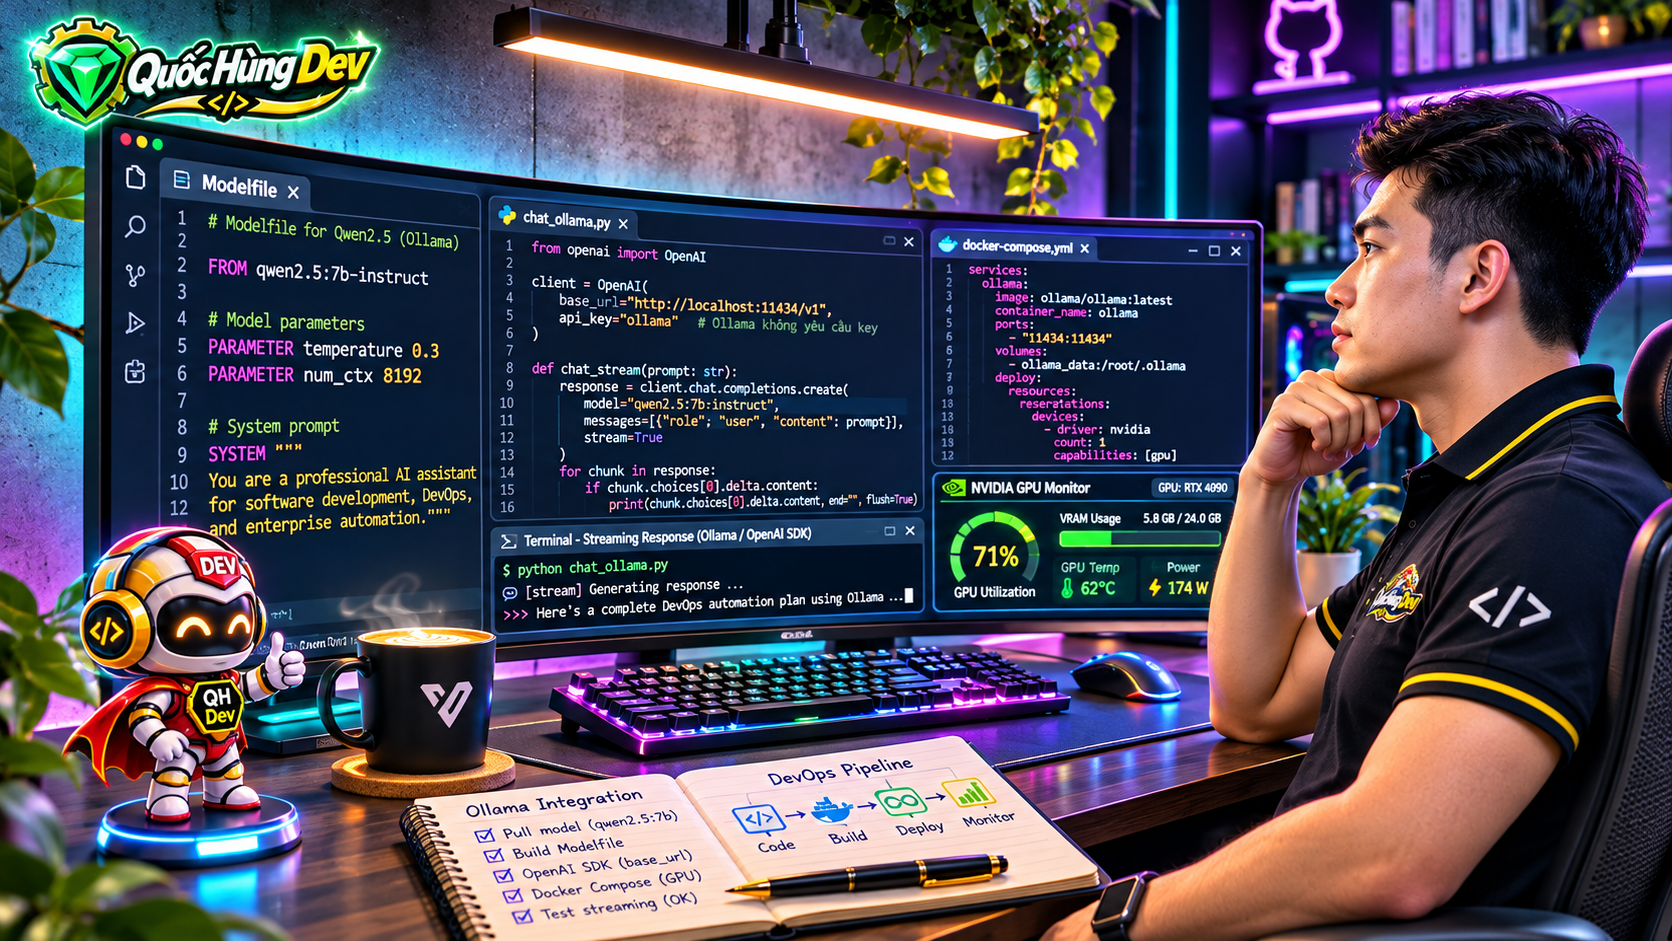
Hạ tầng AI chỉ phát huy giá trị khi kết nối liền mạch vào ứng dụng nghiệp vụ hiện có. Với REST API tiêu chuẩn, việc tích hợp phần mềm vào Ollama diễn ra thuận tiện, mở ra tiềm năng to lớn của ollama là gì trong tự động hóa quy trình.
Thao tác gửi truy vấn REST API bằng curl
Cách nhanh nhất để kiểm tra phản hồi của máy chủ nhằm hiểu rõ ollama là gì là sử dụng curl gửi truy vấn đối thoại JSON trực tiếp qua HTTP:
# Gửi truy vấn đối thoại trực tiếp đến REST API của Ollama
curl -X POST http://localhost:11434/api/chat -d '{
  "model": "qwen2.5:7b-instruct",
  "messages": [
    {
      "role": "user",
      "content": "Giải thích ngắn gọn ollama là gì và lợi ích khi chạy LLM cục bộ?"
    }
  ],
  "stream": false
}'
Xây dựng ứng dụng Python với thư viện ollama-python và OpenAI SDK
Trong Python, bạn có thể dùng thư viện chính thức hoặc dùng OpenAI SDK trỏ base_url về máy chủ Ollama. Sau khi hoàn tất cài đặt Ollama, đoạn mã Python dưới đây minh họa kết nối tiêu chuẩn:
import os
from openai import OpenAI

# Khởi tạo client kết nối đến Ollama qua OpenAI compatibility endpoint
client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama"  # Ollama không bắt buộc khóa API ở chế độ mặc định
)

# Gửi yêu cầu hoàn thiện câu trả lời
response = client.chat.completions.create(
    model="qwen2.5:7b-instruct",
    messages=[
        {"role": "system", "content": "Bạn là chuyên gia tư vấn công nghệ AI."},
        {"role": "user", "content": "Cho tôi biết ollama là gì và cách bắt đầu cài đặt Ollama?"}
    ],
    temperature=0.3
)

print(response.choices[0].message.content)
Nhờ tính tương thích này, việc chuyển đổi giữa mô hình thương mại và máy chủ nội bộ diễn ra hoàn toàn trong suốt. Bạn có thể xem thêm hướng dẫn chọn model Claude để phân bổ tác vụ hợp lý khi chạy LLM cục bộ. Hiểu rõ ollama là gì giúp hoàn thiện toàn diện kiến trúc phần mềm.
Tình huống ứng dụng thực tế theo phòng ban và doanh nghiệp
Để nhận thấy giá trị thực tiễn khi tìm hiểu ollama là gì, chúng ta cùng xem xét các kịch bản triển khai thành công tại doanh nghiệp, giúp loại bỏ rủi ro bảo mật và gia tăng năng suất làm việc.
Trợ lý lập trình viên nội bộ bảo mật mã nguồn độc quyền
Tại các đơn vị công nghệ, mã nguồn dự án là tài sản bảo mật cao nhất. Kết nối mô hình Qwen2.5-Coder chạy qua Ollama vào VS Code hoặc Cursor qua API cục bộ giúp lập trình viên viết code thông minh mà dữ liệu không bao giờ rời khỏi mạng nội bộ. Nắm bắt ollama là gì giúp bảo vệ an toàn tài sản số khi chạy LLM cục bộ.
Hệ thống hỏi đáp tài liệu RAG cho khối pháp chế và nhân sự
Khối pháp chế và nhân sự thường xử lý lượng lớn hợp đồng và tài liệu mật. Kết hợp Ollama với cơ sở dữ liệu vector trong kiến trúc RAG cho phép xây dựng trợ lý tra cứu thông minh sau khi cài đặt Ollama, loại bỏ nguy cơ lộ bí mật kinh doanh khi chạy LLM cục bộ.
Tự động hóa phân tích dữ liệu nhật ký và cảnh báo DevOps
Trong quản trị hệ thống, mô hình Llama 3.2 3B trên máy chủ Ollama có thể phân tích nhật ký server liên tục và cảnh báo sự cố cho kỹ sư trực ca, rút ngắn thời gian khắc phục hạ tầng. Hiểu rõ ollama là gì mang lại bước tiến lớn cho đội ngũ vận hành.
Chi phí phần cứng, hạn mức VRAM và bài toán đầu tư hạ tầng
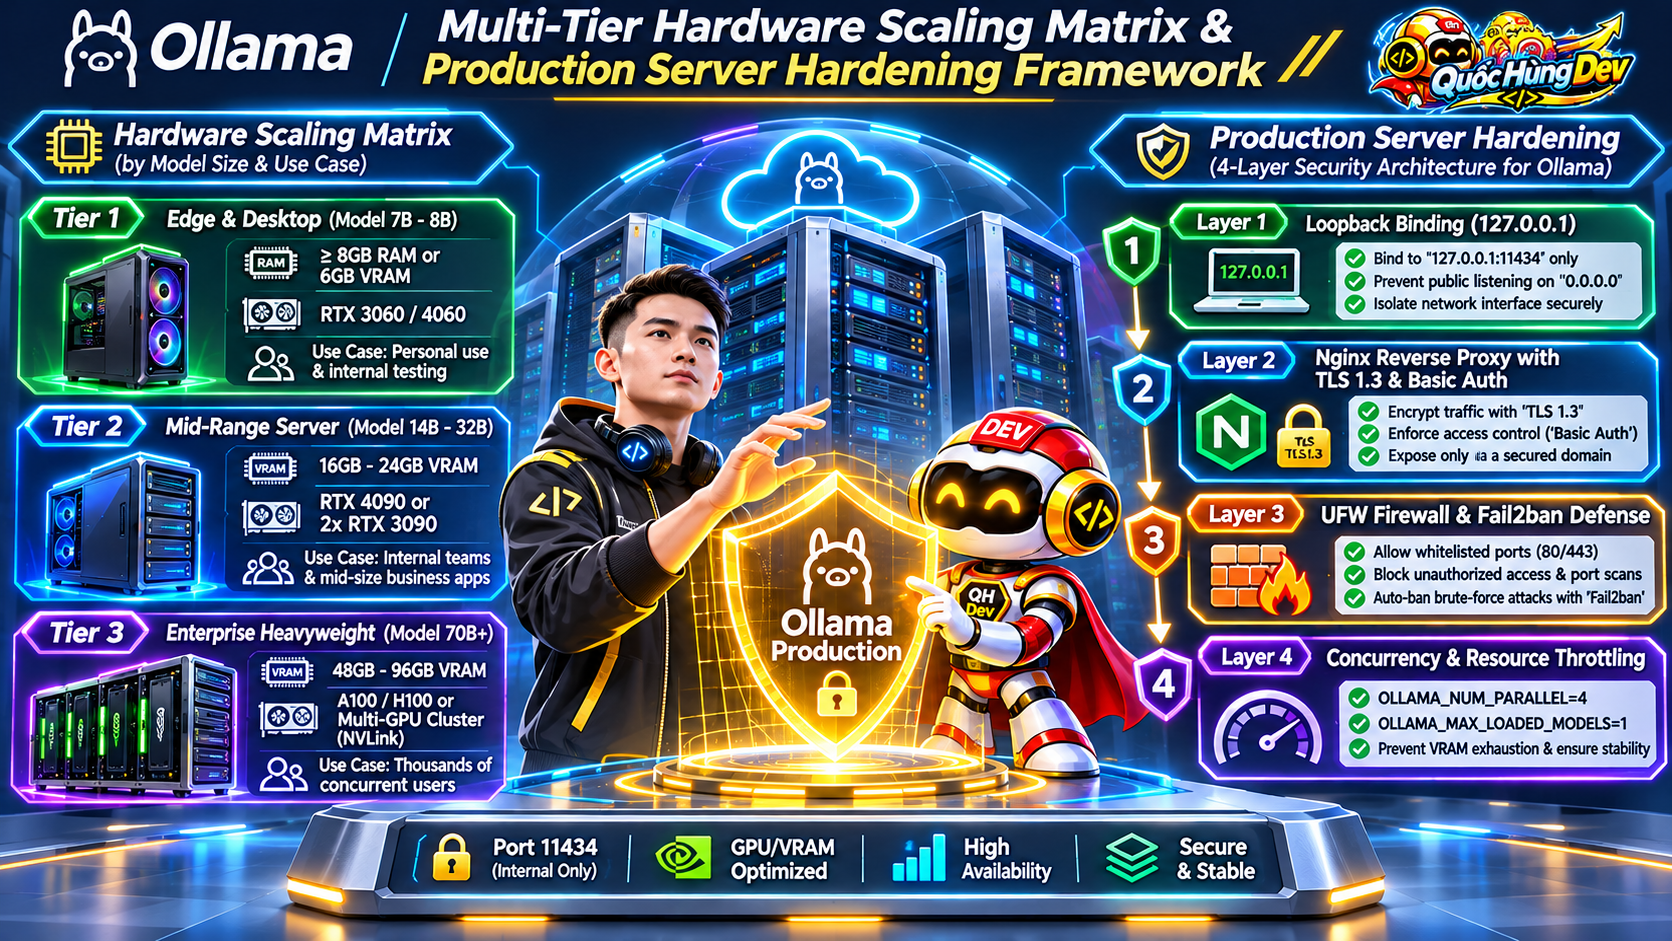
Yếu tố quan trọng khi cân nhắc ollama là gì đối với nhà quản lý là chi phí phần cứng và dung lượng VRAM. Nắm bắt mối quan hệ giữa tham số mô hình và bộ nhớ GPU giúp doanh nghiệp tối ưu Ollama server và đầu tư hiệu quả.
Bảng định mức phần cứng theo quy mô tham số mô hình
Dưới đây là bảng định mức phần cứng khuyến nghị khi tìm hiểu ollama là gì cho các mô hình lượng tử hóa 4-bit (Q4_K_M) thông dụng khi vận hành thực tế:
| Kích thước mô hình | Mô hình tiêu biểu | VRAM tối thiểu (Q4) | RAM hệ thống | Phần cứng khuyến nghị |
|---|---|---|---|---|
| Nhỏ (1B – 3B) | Llama 3.2 (1B/3B), Qwen 2.5 (3B) | 2 GB – 4 GB | 8 GB – 16 GB | Laptop văn phòng, CPU hiện đại, Apple M1/M2/M3 |
| Trung bình (7B – 9B) | Llama 3.1 (8B), Qwen 2.5 (7B), Mistral (7B) | 6 GB – 8 GB | 16 GB – 32 GB | NVIDIA RTX 3060/4060 (8GB/12GB), Mac Mini 16GB/24GB |
| Lớn (14B) | Qwen 2.5 (14B) | 10 GB – 12 GB | 32 GB | NVIDIA RTX 4070 (12GB) hoặc RTX 3060 (12GB) |
| Rất lớn (32B) | Qwen 2.5 (32B), DeepSeek-R1 (32B) | 20 GB – 24 GB | 64 GB | NVIDIA RTX 3090/4090 (24GB), Mac Studio 32GB/64GB |
| Doanh nghiệp (70B) | Llama 3.3 (70B), Qwen 2.5 (72B) | 40 GB – 48 GB | 128 GB | 2x NVIDIA RTX 3090/4090 hoặc 1x NVIDIA A100 (80GB) |
Cơ chế offload đa tầng giữa VRAM card đồ họa và RAM hệ thống
Ưu điểm lớn giúp chuyên gia đánh giá cao ollama là gì là cơ chế layer offloading từ llama.cpp. Khi mô hình vượt dung lượng VRAM, hệ thống tự động đẩy các tầng còn lại sang RAM hệ thống để CPU xử lý thay vì bị lỗi tràn bộ nhớ.
Dù tốc độ chạy trên RAM chậm hơn GPU thuần túy, tính năng này đảm bảo hệ thống luôn hoạt động ổn định và linh hoạt cho doanh nghiệp cần chạy LLM cục bộ trước khi nâng cấp phần cứng. Hiểu thấu ollama là gì giúp tối ưu lộ trình chi phí.
Ma trận ra quyết định theo quy mô hệ thống
Hoạch định hạ tầng Ollama cần bám sát quy mô nhân sự và tần suất truy vấn. Ma trận dưới đây hỗ trợ nhà quản lý chọn phương án phù hợp, đặc biệt trong các kịch bản so sánh Ollama và LM Studio để định hình kiến trúc:
Máy trạm cá nhân
Phù hợp cho lập trình viên và chuyên gia nghiên cứu độc lập khi bắt đầu tìm hiểu ollama là gì. Máy tính trang bị một GPU tầm trung như RTX 3060 12GB hoặc chip Apple Silicon 16GB RAM hợp nhất đáp ứng hoàn hảo nhu cầu chạy các mô hình 7B đến 8B phục vụ viết mã và dịch thuật cá nhân với ngân sách tiết kiệm.
Máy chủ nội bộ SME
Dành cho doanh nghiệp phục vụ 20 đến 100 nhân sự truy vấn đồng thời. Cấu hình tiêu chuẩn gồm máy chủ đa nhân, 64GB RAM và 1 đến 2 GPU RTX 3090 hoặc RTX 4090 (24GB VRAM), phục vụ trơn tru các mô hình 14B đến 32B cho hệ thống RAG và tự động hóa quy trình nghiệp vụ.
Cụm máy chủ lớn
Dành cho tập đoàn lớn với hàng nghìn truy vấn mỗi phút. Kiến trúc gồm nhiều node GPU chuyên dụng đặt sau hệ thống cân bằng tải HAProxy/Nginx. Khi cần mở rộng quy mô lớn, doanh nghiệp có thể kết hợp vLLM và Ollama để tối ưu hiệu suất tài nguyên.
Ma trận ra quyết định giúp doanh nghiệp tránh lãng phí ngân sách và xây dựng lộ trình mở rộng vững chắc. Nắm vững ollama là gì chính là chìa khóa định hình hạ tầng AI dài hạn.
Checklist an toàn & kinh nghiệm tối ưu Ollama server trong production
Khi chuyển từ môi trường thử nghiệm sang sản xuất, thiết lập an ninh và áp dụng kinh nghiệm tối ưu Ollama server là yêu cầu bắt buộc. Mặc định Ollama tối ưu cho môi trường cục bộ, do đó cần bổ sung bảo vệ mạng khi triển khai. Nắm vững ollama là gì giúp bảo vệ hệ thống sau khi cài đặt Ollama.
Bảo mật cổng 11434 với reverse proxy Nginx và xác thực khóa API
Mở cổng trực tiếp 0.0.0.0:11434 ra Internet tiềm ẩn rủi ro tấn công nghẽn mạng nghiêm trọng. Để đảm bảo an toàn khi tối ưu Ollama server, cần cấu hình Ollama lắng nghe cục bộ 127.0.0.1 và đặt máy chủ reverse proxy là gì như Nginx phía trước để xác thực API key và mã hóa HTTPS:
server {
    listen 443 ssl http2;
    server_name ai.vnhte.com;

    ssl_certificate /etc/letsencrypt/live/ai.vnhte.com/fullchain.pem;
    ssl_certificate_key /etc/letsencrypt/live/ai.vnhte.com/privkey.pem;

    location / {
        # Kiểm tra khóa API bí mật trong tiêu đề Authorization
        if ($http_authorization != "Bearer KHOA_BI_MAT_DOANH_NGHIEP_VNHTE") {
            return 401 '{"error": "Yêu cầu khóa xác thực API hợp lệ"}';
        }

        proxy_pass http://127.0.0.1:11434;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;

        # Cấu hình hỗ trợ truyền dữ liệu streaming thời gian thực
        proxy_buffering off;
        proxy_read_timeout 600s;
    }
}
Quản lý đa phiên đồng thời với OLLAMA_NUM_PARALLEL
Để phục vụ nhiều người dùng đồng thời, kỹ thuật tối ưu Ollama server quan trọng là cấu hình biến môi trường OLLAMA_NUM_PARALLEL, cho phép xử lý song song nhiều luồng ngữ cảnh trên cùng bộ trọng số GPU nhằm tăng thông lượng:
# Thêm các cấu hình tối ưu vào tệp dịch vụ systemd của Ollama
[Service]
Environment="OLLAMA_NUM_PARALLEL=4"
Environment="OLLAMA_MAX_LOADED_MODELS=2"
Environment="OLLAMA_KEEP_ALIVE=24h"
Thiết lập OLLAMA_KEEP_ALIVE=24h giữ mô hình luôn lưu trú sẵn trong VRAM, loại bỏ độ trễ nạp file cho truy vấn đầu tiên trong ngày. Đây là kinh nghiệm then chốt khi tối ưu Ollama server. Nắm chắc ollama là gì giúp duy trì dịch vụ liên tục.
Khi khai thác mô hình qua Ollama, doanh nghiệp cần tuân thủ giấy phép sử dụng của từng mô hình cụ thể. Điển hình như Meta Llama yêu cầu giấy phép thương mại riêng nếu vượt 700 triệu người dùng, hoặc cấm dùng kết quả đầu ra để huấn luyện mô hình cạnh tranh. Tuân thủ ToS là nghĩa vụ bắt buộc khi làm chủ ollama là gì.
Câu hỏi thường gặp về Ollama và chạy mô hình cục bộ
Ollama là gì và công cụ này có hoàn toàn miễn phí không?
Ollama là nền tảng thực thi mô hình ngôn ngữ lớn mã nguồn mở theo giấy phép MIT hoàn toàn miễn phí. Bạn có thể tự do cài đặt và sử dụng trên máy tính hoặc máy chủ mà không tốn phí bản quyền khi chạy LLM cục bộ. Hiểu rõ ollama là gì giúp tối ưu hóa ngân sách công nghệ hàng năm.
Không có card đồ họa GPU rời thì có thể cài đặt Ollama được không?
Nhờ lõi llama.cpp tối ưu cho CPU với tập lệnh AVX/AVX2, quy trình cài đặt Ollama vẫn vận hành tốt trên bộ xử lý Intel hoặc AMD không có card rời. Dù tốc độ chậm hơn GPU, chọn mô hình nhẹ 1B đến 3B vẫn mang lại trải nghiệm tốt khi tìm hiểu ollama là gì.
Làm thế nào để đổi cổng mạng hoặc cho phép truy cập từ máy tính khác?
Mặc định Ollama chỉ lắng nghe nội bộ tại 127.0.0.1:11434. Để cho phép mạng nội bộ truy cập nhằm tối ưu Ollama server, bạn chỉ cần thiết lập biến OLLAMA_HOST=0.0.0.0:11434 trong systemd trên Linux hoặc biến môi trường trên Windows rồi khởi động lại dịch vụ.
Khi nào nên chọn so sánh Ollama và LM Studio để triển khai?
Khi so sánh Ollama và LM Studio, hãy chọn LM Studio nếu cần giao diện đồ họa trực quan trên máy cá nhân để thử nghiệm nhanh. Hãy chọn Ollama nếu bạn cần tích hợp API vào code ứng dụng hoặc chạy dịch vụ nền ổn định trên máy chủ. Nắm bắt ollama là gì giúp bạn chọn đúng giải pháp.
Dữ liệu đối thoại với Ollama có bị gửi về máy chủ bên ngoài không?
Toàn bộ dữ liệu câu lệnh và tính toán đều xử lý cục bộ trên RAM và GPU của máy chủ nội bộ. Ollama chỉ kết nối Internet khi bạn chủ động gửi lệnh tải mô hình mới từ kho lưu trữ về máy khi cài đặt Ollama. Tính năng ngoại tuyến tuyệt đối khẳng định giá trị của ollama là gì.
Kết luận & định hướng công nghệ bền vững
Tổng kết hành trình khám phá ollama là gì, đây thực sự là trụ cột then chốt trong xu hướng chuyển dịch hạ tầng AI sang tự chủ nội bộ. Sự kết hợp giữa llama.cpp, định dạng GGUF và REST API chuẩn mực giúp bài toán chạy LLM cục bộ trở nên dễ tiếp cận cho mọi tổ chức. Nắm vững ollama là gì giúp doanh nghiệp tự tin làm chủ làn sóng công nghệ.
Lộ trình khuyến nghị cho kỹ sư là bắt đầu từ bước vững chắc: cài đặt Ollama trên môi trường thử nghiệm, làm chủ Modelfile để tinh chỉnh trợ lý, tích hợp vào mã nguồn phần mềm và áp dụng kinh nghiệm tối ưu Ollama server về bảo mật trước khi vận hành quy mô lớn.
Làm chủ suy luận AI cục bộ hôm nay là nền tảng để doanh nghiệp bảo vệ tài sản số, tiết kiệm ngân sách và tạo lợi thế cạnh tranh tiên phong. Hiểu rõ ollama là gì chính là chìa khóa mở ra cánh cửa hạ tầng số tự trị.
Tài liệu tham khảo chuyên môn: Ollama Official Platform, GitHub ollama/ollama Repository, Ollama Documentation & API Reference, llama.cpp Project by Georgi Gerganov.