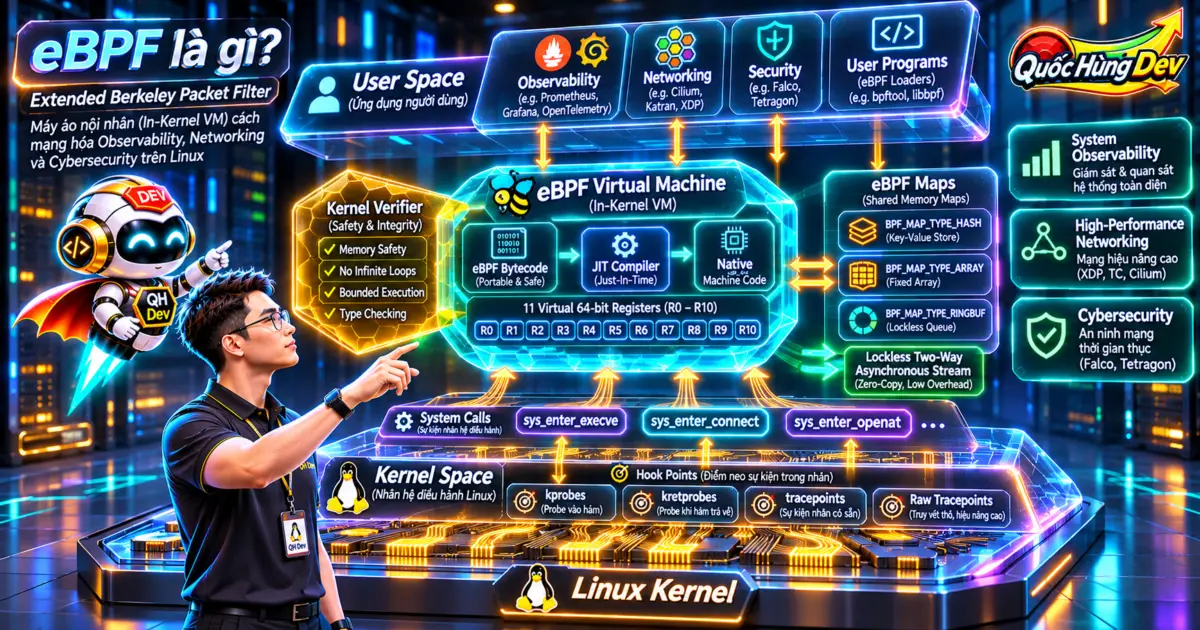
eBPF là gì và vì sao công nghệ này đang định hình lại toàn bộ bức tranh giám sát hệ thống trong kỷ nguyên điện toán đám mây là câu hỏi cốt lõi của mọi kỹ sư hạ tầng khi đối mặt với bài toán tối ưu hiệu năng. Trong môi trường máy chủ sản xuất thực tế, việc nắm bắt chính xác những gì đang diễn ra bên dưới tầng nhân Linux mà không làm gián đoạn hoặc gây suy giảm tốc độ xử lý luôn là một thách thức kỹ thuật lớn.
Trước đây, các kỹ sư thường phải lựa chọn giữa hai thái cực đầy rủi ro: hoặc dùng strace gây suy giảm nặng nề thông lượng do chuyển đổi ngữ cảnh liên tục; hoặc mạo hiểm viết mô-đun nhân Linux (LKM) với nguy cơ chỉ một lỗi con trỏ nhỏ cũng làm sập toàn bộ máy chủ (Kernel Panic). Sự xuất hiện của eBPF là gì đã phá vỡ hoàn toàn thế bế tắc này bằng cách cung cấp môi trường máy ảo an toàn, cho phép nhúng và thực thi mã nhị phân trực tiếp trong nhân Linux với độ trễ tính bằng nano giây.
Bài cẩm nang chuyên sâu này phân tích toàn diện từ bản chất công nghệ, kiến trúc máy ảo in-kernel, cơ chế kiểm chứng an toàn bytecode, đối chiếu kỹ thuật chi tiết giữa so sánh ebpf và kernel module, hướng dẫn thực hành truy vết với hướng dẫn sử dụng bpftrace, cho đến các chiến lược thực chiến nhằm tối ưu tài nguyên giám sát kernel cho hạ tầng phân tán. Việc thấu hiểu tường tận eBPF là gì sẽ giúp bạn nâng tầm năng lực quan sát hệ thống (Observability) lên một chuẩn mực hoàn toàn mới.
Định nghĩa bản chất công nghệ & nền tảng cốt lõi
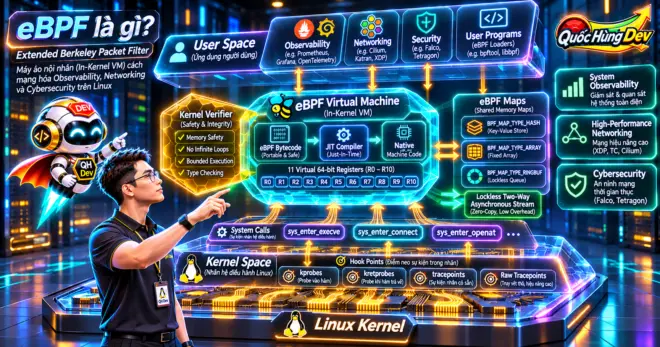
Để hiểu rõ gốc rễ của câu hỏi eBPF là gì, chúng ta cần tiếp cận công nghệ này dưới góc độ một nền tảng lập trình có thể mở rộng (Programmable Infrastructure Engine). Nhờ đó, câu hỏi eBPF là gì luôn gắn liền với khái niệm lập trình hạt nhân an toàn. Viết tắt từ Extended Berkeley Packet Filter, eBPF bản chất là máy ảo vi mô (In-Kernel Virtual Machine) tích hợp sẵn vào nhân hệ điều hành Linux.
Cơ chế vận hành này giúp eBPF là gì trở thành trụ cột cho bốn lĩnh vực: Quan sát toàn diện (Observability), Giám sát an ninh thời gian thực (Runtime Security), Mạng hiệu năng cao (High-Performance Networking) và Phân tích hồ sơ hiệu năng (Continuous Profiling). Khi tiến trình thực hiện System Call, gửi nhận gói tin mạng hoặc ghi dữ liệu xuống đĩa, nhân Linux kích hoạt các điểm neo (Hooks) tương ứng.
Lịch sử tiến hóa từ classic BPF đến extended BPF đa năng
Công nghệ BPF ban đầu (classic BPF hay cBPF) sinh ra nhằm tăng tốc độ lọc gói tin mạng cho tiện ích dòng lệnh tcpdump với hai thanh ghi 32-bit cùng vùng nhớ đệm nhỏ. Từ phiên bản nhân Linux 3.18 trở đi, eBPF được mở rộng lên không gian 64-bit, bổ sung hệ thống thanh ghi phong phú, hỗ trợ gọi hàm trợ giúp (Helper Functions) và gắn kết vào toàn bộ mọi ngóc ngách của hệ điều hành, biến eBPF là gì thành nền tảng quan sát toàn diện.
Kiến trúc máy ảo in-kernel và tập lệnh RISC 64-bit
Kiến trúc máy ảo eBPF được thiết kế bám sát các tập lệnh phần cứng RISC hiện đại, cung cấp 11 thanh ghi 64-bit đa năng từ r0 đến r10. Trong đó, r0 chứa giá trị trả về, r1–r5 truyền tham số cho hàm helper, r6–r9 lưu trữ dữ liệu tạm, và r10 là con trỏ ngăn xếp chỉ đọc 512-byte. Trình biên dịch tức thời (JIT Compiler) trong kernel trực tiếp chuyển đổi tập lệnh BPF bytecode thành mã máy native tương ứng với phần cứng (x86_64, ARM64), giúp eBPF là gì đạt tốc độ thực thi tiệm cận mã nguồn gốc.
Hệ sinh thái hook points phong phú từ kernel đến user space
Sức mạnh vượt trội của eBPF là gì nằm ở mạng lưới các điểm neo (Hook Points) đa dạng trên toàn bộ chu trình xử lý của hệ điều hành. Ở tầng mạng, hook XDP cho phép xử lý gói tin ngay tại card mạng, khẳng định tính toàn năng của eBPF là gì. Tracepoints là các điểm tĩnh nhúng cố định trong mã kernel, mang lại tính ổn định giao diện nhị phân (ABI Stability) tuyệt đối.
Bảng so sánh tổng quan nhanh & sơ đồ luồng
Để đánh giá chính xác vị thế kỹ thuật của eBPF là gì so với các công nghệ theo dõi truyền thống trên Linux, việc đặt các giải pháp lên bàn cân đối chiếu là điều cần thiết. Mỗi phương pháp đều có sự đánh đổi rõ ràng giữa chi phí tài nguyên, độ chi tiết dữ liệu và mức độ an toàn đối với hệ thống đang vận hành.
Bảng đối chiếu dưới đây phân tích 6 phương pháp giám sát phổ biến trên hệ điều hành Linux dựa trên các tiêu chí cốt lõi của môi trường sản xuất:
| Giải pháp công nghệ | Mức độ overhead | Độ chi tiết dữ liệu | Độ an toàn hệ thống | Khả năng chạy production |
|---|---|---|---|---|
| strace / ptrace | Cực cao (gây chậm 50% – 80%) | Rất cao (từng syscall) | Cao (không sập kernel) | Hoàn toàn không phù hợp |
| Kernel Module (LKM) | Rất thấp (< 1% CPU) | Không giới hạn | Rất thấp (dễ Kernel Panic) | Rủi ro vận hành rất cao |
| /proc và /sys polling | Thấp đến trung bình | Rất thấp (số liệu tổng hợp) | Rất cao (chỉ đọc) | Phù hợp số liệu cơ bản |
| SystemTap | Trung bình | Rất cao | Trung bình (phụ thuộc biên dịch) | Hạn chế trên hạ tầng mới |
| perf Linux subsystem | Thấp (< 3% CPU) | Cao (phân tích CPU/Cache) | Cao (tích hợp chuẩn kernel) | Rất tốt cho profiling định kỳ |
| eBPF Runtime Engine | Cực thấp (1% – 2% CPU) | Rất cao (thời gian thực theo sự kiện) | Tuyệt đối cao (nhờ Verifier) | Chuẩn mực tối ưu hiện nay |
Nhìn vào bảng so sánh tổng hợp, chúng ta có thể thấy rõ lý do vì sao eBPF là gì lại trở thành bước nhảy vọt mang tính cách mạng. Đây chính là bản sắc công nghệ của eBPF là gì trong thế giới Linux hiện đại. Nó dung hòa hoàn hảo hai yếu tố tưởng chừng đối nghịch: sở hữu quyền lực thu thập dữ liệu sâu sắc ngang ngửa với mô-đun kernel, nhưng lại bảo đảm an toàn tuyệt đối và duy trì mức tiêu thụ tài nguyên siêu nhẹ tương đương với các cơ chế đọc số liệu định kỳ.
Điểm khác biệt lớn nhất: so sánh eBPF và kernel module
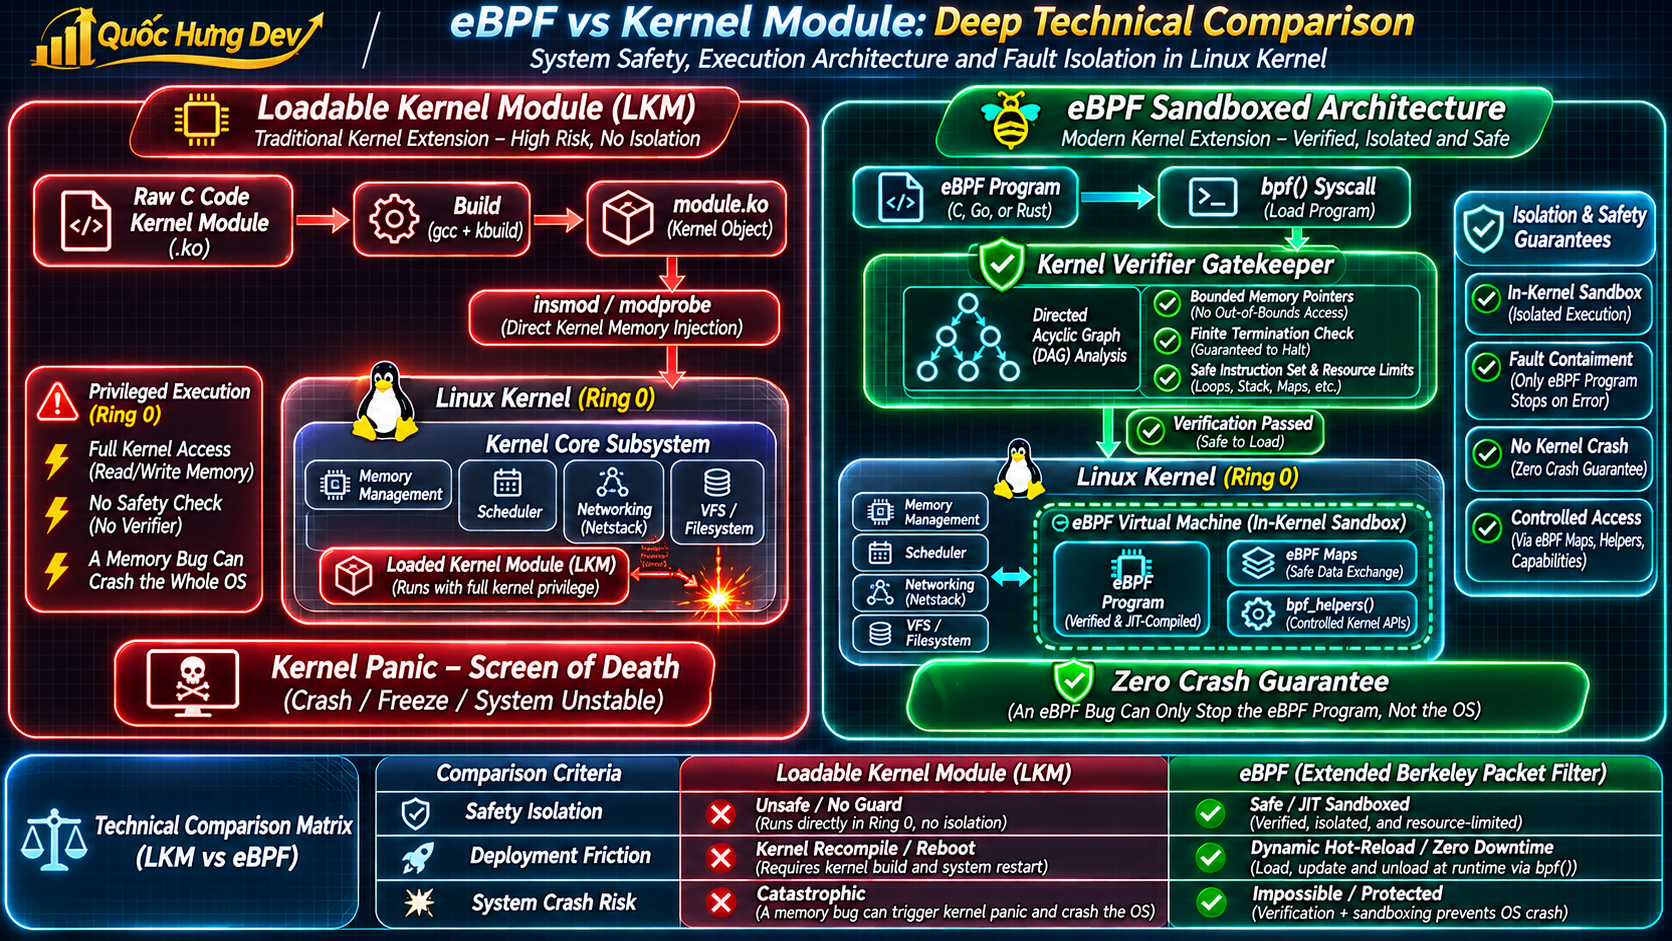
Khi tìm hiểu chuyên sâu về kiến trúc Linux, nhiều kỹ sư thường đặt ra câu hỏi đối chiếu giữa so sánh ebpf và kernel module: Tại sao chúng ta cần một máy ảo phức tạp khi các mô-đun hạt nhân truyền thống (Loadable Kernel Modules – LKM) đã tồn tại từ lâu và cho phép can thiệp vào nhân hệ điều hành? Câu trả lời nằm ở ba khía cạnh sống còn: tính an toàn vận hành, khả năng di động đa phiên bản và chu kỳ phát triển phần mềm, giải thích vì sao eBPF là gì lại được ưu tiên lựa chọn.
Ranh giới giữa sự an toàn tuyệt đối và nguy cơ sụp đổ hệ thống
Điểm khác biệt cốt lõi nhất khi thực hiện so sánh ebpf và kernel module nằm ở cơ chế kiểm soát rủi ro bộ nhớ. Khi nạp mô-đun LKM bằng lệnh insmod, mã nguồn chạy với toàn bộ đặc quyền Ring 0 mà không có kiểm duyệt trước. Ngược lại, với eBPF, không dòng lệnh nào được chạm vào nhân nếu chưa vượt qua bộ kiểm chứng (Kernel Verifier). Cơ chế bảo vệ này giúp eBPF là gì trở thành giải pháp lý tưởng cho hạ tầng quan trọng.
Tính di động CO-RE và chuẩn định dạng kiểu dữ liệu BTF
Khi nâng cấp bản vá kernel, các cấu trúc dữ liệu nội bộ như task_struct thay đổi độ lệch ô nhớ, khiến mô-đun cũ không thể nạp được và buộc phải biên dịch lại qua DKMS. Đối chiếu này càng làm rõ lợi ích khi so sánh ebpf và kernel module trong bảo trì dài hạn. Tệp nhị phân BTF nhúng sẵn trong nhân chứa siêu dữ liệu mô tả cấu trúc của kernel, cho phép thư viện nạp tự động điều chỉnh địa chỉ trường dữ liệu một cách hoàn hảo, khẳng định ưu thế vượt bậc của eBPF là gì.
Khả năng nạp gỡ nóng và chu kỳ phát triển ứng dụng
Yếu tố thứ ba khi phân tích so sánh ebpf và kernel module là tốc độ phát triển và triển khai giải pháp. Vòng đời phát triển phần mềm được rút ngắn từ hàng tháng xuống vài giờ, cho thấy bản chất linh hoạt của eBPF là gì trong môi trường Agile. Việc phát triển mô-đun kernel đòi hỏi quy trình gỡ lỗi phức tạp và mỗi lần cập nhật phiên bản vá lỗi thường đòi hỏi dừng dịch vụ hoặc khởi động lại toàn bộ máy chủ.
Cơ chế bảo mật kernel verifier và quy trình kiểm chứng bytecode
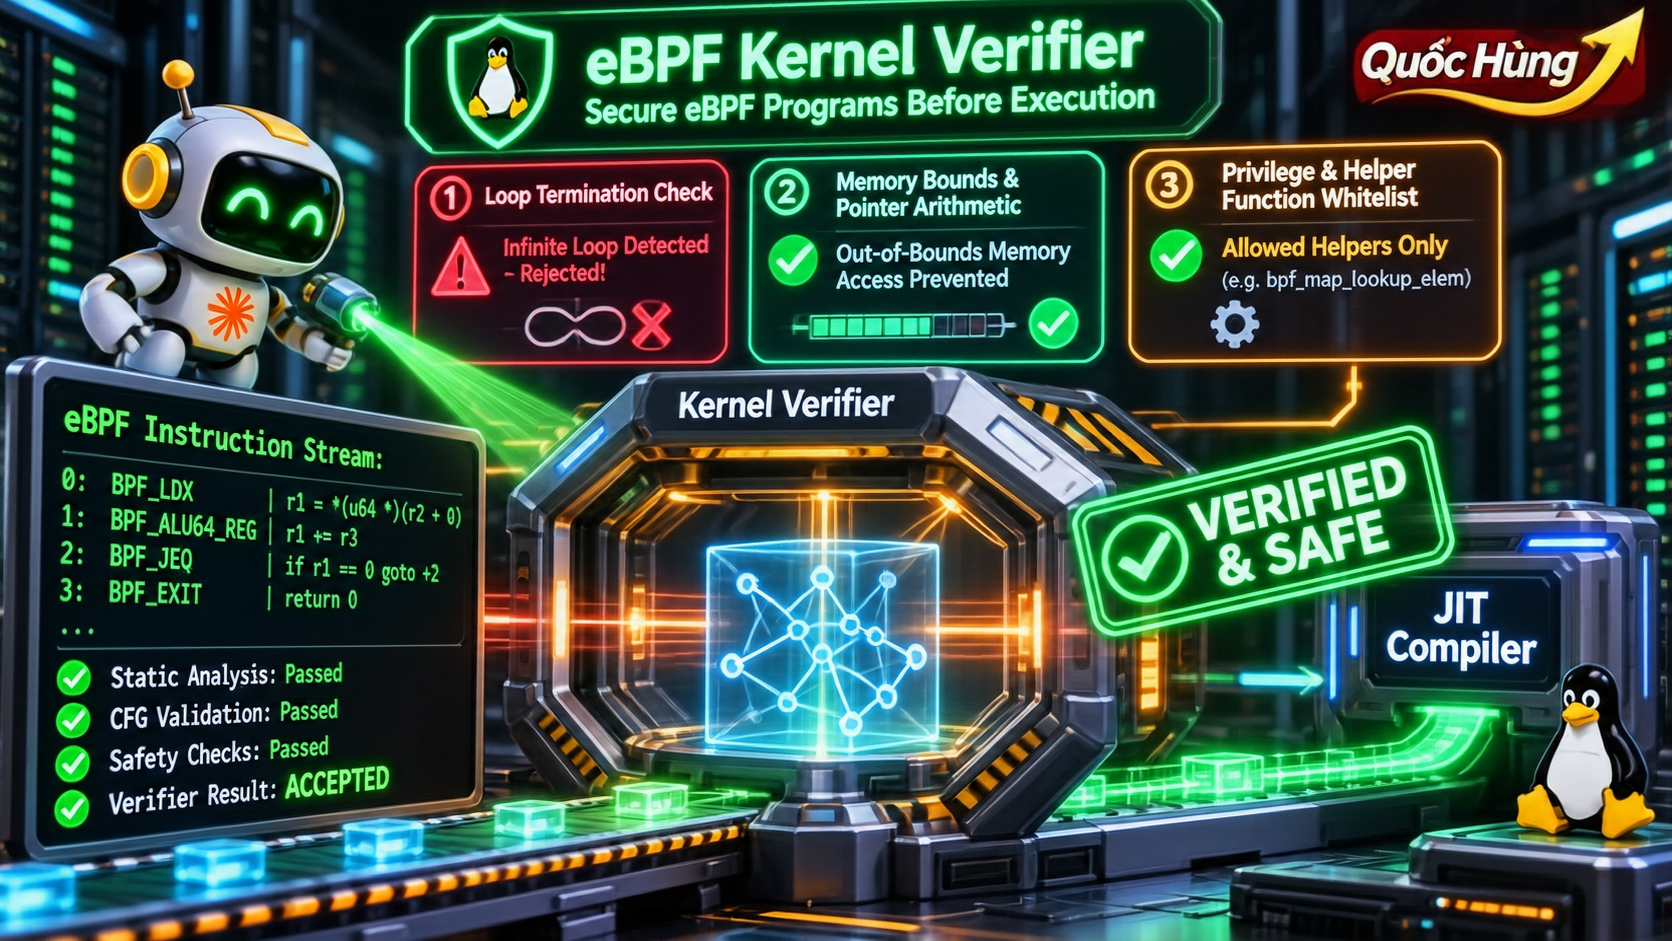
Bí mật lớn nhất làm nên sự thành công kỳ diệu của eBPF là gì không nằm ở trình biên dịch hay khả năng bắt gói tin tốc độ cao, mà nằm ở cơ chế bảo mật kernel verifier. Trước khi bất kỳ byte mã máy nào được nạp vào không gian thực thi, bộ kiểm chứng tĩnh này sẽ thực hiện một cuộc kiểm tra phân tích đa tầng vô cùng khắt khe, minh chứng cho độ an toàn của eBPF là gì.
Thuật toán phân tích đồ thị có hướng và duyệt nhánh thực thi
Khi chương trình eBPF được chuyển vào nhân qua lệnh gọi hệ thống bpf() với cờ BPF_PROG_LOAD, cơ chế bảo mật kernel verifier lập tức xây dựng đồ thị luồng điều khiển có hướng không chu trình (Directed Acyclic Graph – DAG). Bộ kiểm chứng duyệt từ chỉ lệnh đầu tiên và phân tích từng nhánh rẽ điều kiện để bảo đảm mọi đường dẫn thực thi khả dĩ đều dẫn tới chỉ lệnh thoát hợp lệ (BPF_EXIT). Nhờ đó, người vận hành hiểu rõ eBPF là gì không chỉ qua tính năng mà qua sự an toàn nội tại. Ở các bản kernel hiện đại, thuật toán phân tích giới hạn nhánh (Bounded Loops) chứng minh toán học rằng vòng lặp chắc chắn sẽ kết thúc sau số vòng lặp hữu hạn, giúp eBPF là gì đáp ứng trọn vẹn yêu cầu giám sát cấp doanh nghiệp.
Kiểm soát an toàn bộ nhớ và ngăn chặn rò rỉ dữ liệu
Nhiệm vụ trọng yếu thứ hai của cơ chế bảo mật kernel verifier là thiết lập ranh giới an toàn tuyệt đối cho các thao tác đọc và ghi bộ nhớ. Đây là yếu tố cốt lõi giúp eBPF là gì ngăn chặn mọi hành vi truy cập trái phép. Trình kiểm chứng từ chối ngay lập tức nếu phát hiện chương trình thực hiện phép toán tùy tiện trên con trỏ để truy cập ra ngoài vùng được cấp phát (Out-of-bounds Access), củng cố vị thế của eBPF là gì trong an ninh mạng.
Nguyên tắc đặc quyền tối thiểu với các phân quyền chuyên biệt
Về mặt quản trị hệ thống, việc nạp và thực thi mã eBPF từng là đặc quyền duy nhất của quyền tối thượng CAP_SYS_ADMIN (tương đương quyền root). Nhằm đáp ứng nguyên tắc đặc quyền tối thiểu, nhân Linux hiện đại đã phân rã thành các quyền độc lập: quyền CAP_BPF để quản lý chương trình eBPF, quyền CAP_PERFMON cho các tác vụ thu thập số liệu hiệu năng qua kprobes/tracepoints, và quyền CAP_NET_ADMIN cho can thiệp mạng như XDP. Nhờ cấu trúc phân quyền tinh gọn này, các tiến trình thu thập số liệu có thể hoạt động hoàn toàn biệt lập, chứng minh tính bảo mật chặt chẽ của eBPF là gì và hoàn thiện cơ chế bảo mật kernel verifier.
Kiến trúc bộ nhớ chia sẻ qua eBPF maps và ring buffer
Một câu hỏi kỹ thuật thường gặp khi tiếp cận eBPF là gì là: Làm thế nào một chương trình chạy trong nhân Linux có thể truyền tải hàng triệu sự kiện đo đạc được lên cho các ứng dụng ở không gian người dùng như Prometheus hay Grafana mà không làm tắc nghẽn đường truyền? Câu trả lời nằm ở kiến trúc cấu trúc dữ liệu chia sẻ được gọi là eBPF Maps và cơ chế truyền phát dữ liệu hiện đại Ring Buffer, hai thành phần bổ trợ đắc lực tạo nên sức mạnh của eBPF là gì.
Phân loại các cấu trúc eBPF maps thông dụng
Tùy thuộc vào yêu cầu nghiệp vụ, nhân Linux cung cấp nhiều chủng loại Map chuyên biệt giúp người dùng khai thác tối đa eBPF là gì. Cấu trúc BPF_MAP_TYPE_HASH là bảng băm tổng quát phù hợp cho các bài toán tra cứu theo khóa tùy ý, ví dụ lưu trữ độ trễ của từng tiến trình (PID) hoặc địa chỉ IP mạng. Cấu trúc BPF_MAP_TYPE_ARRAY tối ưu hóa cho mảng kích thước cố định và chỉ mục số nguyên liên tục, mang lại tốc độ truy xuất cực đại. Đối với hệ thống có lưu lượng sự kiện biến động lớn, BPF_MAP_TYPE_LRU_HASH tự động giải phóng các phần tử ít dùng nhất khi bộ nhớ chạm ngưỡng giới hạn, giúp hệ thống không bao giờ bị lỗi tràn bộ nhớ, nâng cao độ tin cậy của eBPF là gì.
Cơ chế per-CPU maps và tối ưu hóa xử lý đa lõi
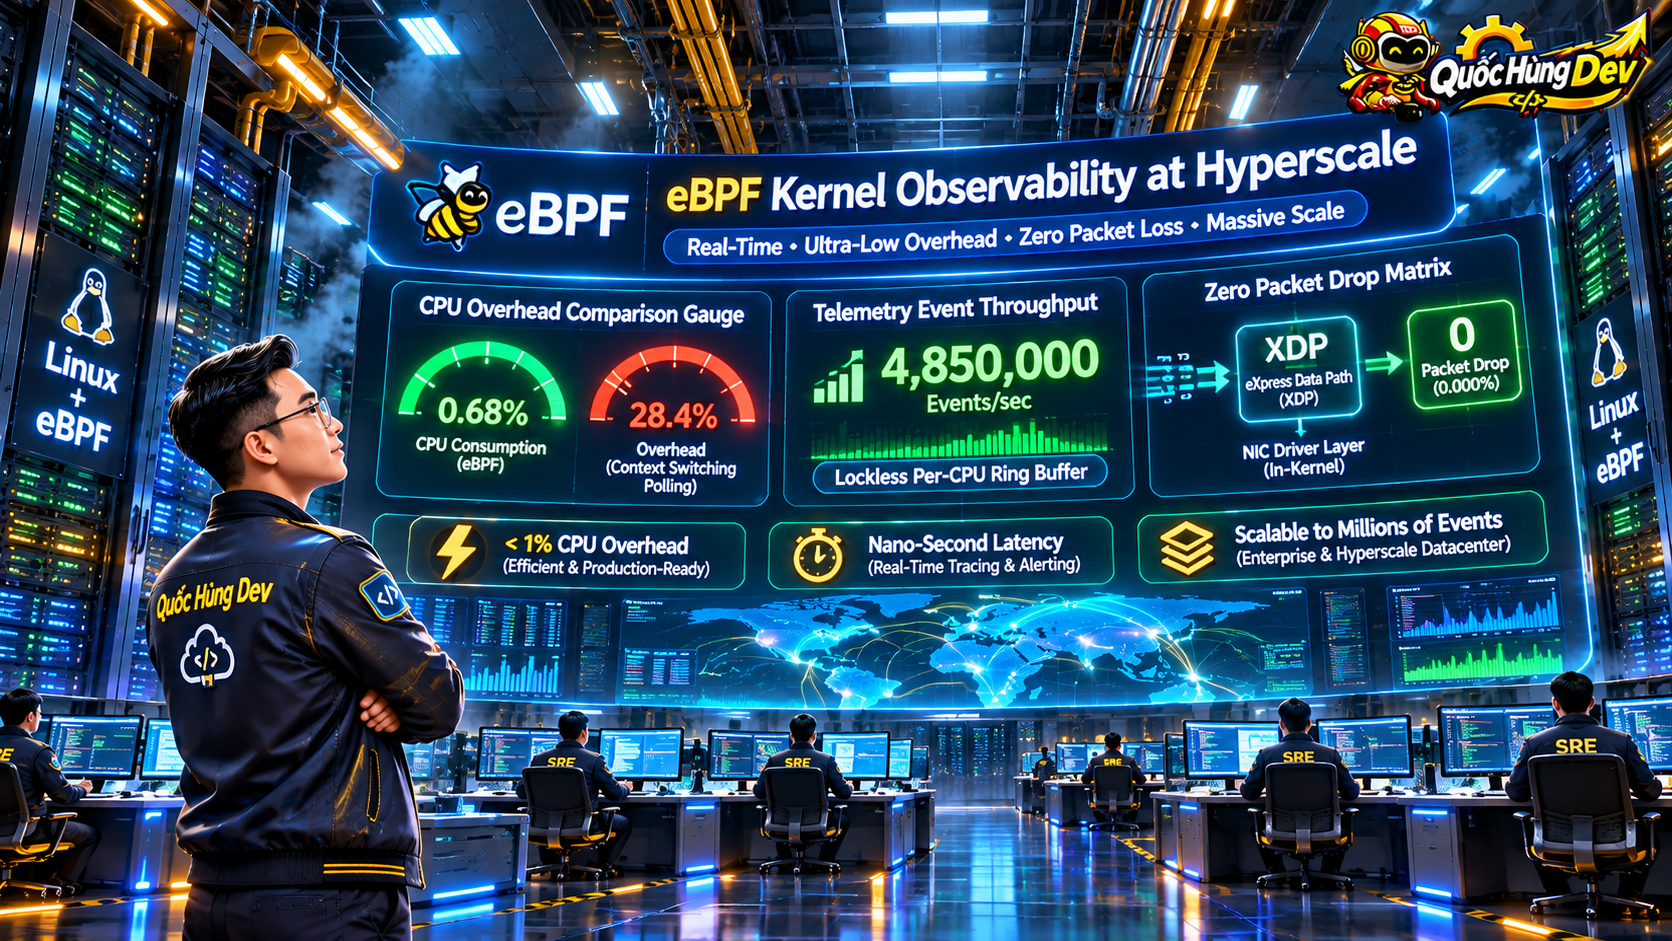
Đây là bài toán mà eBPF là gì xử lý một cách triệt để. Để giải quyết triệt để nút thắt này, eBPF cung cấp các cấu trúc per-CPU Maps như BPF_MAP_TYPE_PERCPU_HASH và BPF_MAP_TYPE_PERCPU_ARRAY. Khi ứng dụng ở không gian người dùng đọc số liệu, thư viện sẽ tự động duyệt qua từng CPU và thực hiện phép cộng dồn tổng hợp, mang lại thông lượng xử lý hàng chục triệu sự kiện mỗi giây với độ trễ gần như bằng không, thể hiện sức mạnh vượt bậc của eBPF là gì.
Đột phá hiệu năng của ring buffer so với perf buffer truyền thống
Trước đây, phương thức chủ đạo để đẩy luồng sự kiện từ nhân Linux lên không gian người dùng là sử dụng Perf Buffer (BPF_MAP_TYPE_PERF_EVENT_ARRAY). Khắc phục điểm yếu này là bước tiến quan trọng của eBPF là gì. Từ nhân Linux 5.8 trở đi, cấu trúc BPF_MAP_TYPE_RINGBUF (BPF Ring Buffer) ra đời để khắc phục hoàn toàn các hạn chế trên. Đồng thời, Ring Buffer tích hợp sẵn cơ chế thông báo thông minh qua epoll, giúp ứng dụng user space chỉ thức giấc khi có dữ liệu mới, tiết kiệm đáng kể tài nguyên CPU trong quá trình giám sát liên tục, khẳng định vai trò trụ cột của eBPF là gì.
Hướng dẫn sử dụng bpftrace và bộ công cụ BCC trong thực chiến
Sau khi đã làm chủ các khái niệm lý thuyết cốt lõi, bước tiếp theo là chuyển đổi kiến thức thành kỹ năng thực hành thông qua hướng dẫn sử dụng bpftrace và bộ công cụ mã nguồn mở BCC (BPF Compiler Collection). Đây là hai công cụ thực chiến mạnh mẽ nhất giúp các kỹ sư hệ thống có thể tiến hành chẩn đoán sự cố máy chủ ngay lập tức mà không cần viết hàng trăm dòng mã nguồn C phức tạp, đưa giá trị của eBPF là gì vào công việc hàng ngày.
Cài đặt môi trường và các gói phụ thuộc trên Linux
Để bắt đầu thực hành hướng dẫn sử dụng bpftrace trên các bản phân phối Linux phổ biến như Ubuntu hoặc Debian, bạn có thể cài đặt trực tiếp thông qua trình quản lý gói hệ thống với các câu lệnh chuẩn sau:
# Cập nhật danh mục gói phần mềm hệ thống
sudo apt-get update

# Cài đặt công cụ bpftrace, bpfcc-tools và gói header của nhân Linux hiện hành
sudo apt-get install -y bpftrace bpfcc-tools linux-headers-$(uname -r)

# Kiểm tra phiên bản bpftrace đã cài đặt thành công
bpftrace --version
Trên các hệ điều hành họ Red Hat như RHEL, CentOS Stream, Rocky Linux hoặc AlmaLinux, bạn có thể kích hoạt kho lưu trữ và cài đặt tương tự bằng lệnh sudo dnf install -y bpftrace bcc-tools kernel-devel-$(uname -r). Sau khi hoàn tất cài đặt, bạn đã sẵn sàng sở hữu một công cụ truy vết hệ thống với sức mạnh tương đương các giải pháp giám sát thương mại đắt đỏ, biến kiến thức eBPF là gì thành năng lực thực thi cụ thể.
Kịch bản one-liner đo lường độ trễ đọc ghi đĩa và syscall
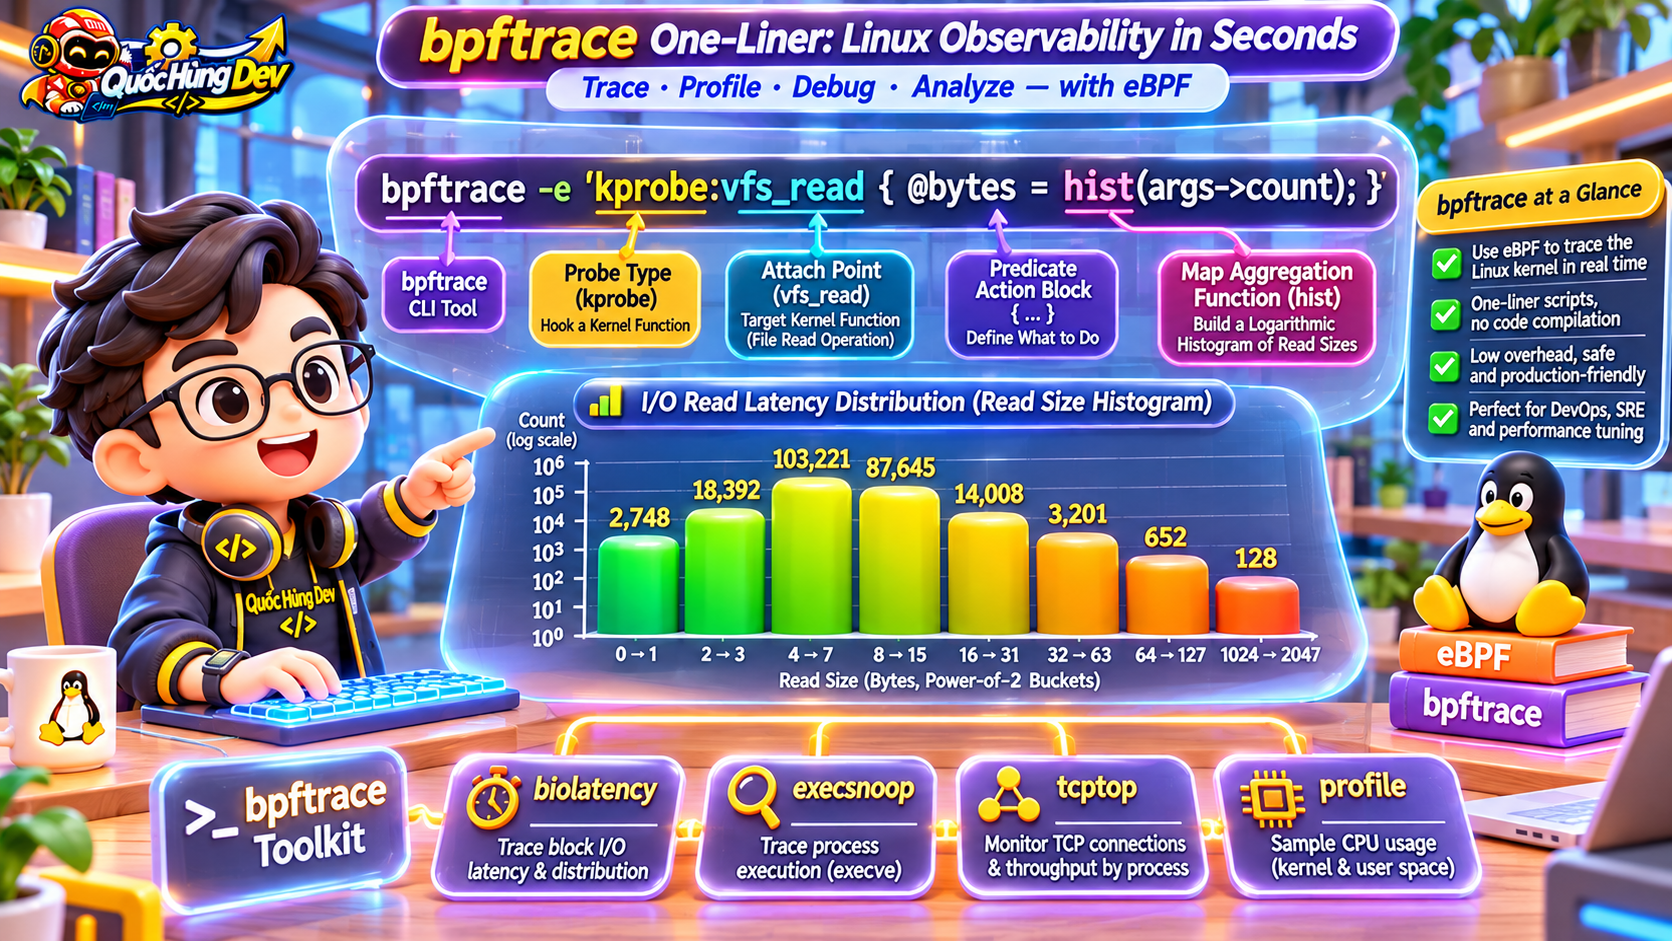
Một trong những điểm hấp dẫn nhất trong hướng dẫn sử dụng bpftrace là khả năng viết các câu lệnh ngắn một dòng (One-liners) để giải quyết các bài toán hóc búa nhất. Ngôn ngữ của bpftrace lấy cảm hứng từ ngôn ngữ xử lý văn bản awk và hệ thống DTrace trứ danh, cung cấp cú pháp khai báo cực kỳ trực quan, giúp các kỹ sư nhanh chóng ứng dụng eBPF là gì vào vận hành thực tế. Dưới đây là kịch bản kinh điển giúp bạn đo lường chính xác phân phối thời gian xử lý lệnh gọi hệ thống đọc dữ liệu sys_enter_read và sys_exit_read của một tiến trình dịch vụ cụ thể, sau đó tự động xuất ra một biểu đồ tần suất (Histogram) trực quan:
# Đo lường độ trễ của lệnh gọi hệ thống read() theo microsecond và vẽ biểu đồ tần suất
sudo bpftrace -e '
tracepoint:syscalls:sys_enter_read {
    @start[tid] = nsecs;
}
tracepoint:syscalls:sys_exit_read /@start[tid]/
{
    $duration_us = (nsecs - @start[tid]) / 1000;
    @read_latency_us = hist($duration_us);
    delete(@start[tid]);
}
interval:s:10 {
    exit();
}'
Khi thực thi đoạn lệnh trên, bpftrace sẽ âm thầm gắn móc vào hai điểm tracepoint chuẩn của nhân Linux. Mỗi khi có lệnh gọi read(), thời điểm bắt đầu được ghi lại theo ID luồng (tid). Khi thao tác đọc hoàn tất, độ trễ được tính bằng cách lấy thời gian kết thúc trừ thời điểm bắt đầu và đưa vào hàm băm thống kê hist(). Sau 10 giây, công cụ sẽ tự động xuất ra một biểu đồ ASCII sắc nét, giúp phát hiện các trường hợp đuôi độ trễ dài (Tail Latency) lên tới hàng chục mili-giây, thể hiện sự chính xác của eBPF là gì.
Ứng dụng các công cụ dựng sẵn từ hệ sinh thái BCC
Nếu bạn không muốn tự viết kịch bản từ đầu, bộ công cụ BCC cung cấp hơn 70 tiện ích dòng lệnh được các chuyên gia hiệu năng hàng đầu thế giới biên soạn sẵn, có thể sử dụng ngay lập tức trên máy chủ sản xuất, minh chứng cho tính sẵn sàng cao của eBPF là gì. Tiện ích execsnoop-bpfcc giúp bạn bắt trọn mọi tiến trình vừa được sinh ra trong hệ thống thông qua lệnh gọi execve, hiển thị rõ ràng đường dẫn lệnh, tham số thực thi và mã trả về. Tiện ích opensnoop-bpfcc theo dõi mọi thao tác mở tệp tin theo thời gian thực, giúp bạn xác định tệp cấu hình nào đang bị ứng dụng đọc liên tục gây nghẽn ổ đĩa. Tiện ích biolatency-bpfcc đo lường độ trễ của tầng thiết bị lưu trữ khối (Block I/O Device), chỉ ra chính xác ổ đĩa cứng đang bị quá tải, cho thấy tính ứng dụng đa dạng của eBPF là gì trong hướng dẫn sử dụng bpftrace.
Tình huống ứng dụng thực tế theo phòng ban: DevOps, SRE và an ninh
Sự trưởng thành vượt bậc của hệ sinh thái phần mềm mã nguồn mở đã đưa eBPF là gì vượt ra khỏi phòng thí nghiệm của các kỹ sư hạt nhân để trở thành vũ khí sắc bén cho nhiều bộ phận kỹ thuật khác nhau trong các tổ chức công nghệ hiện đại. Tùy thuộc vào đặc thù nghiệp vụ, mỗi phòng ban đều có thể khai thác sức mạnh của công nghệ này để giải quyết các nút thắt then chốt trong vận hành, biến eBPF là gì thành giải pháp thực tế.
Kỹ sư SRE chẩn đoán độ trễ mạng và phân tích tail latency
Lúc này, hiểu được eBPF là gì giúp định vị điểm lỗi tức thì. Bằng cách gắn móc eBPF vào hàm xử lý giao thức TCP trong nhân Linux như tcp_retransmit_skb và tcp_drop, kỹ sư SRE có thể lập tức phát hiện các gói tin bị truyền lại (Retransmission) hoặc bị hủy bỏ do hàng đợi bộ đệm socket bị đầy. Kết hợp với một hệ sinh thái monitoring và logging toàn diện và các công cụ giám sát tiến trình trực quan như giám sát hệ thống Linux với bottom, đội ngũ có thể khoanh vùng chính xác điểm nghẽn hạ tầng chỉ trong vài giây thay vì phải rà soát thủ công hàng gigabyte tệp nhật ký ứng dụng, phát huy tối đa lợi thế của eBPF là gì.
Chuyên gia bảo mật phát hiện hành vi xâm nhập thời gian thực
Do đó, việc ứng dụng eBPF là gì mang lại bước đột phá mới. Khi kẻ tấn công cố gắng mở một kết nối shell trái phép từ bên trong một container đang chạy trên cụm Kubernetes, hoặc can thiệp vào các tệp tin hệ thống nhạy cảm như /etc/shadow thay vì chỉ đơn thuần dựa vào việc theo dõi thay đổi file trên Linux bằng inotifywait ở tầng ứng dụng, eBPF sẽ lập tức phát hiện sự kiện ở tầng syscall. Thậm chí thông qua cơ chế LSM BPF (Linux Security Module), hệ thống có thể chủ động chặn đứng (Enforce & Block) hành vi độc hại ngay trước khi câu lệnh được thực thi, bảo vệ an toàn tuyệt đối cho toàn bộ hạ tầng đám mây nhờ năng lực của eBPF là gì.
Đội ngũ kiến trúc hạ tầng tăng tốc mạng và cân bằng tải với XDP
Ở tầng mạng hạ tầng (Platform Engineering), việc các cụm Kubernetes quy mô lớn vận hành hàng nghìn dịch vụ thường làm bão hòa bảng quy tắc định tuyến của iptables hoặc IPVS do cơ chế dò tìm tuần tự gây tiêu tốn tài nguyên CPU nghiêm trọng. Sự ra đời của nền tảng mạng Cilium CNI dựa trên eBPF đã tạo nên cuộc cách mạng trong kiến trúc mạng dịch vụ, chứng minh giá trị to lớn của eBPF là gì. Gói tin được chuyển tiếp trực tiếp giữa các container mà không cần phải đi qua toàn bộ ngăn xếp mạng TCP/IP cồng kềnh của hệ điều hành, giúp giảm độ trễ mạng tới 40% và giải phóng hàng chục lõi CPU dành cho việc xử lý logic nghiệp vụ kinh doanh của doanh nghiệp, khẳng định vị thế dẫn đầu của eBPF là gì.
Chi phí thực tế & tối ưu tài nguyên giám sát kernel
Mặc dù công nghệ mang lại tiềm năng vượt trội, một câu hỏi quan trọng mà các nhà quản lý kỹ thuật bắt buộc phải cân nhắc là: Chi phí tài nguyên thực tế của việc triển khai eBPF là gì và làm thế nào để tối ưu tài nguyên giám sát kernel nhằm tránh tình trạng công cụ theo dõi lại trở thành gánh nặng làm chậm máy chủ sản xuất?
Đánh giá chi phí overhead CPU và bộ nhớ RAM
Đây là con số ấn tượng khi so sánh với mức suy giảm hiệu năng từ 50% đến 80% nếu bạn sử dụng strace trên các ứng dụng chịu tải cao, làm rõ tính kinh tế của eBPF là gì. Trong hầu hết các điều kiện vận hành tiêu chuẩn, chi phí tiêu hao của một chương trình eBPF được thiết kế đúng quy chuẩn chỉ dao động trong khoảng từ 0.5% đến 2% tổng năng lực xử lý CPU của máy chủ.
Bốn kỹ thuật tối ưu tài nguyên giám sát kernel chuyên sâu
Để đạt được mục tiêu tối ưu tài nguyên giám sát kernel ở mức độ hoàn hảo nhất, các chuyên gia vận hành hạ tầng giàu kinh nghiệm luôn áp dụng triệt để 4 nguyên tắc kỹ thuật sau, giúp khai thác trọn vẹn sức mạnh của eBPF là gì. Điều này giúp giảm tới 99% lượng dữ liệu cần truyền tải qua bus bộ nhớ của hệ thống, hỗ trợ đắc lực cho mục tiêu tối ưu tài nguyên giám sát kernel.
Nguyên tắc thứ tư là chuyển đổi toàn bộ đường ống truyền phát sự kiện sang cấu trúc Ring Buffer hiện đại để loại bỏ việc sao chép bộ nhớ kép và ngăn ngừa tình trạng rơi gói tin khi xảy ra bùng nổ dữ liệu cục bộ, hoàn thiện giải pháp tối ưu tài nguyên giám sát kernel.
Tích hợp đường ống xuất dữ liệu sang hệ thống giám sát tập trung
Ứng dụng ở tầng không gian người dùng (thường được viết bằng ngôn ngữ Go hoặc Rust kết hợp thư viện cilium/ebpf) sẽ đảm nhận nhiệm vụ định kỳ đọc dữ liệu từ các cấu trúc Map, tính toán chênh lệch tốc độ và xuất ra các số liệu theo chuẩn OpenTelemetry hoặc endpoint của Prometheus. Đây là bước hiện thực hóa giá trị của eBPF là gì cho đội ngũ vận hành. Từ các số liệu thô của kernel, các kỹ sư có thể xây dựng các bảng điều khiển Grafana chuyên nghiệp, hiển thị trực quan biểu đồ nhiệt (Heatmaps) phân phối độ trễ đĩa, bản đồ kết nối mạng giữa các dịch vụ trong thời gian thực và các đường cong bão hòa tài nguyên hệ thống, giúp biến các dữ liệu kỹ thuật trừu tượng của hạt nhân Linux thành thông tin chi tiết hỗ trợ đắc lực cho các quyết định kinh doanh và kỹ thuật, khẳng định sức mạnh tổng thể của eBPF là gì.
Ma trận ra quyết định theo quy mô hệ thống
Việc áp dụng công nghệ eBPF không nên triển khai một cách máy móc mà cần bám sát ma trận năng lực và nhu cầu thực tế của từng giai đoạn phát triển để tối đa hóa hiệu quả mà eBPF là gì mang lại: Mỗi tổ chức đều có quy mô hạ tầng, cấu trúc dịch vụ và nguồn lực nhân sự hoàn toàn khác nhau.
Máy chủ đơn lẻ và VPS cấu hình tinh gọn
Lựa chọn tối ưu là sử dụng các công cụ dòng lệnh có sẵn như BCC tools và các kịch bản bpftrace tùy biến khi xảy ra sự cố cần điều tra nhanh, kết hợp với các giải pháp quản trị VPS tự động để giữ cho máy chủ luôn gọn nhẹ và tiết kiệm tối đa chi phí bản quyền.
Cụm máy chủ dịch vụ tầm trung
Phù hợp cho các công ty công nghệ vận hành từ 5 đến 30 máy chủ ứng dụng hoặc máy chủ cơ sở dữ liệu. Khuyến nghị triển khai các tác tử thu thập dữ liệu eBPF chuyên dụng như Vector, Pixie hoặc các Prometheus eBPF exporters gọn nhẹ, tự động chuyển tiếp số liệu mạng và độ trễ syscall về trung tâm giám sát tập trung mà không đòi hỏi đội ngũ phải tự lập trình nhân kernel.
Hạ tầng phân tán và cụm Kubernetes doanh nghiệp
Tiêu chuẩn vàng là áp dụng giải pháp Cilium CNI cho toàn bộ tầng mạng và chính sách dịch vụ, kết hợp Tetragon cho kiểm soát an ninh runtime, và triển khai Hubble để quan sát toàn diện luồng giao tiếp giữa các webhook và API theo chuẩn kiến trúc hướng sự kiện hiện đại.
Checklist an toàn & lưu ý tuân thủ khi triển khai eBPF
Cảnh báo an ninh hạ tầng: Mặc dù công nghệ sở hữu cơ chế kiểm chứng tĩnh vô cùng nghiêm ngặt, việc gắn móc vào các hàm nội bộ không ổn định của hạt nhân Linux hoặc thiết lập kích thước các cấu trúc bộ nhớ Map vượt quá dung lượng RAM thực tế vẫn có thể gây tiêu hao tài nguyên CPU bất thường và kích hoạt tiến trình OOM-Killer tiêu diệt các dịch vụ quan trọng. Luôn kiểm thử tải trên môi trường giả lập trước khi nạp mã lên cụm máy chủ sản xuất.
Trước khi chính thức triển khai bất kỳ giải pháp hoặc công cụ giám sát nào sử dụng nền tảng eBPF vào môi trường máy chủ sản xuất, đội ngũ kỹ sư hệ thống cần nghiêm túc rà soát 7 tiêu chí trong danh mục kiểm tra sau, đảm bảo ứng dụng eBPF là gì đạt hiệu quả cao nhất:
Tiêu chí 1: Đảm bảo phiên bản nhân Linux của máy chủ hỗ trợ đầy đủ các tính năng hiện đại (khuyến nghị sử dụng các bản phát hành hỗ trợ dài hạn LTS từ nhân 5.8 trở lên để khai thác trọn vẹn sức mạnh của BPF Ring Buffer và hệ thống phân quyền tinh gọn).
Tiêu chí 2: Xác nhận cấu hình hạt nhân đã bật cờ thông tin kiểu dữ liệu CONFIG_DEBUG_INFO_BTF=y nhằm bảo đảm tính tương thích di động đa phiên bản thông qua cơ chế CO-RE.
Tiêu chí 3: Thiết lập tham số hệ thống sysctl kernel.unprivileged_bpf_disabled=1 để vô hiệu hóa hoàn toàn quyền nạp mã eBPF của người dùng không có đặc quyền, ngăn ngừa các kỹ thuật tấn công leo thang quyền hạn.
Tiêu chí 4: Thẩm định chi tiết đầu ra của trình kiểm chứng (Verifier Log) trong môi trường staging với cờ chẩn đoán chi tiết (Verbose Flag) để phát hiện sớm các nguy cơ phức tạp hóa thuật toán.
Tiêu chí 5: Tính toán chính xác ngưỡng giới hạn dung lượng phần tử tối đa (max_entries) của toàn bộ các cấu trúc Map để bảo đảm không vượt quá hạn mức RAM an toàn của máy chủ.
Tiêu chí 6: Thiết lập cơ chế tự phục hồi (Graceful Fallback) để đảm bảo nếu dịch vụ eBPF bị lỗi hoặc bị dừng đột ngột, lưu lượng mạng và các tiến trình ứng dụng cốt lõi của doanh nghiệp vẫn duy trì hoạt động thông suốt.
Tiêu chí 7: Triển khai tiến trình tự giám sát (Self-monitoring) đối với chính tác tử eBPF để theo dõi sát sao tỷ lệ sự kiện bị hủy bỏ (dropped_events) và mức tiêu thụ CPU thực tế theo thời gian thực.
Câu hỏi thường gặp FAQ accordion
eBPF có thể làm sập hoặc gây lỗi kernel panic cho máy chủ Linux không?
Nhờ sự kiểm soát khắt khe của cơ chế bảo mật kernel verifier, mọi chương trình eBPF đều bị từ chối nạp nếu tồn tại bất kỳ nguy cơ tham chiếu con trỏ rỗng, truy cập bộ nhớ ngoài phạm vi cho phép hoặc rơi vào vòng lặp vô hạn. Hiểu rõ điều này giúp bạn tự tin ứng dụng eBPF là gì một cách an toàn.
eBPF khác gì so với WebAssembly khi cùng áp dụng cơ chế máy ảo sandbox?
Phân biệt này giúp định vị chính xác vai trò của eBPF là gì. Mặc dù cả hai công nghệ đều sử dụng triết lý máy ảo sandbox để thực thi mã bytecode an toàn, phạm vi hoạt động và mục tiêu thiết kế của chúng hoàn toàn khác nhau. eBPF được sinh ra và tối ưu hóa tuyệt đối để chạy trực tiếp bên trong không gian nhân của hệ điều hành Linux (Kernel Space), gắn móc vào các cấu trúc phần cứng, ngắt mạng và các lệnh gọi hệ thống với độ trễ tính bằng nano giây.
Phiên bản nhân Linux nào là điều kiện tối thiểu để triển khai eBPF hiệu quả?
Đặc biệt, phiên bản kernel 5.8 trở lên là cột mốc lý tưởng nhất nhờ việc tích hợp cấu trúc BPF Ring Buffer hiệu năng cao và phân tách các quyền hạn bảo mật độc lập như CAP_BPF và CAP_PERFMON, mang lại sự kết hợp hoàn hảo giữa hiệu năng và an toàn thông tin khi khai thác eBPF là gì.
Làm thế nào để một lập trình viên bắt đầu học và thực hành eBPF từ con số 0?
Tiếp theo, học cách viết các kịch bản one-liner đơn giản bằng ngôn ngữ bpftrace để giải quyết các bài toán đo lường thực tế. Sau khi đã nắm vững luồng hoạt động, bạn có thể tiến tới việc học thư viện libbpf kết hợp với cơ chế CO-RE bằng ngôn ngữ C, Go (qua thư viện cilium/ebpf) hoặc Rust (qua framework Aya) để xây dựng các sản phẩm phần mềm hoàn chỉnh, làm chủ công nghệ eBPF là gì từ nền tảng.
eBPF có thay thế hoàn toàn các giải pháp giám sát ứng dụng APM truyền thống không?
Trong khi các giải pháp APM truyền thống xuất sắc trong việc theo dõi luồng giao dịch nghiệp vụ kinh doanh, dấu vết phân tán (Distributed Tracing) và trải nghiệm người dùng cuối, eBPF cung cấp lớp dữ liệu gốc ở tầng sâu nhất của hệ điều hành mà không đòi hỏi phải sửa đổi mã nguồn hay cài đặt thêm thư viện phụ thuộc vào mã nguồn ứng dụng, khẳng định sức mạnh cộng hưởng của eBPF là gì.
Kết luận & định hướng công nghệ bền vững
Hành trình tìm hiểu và giải mã câu hỏi eBPF là gì cho thấy một bước chuyển dịch mang tính thế hệ trong cách các kỹ sư công nghệ quan sát, bảo vệ và điều khiển hệ điều hành Linux. Thay vì tiếp tục cam chịu sự đánh đổi nguy hiểm giữa tính an toàn của các công cụ người dùng chậm chạp và rủi ro sụp đổ hệ thống của các mô-đun kernel truyền thống, eBPF mang đến một nền tảng lập trình siêu nhẹ, tốc độ cao và được bảo vệ nghiêm ngặt bởi toán học.
Bằng cách tiếp cận từng bước có phương pháp từ các công cụ tiện ích bpftrace đến các nền tảng mạng và bảo mật chuẩn mực như Cilium và Falco, tổ chức của bạn sẽ từng bước xây dựng một hạ tầng số vững chắc, linh hoạt và sẵn sàng thích ứng với mọi thách thức công nghệ trong tương lai, đưa năng lực khai thác eBPF là gì lên một tầm cao mới.