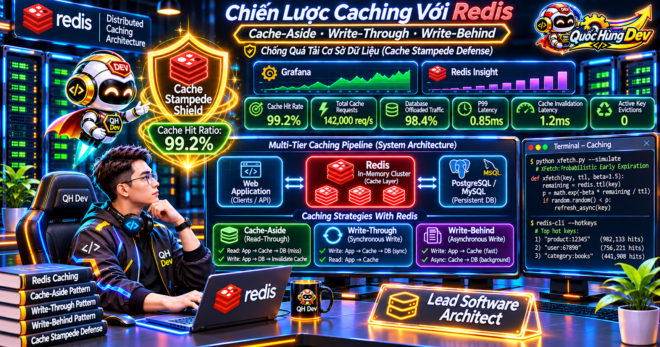
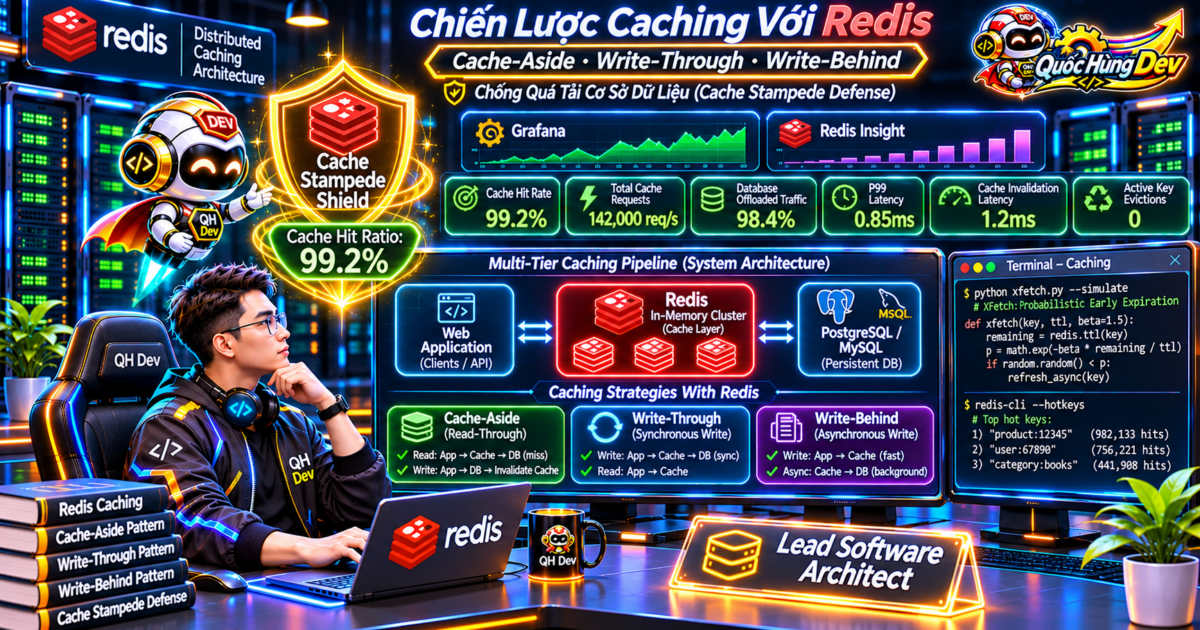
Trong các hệ thống phân tán hiện đại chịu tải cao, áp dụng đúng chiến lược caching với redis là yếu tố quyết định hiệu năng, độ ổn định và chi phí hạ tầng máy chủ của doanh nghiệp. Khi lượng người dùng đồng thời tăng vọt trong giờ cao điểm hoặc sự kiện khuyến mãi lớn, cơ sở dữ liệu quan hệ như PostgreSQL hay MySQL luôn là mắt xích đầu tiên đối mặt với nguy cơ nghẽn cổ chai I/O đĩa cứng và cạn kiệt tài nguyên kết nối. Việc thiết lập tầng đệm in-memory tốc độ cao bằng Redis giúp chuyển hướng phần lớn lưu lượng truy vấn đọc ra khỏi đĩa cứng, kéo độ trễ phản hồi từ hàng chục mili-giây xuống ngưỡng dưới một mili-giây.
Tuy nhiên, sự chênh lệch giữa một hệ thống vận hành bền bỉ và một thảm họa sập dịch vụ nằm ở tư duy kiến trúc bộ nhớ đệm chứ không chỉ ở việc cài đặt phần mềm đơn thuần. Rất nhiều đội ngũ kỹ thuật triển khai bộ nhớ đệm theo bản năng: gửi mọi truy vấn qua Redis, gọi các lệnh GET và SET tùy tiện mà không có kế hoạch giải phóng bộ nhớ, hoặc bỏ quên cấu hình thời gian sống TTL cho khóa. Hậu quả thực tế là hệ thống nhanh chóng đối mặt với tình trạng dữ liệu không đồng nhất, rò rỉ dung lượng RAM, và nghiêm trọng nhất là hiện tượng sập toàn bộ máy chủ cơ sở dữ liệu khi các khóa đệm quan trọng đồng loạt hết hạn tại cùng một thời điểm.
Bài phân tích chuyên sâu này được biên soạn dưới góc nhìn kỹ sư giải pháp, cung cấp một cẩm nang toàn diện từ nguyên lý đến thực tiễn: giải mã chi tiết 3 mô hình kinh điển gồm Cache-Aside, Write-Through và Write-Behind, hướng dẫn các phương pháp tối ưu redis cache từ tầng cấu hình nhân đến cấu trúc dữ liệu, mổ xẻ tường tận các cạm bẫy khi xử lý cache invalidation trong môi trường vi dịch vụ đa tiến trình, và chuyển giao các thuật toán phòng thủ tiên tiến nhằm chống cache stampede triệt để giúp hệ thống đứng vững trước những đợt tăng tải đột biến.
Định nghĩa bản chất công nghệ caching và nền tảng Redis in-memory
Để hiểu rõ căn nguyên vì sao một chiến lược caching với redis chuẩn mực lại có thể thay đổi hoàn toàn hiệu năng của một ứng dụng phần mềm, chúng ta cần phân tích cấu trúc phần cứng và sự phân tầng tốc độ trong kiến trúc máy tính hiện đại. Tầng bộ nhớ đệm là lớp lưu trữ dữ liệu trung gian tốc độ cao, được đặt nằm xen giữa tầng logic nghiệp vụ của ứng dụng và tầng lưu trữ bền vững. Bản chất của caching là việc đánh đổi chi phí tài nguyên phần cứng đắt đỏ hơn để đổi lấy thời gian truy xuất dữ liệu ngắn nhất có thể.
Nguyên lý lưu trữ dữ liệu trong bộ nhớ RAM và độ trễ sub-millisecond
Khoảng cách tốc độ giữa bộ nhớ truy cập ngẫu nhiên RAM và ổ cứng thể rắn SSD là ranh giới vật lý quyết định sự khác biệt giữa hai tầng công nghệ. Trong quá trình tối ưu redis cache, việc hiểu rõ khoảng cách vật lý là vô cùng cần thiết: một thao tác đọc ngẫu nhiên một khối dữ liệu từ ổ cứng SSD nhanh nhất hiện nay thường tiêu tốn từ 50 đến 150 microsecond, trong khi đó một thao tác truy vấn trực tiếp trên các ô nhớ của thanh RAM chỉ mất từ 50 đến 100 nanosecond, tức là nhanh hơn xấp xỉ một nghìn lần. Khi một truy vấn cơ sở dữ liệu quan hệ phải quét qua các bảng chỉ mục B-Tree trên đĩa cứng, thực thi các phép kết nối bảng phức tạp và sắp xếp kết quả, độ trễ thường dao động từ 5 mili-giây đến vài trăm mili-giây tùy thuộc vào độ lớn của tập dữ liệu.
Redis tận dụng triệt để lợi thế vật lý này bằng cách giữ toàn bộ tập dữ liệu trong không gian bộ nhớ chính. Khi ứng dụng gửi một lệnh truy vấn tới Redis thông qua giao thức TCP phân tán, dữ liệu được định vị ngay lập tức trong bảng băm bộ nhớ với độ phức tạp thuật toán O(1). Thời gian xử lý lệnh nội bộ bên trong tiến trình Redis thường chỉ dao động từ 10 đến 50 microsecond. Tổng độ trễ từ lúc ứng dụng gửi gói tin mạng đến khi nhận được phản hồi hoàn tất thường chỉ dưới một mili-giây, mang lại trải nghiệm mượt mà tức thì cho người dùng cuối.
Phân định ranh giới giữa caching tầng ứng dụng và caching cơ sở dữ liệu
Tầng đệm nội bộ của cơ sở dữ liệu chỉ hoạt động ở cấp độ trang đĩa. Khi có một truy vấn SQL được gửi đến, engine cơ sở dữ liệu vẫn bắt buộc phải trải qua chu kỳ phân tích cú pháp, kiểm tra quyền hạn, tối ưu hóa kế hoạch thực thi, và khóa tài nguyên logic. Sau đó, nó kiểm tra xem các trang dữ liệu chứa dòng bản ghi tương ứng có đang nằm trong bộ nhớ đệm hay không. Nếu có, nó giảm bớt được thao tác I/O đĩa cứng, nhưng toàn bộ chi phí tính toán CPU, chi phí duy trì kết nối mạng và tài nguyên xử lý logic SQL vẫn bị tiêu tốn trọn vẹn.
Ngược lại, tầng đệm ứng dụng với Redis hoạt động ở cấp độ đối tượng miền nghiệp vụ. Dữ liệu được lưu trữ trong Redis thường là các chuỗi JSON đã được chuẩn hóa đầy đủ, các mô hình đối tượng đã tính toán xong, hoặc cấu trúc phản hồi API hoàn chỉnh. Khi ứng dụng trúng bộ nhớ đệm, nó hoàn toàn bỏ qua việc gửi gói tin tới máy chủ cơ sở dữ liệu, không tiêu tốn một chu kỳ CPU nào của database, và không chiếm dụng bất kỳ kết nối nào trong pool kết nối. Nhờ đó, máy chủ cơ sở dữ liệu được giải phóng tối đa để tập trung toàn lực xử lý các giao dịch ghi và thay đổi trạng thái quan trọng.
Mô hình đơn luồng và cơ chế I/O multiplexing tối ưu trong Redis
Khi thiết kế một chiến lược caching với redis cho hệ thống tải cao, một trong những điểm kiến trúc độc đáo nhất giúp Redis đạt được thông lượng hàng trăm ngàn thao tác mỗi giây trên một nhân CPU duy nhất chính là mô hình vòng lặp sự kiện đơn luồng kết hợp cơ chế ghép kênh I/O multiplexing. Khác với các hệ thống máy chủ đa luồng truyền thống thường xuyên tiêu tốn tài nguyên cho việc chuyển đổi ngữ cảnh và quản lý khóa tranh chấp bộ nhớ, Redis xử lý các lệnh dữ liệu cốt lõi tuần tự trên một luồng chính duy nhất.
Bằng cách sử dụng các hàm gọi hệ điều hành bậc cao như epoll trên Linux, Redis có thể giám sát đồng thời hàng chục ngàn kết nối socket mở từ các máy chủ ứng dụng mà không bị chặn. Khi một socket có dữ liệu gửi đến, hệ điều hành sẽ thông báo cho vòng lặp sự kiện của Redis để đọc gói tin, phân tích lệnh và thực thi ngay lập tức. Tính chất đơn luồng này đảm bảo mọi thao tác trên cấu trúc dữ liệu của Redis đều có tính nguyên tử tự nhiên, loại bỏ hoàn toàn rủi ro xung đột dữ liệu giữa các luồng nội bộ bên trong máy chủ đệm.
Bảng so sánh tổng quan các mô hình caching và sơ đồ luồng dữ liệu
Để xây dựng một chiến lược caching với redis có hiệu quả vượt trội, kiến trúc sư hệ thống cần thấu hiểu các đánh đổi cốt lõi giữa các trường phái lưu trữ đệm khác nhau. Mỗi mô hình được thiết kế để giải quyết một mô thức đọc hoặc ghi dữ liệu đặc thù trong thực tế, từ ứng dụng web đọc nhiều cho tới các hệ thống thu thập dữ liệu cảm biến ghi liên tục.
Dưới đây là bảng đối chiếu kỹ thuật chi tiết giữa 4 mô hình bộ nhớ đệm phổ biến nhất hiện nay trong thiết kế phần mềm doanh nghiệp, giúp bạn nhanh chóng định vị giải pháp phù hợp nhất cho bài toán của mình:
| Tiêu chí đánh giá | Cache-Aside (Lazy Loading) | Write-Through | Write-Behind (Write-Back) | Refresh-Ahead |
|---|---|---|---|---|
| Bên điều phối chính | Mã ứng dụng chủ động điều phối | Tầng Cache Provider hoặc ORM Plugin | Tầng Cache làm hàng đợi đệm trung gian | Tiến trình định kỳ chạy nền tự động |
| Độ trễ đọc | Cực thấp khi trúng đệm (<1ms); Cao khi trượt | Cực thấp (<1ms) vì dữ liệu luôn có sẵn | Cực thấp (<1ms) từ tầng đệm RAM | Cực thấp (<1ms), hạn chế tối đa trượt đệm |
| Độ trễ ghi | Bằng độ trễ ghi Database + độ trễ xóa Cache | Cao nhất (bằng tổng trễ Cache + Database) | Thấp nhất (<1ms, chỉ ghi vào RAM) | Phụ thuộc vào mô hình ghi kết hợp |
| Mức độ nhất quán | Nhất quán cuối cùng (Eventual Consistency) | Nhất quán mạnh mẽ giữa Cache và Database | Bất đồng bộ; rủi ro lệch dữ liệu tạm thời | Nhất quán cuối cùng phụ thuộc chu kỳ quét |
| Rủi ro mất dữ liệu | Bằng 0 (Database luôn là nguồn sự thật) | Bằng 0 (ghi thành công cả hai tầng mới xác nhận) | Có rủi ro nếu node Redis sập trước khi flush | Bằng 0 (dữ liệu nguồn nằm ở Database) |
| Tình huống tối ưu | Ứng dụng đọc nhiều, dữ liệu thay đổi vừa phải | Tài khoản tài chính, thông tin xác thực | Ghi log, đếm lượt xem, hệ thống IoT, Game | Dữ liệu dự đoán trước theo lịch trình cố định |
Qua bảng so sánh tổng quan trên, có thể thấy không có một mô hình bộ nhớ đệm nào hoàn hảo tuyệt đối trên mọi phương diện. Sự đánh đổi giữa độ trễ ghi, độ phức tạp kiến trúc và mức độ nhất quán dữ liệu là quy luật tất yếu. Để tối ưu redis cache đạt hiệu quả cao nhất, các hệ thống lớn thường không áp dụng cứng nhắc một mô hình duy nhất cho toàn bộ hệ thống, mà phân chia linh hoạt: áp dụng mô hình cache aside cho thông tin sản phẩm và hồ sơ người dùng, kết hợp mô hình Write-Behind cho các tác vụ cập nhật lượt xem và số liệu thống kê thời gian thực.
Điểm khác biệt lớn nhất giữa kiến trúc đọc đệm và ghi đệm
Khi đào sâu vào bản chất của một chiến lược caching với redis, ranh giới phân định quan trọng nhất nằm ở hướng đi của dòng chảy dữ liệu: hệ thống đang ưu tiên tối ưu hóa cho chu trình đọc dữ liệu hay chu trình ghi nhận dữ liệu. Việc nhầm lẫn giữa hai bài toán này là nguyên nhân cốt lõi khiến nhiều dự án đầu tư phần cứng đắt tiền nhưng hiệu quả mang lại không tương xứng.
Đánh đổi cốt lõi giữa khối lượng công việc đọc nhiều và ghi nhiều
Trong các ứng dụng web thông thường như báo điện tử, mạng xã hội hay trang thương mại điện tử, tỷ lệ đọc/ghi thường nghiêng lệch rất lớn về phía đọc, đạt tỷ lệ 90:10 hoặc thậm chí 99:1. Hàng triệu người dùng truy cập để xem cùng một bài viết, một danh mục hàng hóa hoặc bảng tin trang chủ, trong khi số lượt tạo mới hoặc cập nhật nội dung chỉ chiếm một phần rất nhỏ. Với kịch bản này, các kiến trúc đọc đệm như mô hình cache aside mang lại giá trị to lớn: chỉ cần nạp dữ liệu vào Redis một lần duy nhất, hàng trăm ngàn lượt đọc tiếp theo sẽ được phục vụ trọn vẹn từ RAM với chi phí tài nguyên cực thấp.
Ngược lại, một chiến lược caching với redis dành cho các hệ thống giám sát phân tán, theo dõi hành vi người dùng, nền tảng quảng cáo trực tuyến hay máy chủ game, tỷ lệ đọc/ghi có thể đảo ngược thành 1:10 hoặc 1:100. Hàng chục ngàn thao tác ghi đổ dồn về mỗi giây. Nếu hệ thống cố gắng duy trì một tầng đệm đọc đồng bộ, mỗi thao tác ghi sẽ liên tục kích hoạt việc xóa hoặc cập nhật khóa bộ nhớ đệm, dẫn đến hiện tượng đảo khóa liên tục và khiến tỷ lệ trúng bộ nhớ đệm giảm mạnh về gần mức 0. Lúc này, chỉ có các kiến trúc ghi đệm bất đồng bộ như Write-Behind mới có khả năng gom cụm các thao tác ghi lại trong Redis trước khi xả định kỳ xuống cơ sở dữ liệu.
Rủi ro phân mảnh dữ liệu và bài toán CAP trong hệ thống phân tán
Khi đưa Redis vào song hành cùng một cơ sở dữ liệu quan hệ, bạn thực chất đã biến hệ thống của mình thành một hệ thống phân tán hai nút chứa dữ liệu. Theo định lý CAP, một hệ thống phân tán không bao giờ có thể đồng thời đạt được tính nhất quán tuyệt đối và tính sẵn sàng cao khi có sự cố phân tách mạng xảy ra.
Trong hầu hết các thiết kế chiến lược caching với redis, chúng ta chủ động lựa chọn tính sẵn sàng và chấp nhận tính nhất quán cuối cùng. Điều này đồng nghĩa với việc sẽ luôn tồn tại những khoảng thời gian vi mô mà dữ liệu phản hồi từ Redis có thể bị cũ hơn so với trạng thái mới nhất trong cơ sở dữ liệu chính. Kỹ sư hệ thống bắt buộc phải trao đổi rõ ràng với các bên liên quan về mặt nghiệp vụ: liệu nghiệp vụ này có chấp nhận được dữ liệu cũ tạm thời hay không? Đối với bảng xếp hạng hay danh sách bài viết, dữ liệu chậm vài giây là hoàn toàn chấp nhận được; nhưng đối với số dư tài khoản ngân hàng hay số lượng vé máy bay còn lại, việc để lộ dữ liệu cũ có thể dẫn đến việc bán vượt số lượng gây thiệt hại kinh tế nghiêm trọng.
Ranh giới chịu lỗi và cơ chế suy thoái mềm dẻo khi Redis gặp sự cố
Một kiến trúc bền vững không phải là một kiến trúc không bao giờ gặp lỗi, mà là một kiến trúc biết cách ứng xử an toàn khi sự cố xảy ra. Khái niệm cơ chế suy thoái mềm dẻo đặt ra yêu cầu sống còn: nếu toàn bộ cụm máy chủ Redis bị mất kết nối mạng, cạn RAM hoặc gặp sự cố phần cứng, ứng dụng có tiếp tục phục vụ người dùng được hay không?
Một ưu điểm vượt bậc của mô hình cache aside là tính chất cách ly cao. Trong mã ứng dụng, mọi lệnh gọi tới Redis luôn được bao bọc trong khối kiểm tra lỗi an toàn với cơ chế ngắt mạch. Nếu Redis không phản hồi trong khoảng thời gian quy định, ứng dụng sẽ lập tức ghi nhận cảnh báo, bỏ qua tầng đệm và truy vấn thẳng xuống cơ sở dữ liệu chính để lấy dữ liệu trả về cho client. Mặc dù thời gian phản hồi lúc này có thể chậm hơn đôi chút, người dùng vẫn thực hiện được tác vụ mà không nhận về mã lỗi hệ thống. Bạn có thể tham khảo thêm về các kỹ thuật điều phối trạng thái phân tán qua bài viết cơ chế distributed lock phân tán để hiểu rõ cách các tiến trình phối hợp an toàn khi mạng chập chờn.
Phân tích kỹ thuật mô hình cache aside và cơ chế lazy loading
Trong toàn bộ các giải pháp bộ nhớ đệm hiện đại, mô hình cache aside là kiến trúc nền tảng được đại đa số các ứng dụng sản xuất trên nền tảng Node.js, Go, Python, Laravel hay Java Spring Boot lựa chọn triển khai. Tên gọi Cache-Aside xuất phát từ vị trí địa lý của tầng đệm: bộ nhớ đệm nằm ở bên cạnh ứng dụng, và chính mã nguồn ứng dụng là bên trực tiếp giao tiếp song song với cả Cache lẫn Database.
Luồng tuần tự khi trúng bộ nhớ đệm và trượt bộ nhớ đệm
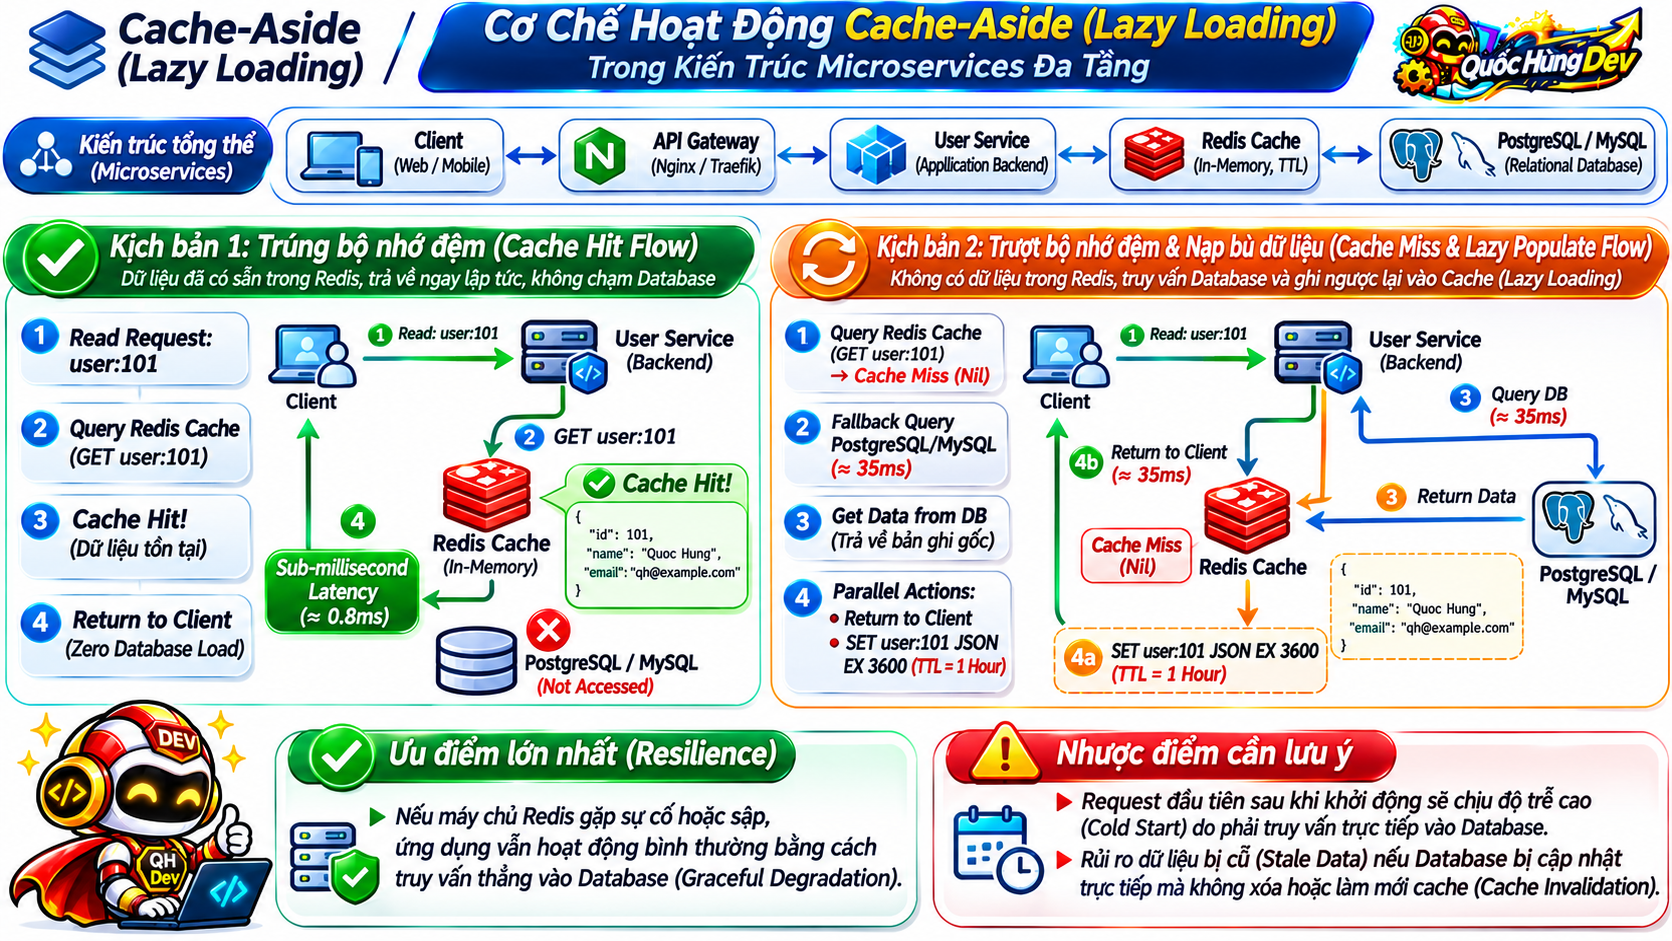
Trong một chiến lược caching với redis áp dụng mô hình nạp lười, cơ chế vận hành của mô hình cache aside diễn ra theo hai kịch bản tuần tự rất mạch lạc và trực quan:
1. Kịch bản trúng bộ nhớ đệm: Khi nhận được yêu cầu đọc dữ liệu từ phía người dùng, ứng dụng sẽ tạo khóa định danh tương ứng và gửi lệnh truy vấn tới Redis trước tiên. Nếu khóa tồn tại và dữ liệu hợp lệ, Redis sẽ trả về chuỗi JSON tức thì trong khoảng dưới một mili-giây. Ứng dụng giải mã chuỗi JSON và trả kết quả ngay cho client. Toàn bộ thao tác hoàn tất mà không phát sinh bất kỳ một kết nối hay câu lệnh truy vấn nào xuống cơ sở dữ liệu chính.
2. Kịch bản trượt bộ nhớ đệm: Trong trường hợp khóa chưa từng được tạo hoặc đã hết hạn thời gian sống TTL, Redis trả về kết quả rỗng. Lúc này, ứng dụng sẽ thực hiện cơ chế nạp lười: nó chuyển hướng truy vấn trực tiếp xuống cơ sở dữ liệu quan hệ chính. Khi cơ sở dữ liệu phản hồi bản ghi, ứng dụng thực hiện đồng thời hai việc: gửi dữ liệu về cho người dùng, và ghi bản ghi đó ngược trở lại vào Redis kèm thời gian sống xác định để sẵn sàng phục vụ cho các request tiếp theo.
Nguyên tắc vàng: xóa khóa thay vì cập nhật khóa khi thay đổi dữ liệu
Khi có một yêu cầu thay đổi dữ liệu diễn ra, rất nhiều kỹ sư thường phạm phải một sai lầm nghiêm trọng: sau khi cập nhật cơ sở dữ liệu thành công, họ cố gắng lấy dữ liệu mới đó để ghi đè lên khóa cũ trong Redis. Trong môi trường đa luồng có lưu lượng cao, thao tác này sẽ lập tức kích hoạt lỗi tranh chấp điều kiện làm sai lệch dữ liệu vĩnh viễn.
Hãy hình dung tình huống có 2 tiến trình A và B cùng cập nhật thông tin của cùng một sản phẩm gần như đồng thời. Tiến trình A cập nhật Database với giá trị X trước. Sau đó Tiến trình B cập nhật Database với giá trị Y sau. Theo thứ tự thời gian logic của Database, giá trị Y là giá trị chuẩn xác cuối cùng. Tuy nhiên, do hiện tượng trễ mạng hoặc tiến trình A bị dừng tạm thời bởi cơ chế thu gom rác bộ nhớ, lệnh ghi Redis của Tiến trình B lại tới máy chủ Redis trước, và một tích tắc sau lệnh ghi Redis của Tiến trình A mới cập bến. Hậu quả là Database đang lưu giá trị Y mới nhất, nhưng Redis lại lưu giá trị X cũ rích!
Để triệt tiêu hoàn toàn rủi ro này, nguyên tắc vàng trong thiết kế mô hình cache aside là: Luôn luôn xóa khóa thay vì cập nhật khóa. Khi dữ liệu trong Database thay đổi, ứng dụng chỉ cần phát lệnh xóa khóa. Bằng cách xóa sạch khóa, chúng ta ép buộc request đọc tiếp theo phải chấp nhận một lần trượt đệm để nạp lại bản ghi chuẩn xác nhất trực tiếp từ nguồn sự thật là Database.
Triển khai mã nguồn minh họa chuẩn hóa cho mô hình cache aside
Dưới đây là một đoạn mã nguồn mẫu minh họa cách thức triển khai mô hình cache aside chuẩn mực cho môi trường sản xuất, tích hợp sẵn cơ chế xử lý lỗi an toàn và cài đặt thời gian sống phù hợp:
import Redis from 'ioredis';

const redis = new Redis({
  host: process.env.REDIS_HOST || '127.0.0.1',
  port: Number(process.env.REDIS_PORT) || 6379,
  connectTimeout: 2500,
  maxRetriesPerRequest: 2,
});

interface Product {
  id: string;
  name: string;
  price: number;
}

// Giả lập hàm truy vấn Database
async function fetchProductFromDatabase(productId: string): Promise<Product | null> {
  return { id: productId, name: 'Thiết bị mạng cao cấp', price: 250 };
}

export async function getProductById(productId: string): Promise<Product | null> {
  const cacheKey = `cache:product:${productId}`;

  // 1. Đọc dữ liệu từ tầng đệm Redis với cơ chế bắt lỗi an toàn
  try {
    const cachedData = await redis.get(cacheKey);
    if (cachedData) {
      return JSON.parse(cachedData) as Product;
    }
  } catch (error) {
    console.warn(`[Cache Warning] Không thể kết nối Redis để đọc key ${cacheKey}:`, error);
  }

  // 2. Kịch bản trượt bộ nhớ đệm: Đọc trực tiếp từ cơ sở dữ liệu chính
  const product = await fetchProductFromDatabase(productId);
  if (!product) {
    return null;
  }

  // 3. Nạp lười dữ liệu vào Redis kèm thời gian sống TTL 3600 giây
  try {
    await redis.set(cacheKey, JSON.stringify(product), 'EX', 3600);
  } catch (error) {
    console.warn(`[Cache Warning] Không thể ghi dữ liệu vào Redis cho key ${cacheKey}:`, error);
  }

  return product;
}

export async function updateProduct(productId: string, updateData: Partial<Product>): Promise<void> {
  // 1. Cập nhật dữ liệu vào cơ sở dữ liệu trước tiên
  console.log(`Cập nhật database cho sản phẩm ${productId}`);

  // 2. Nguyên tắc vàng: Xóa khóa khỏi Redis thay vì ghi đè giá trị
  const cacheKey = `cache:product:${productId}`;
  try {
    await redis.del(cacheKey);
  } catch (error) {
    console.error(`[Cache Error] Thất bại khi xóa cache key ${cacheKey}:`, error);
  }
}
Đoạn mã trên thể hiện trọn vẹn một chiến lược caching với redis có tính phòng thủ cao của một kỹ sư Backend vững chắc của một kỹ sư Backend: ứng dụng không bao giờ bị phụ thuộc cứng vào sự sống còn của Redis, sẵn sàng bỏ qua tầng đệm nếu có lỗi xảy ra và luôn bảo vệ tính toàn vẹn của dữ liệu nghiệp vụ.
Cơ chế chuyên sâu write-through và write-behind trong xử lý tải cao
Trong khi mô hình Cache-Aside phó thác toàn bộ quyền kiểm soát cho mã ứng dụng, hai mô hình Write-Through và Write-Behind lại biến tầng bộ nhớ đệm thành cổng giao tiếp chính thức duy nhất của mọi thao tác ghi dữ liệu. Đây là các giải pháp cấp cao được thiết kế nhằm phục vụ những kịch bản kỹ thuật đặc thù trong một chiến lược caching với redis toàn diện.
Kiến trúc đồng bộ hai tầng write-through đảm bảo nhất quán
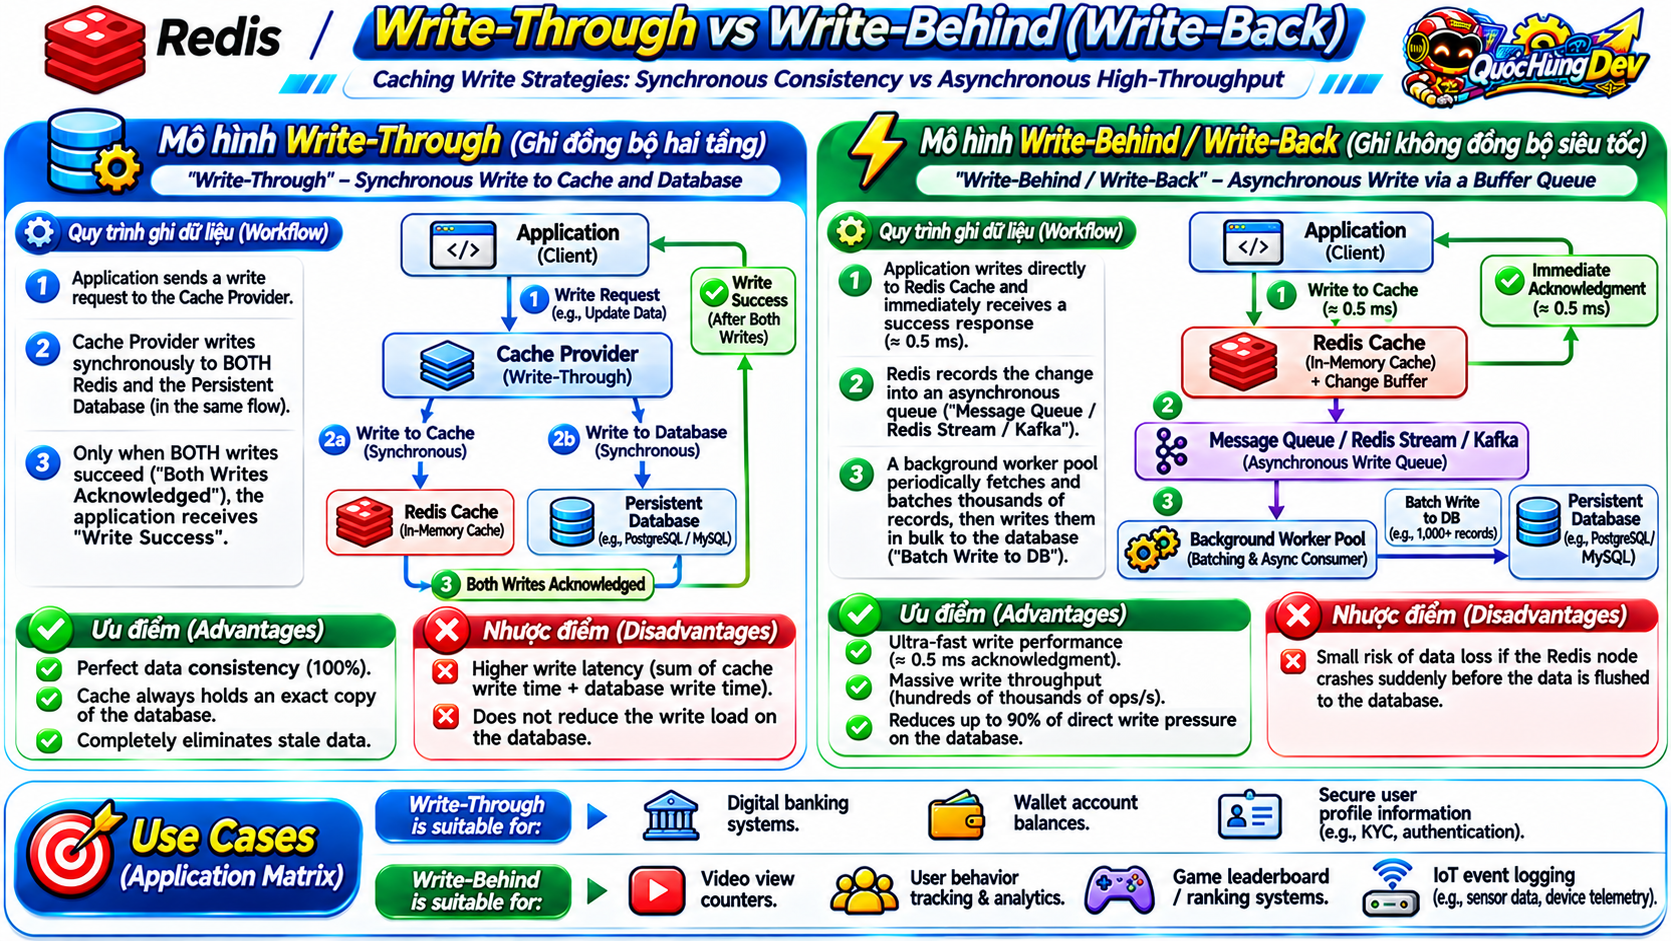
Trong mô hình Write-Through, khi ứng dụng cần cập nhật hoặc thêm mới một bản ghi, nó không gọi trực tiếp xuống cơ sở dữ liệu. Thay vào đó, nó gửi yêu cầu ghi tới tầng quản lý bộ nhớ đệm. Lớp trung gian này sẽ thực hiện một thao tác ghi đồng bộ hai bước:
Khi triển khai chiến lược caching với redis theo mô hình Write-Through, bước đầu tiên là cập nhật bản ghi vào bộ nhớ đệm Redis. Ngay sau đó, trong cùng một chu kỳ giao dịch, nó gọi lệnh ghi bản ghi đó xuống cơ sở dữ liệu quan hệ. Chỉ khi nào cả hai tầng lưu trữ đều xác nhận đã ghi thành công dữ liệu xuống bộ nhớ và đĩa cứng, lớp trung gian mới gửi phản hồi thành công về cho mã ứng dụng. Nếu thao tác ghi cơ sở dữ liệu thất bại, thao tác trên Redis cũng bị hoàn tác để bảo toàn tính nhất quán.
Lợi thế lớn nhất của Write-Through là loại bỏ hoàn toàn tình trạng trượt bộ nhớ đệm sau khi ghi. Bất kỳ một yêu cầu đọc nào diễn ra ngay sau thao tác ghi đều sẽ trúng bộ nhớ đệm với dữ liệu mới nhất. Tuy nhiên, cái giá phải trả là độ trễ ghi dữ liệu tăng lên đáng kể, bằng tổng thời gian phản hồi của mạng Redis cộng với thời gian I/O đĩa cứng của cơ sở dữ liệu.
Kiến trúc bất đồng bộ write-behind hấp thụ xung lực ghi siêu tốc
Trái ngược hoàn toàn với sự thận trọng của Write-Through, mô hình Write-Behind là giải pháp tối thượng dành cho các bài toán xử lý tải ghi cực lớn. Khi ứng dụng phát lệnh ghi, tầng đệm Redis ghi nhận dữ liệu vào bộ nhớ RAM, đưa sự kiện thay đổi vào một hàng đợi nội bộ và lập tức phản hồi thành công về cho ứng dụng trong vòng nửa mili-giây.
Dữ liệu chưa hề được lưu xuống cơ sở dữ liệu quan hệ tại thời điểm client nhận thông báo thành công. Ở phía sau hậu trường, một cụm tiến trình xử lý nền độc lập sẽ định kỳ lấy các sự kiện từ hàng đợi Redis, gom hàng ngàn thao tác ghi lẻ tẻ thành một mẻ lớn, rồi mới thực thi một câu lệnh ghi duy nhất xuống cơ sở dữ liệu chính. Ví dụ: thay vì thực thi hàng chục ngàn câu lệnh cập nhật lượt xem làm nghẽn kết nối database, tiến trình nền chỉ cần cộng dồn các lượt xem trong RAM và chạy đúng một câu lệnh cập nhật duy nhất.
Chiến lược phòng ngừa mất mát dữ liệu khi nút bộ nhớ đệm sập đột ngột
Điểm yếu lớn nhất của mô hình Write-Behind là nguy cơ mất mát dữ liệu tạm thời. Nếu máy chủ Redis bị mất nguồn đột ngột hoặc tiến trình bị hệ điều hành tiêu diệt do hết bộ nhớ trước khi tiến trình nền kịp xả dữ liệu xuống đĩa cứng của database, toàn bộ các bản ghi vừa được ghi nhận trong RAM sẽ biến mất.
Để triển khai Write-Behind an toàn trong môi trường doanh nghiệp, kỹ sư hạ tầng bắt buộc phải cấu hình tính năng bền vững dữ liệu nâng cao cho Redis: kích hoạt cơ chế ghi nhật ký Append-Only File để Redis liên tục xả log ghi xuống đĩa cứng định kỳ. Đồng thời, cấu hình mô hình bản sao cụm Redis Sentinel hoặc Redis Cluster để nếu nút chính gặp sự cố, nút phụ sẽ được tự động thăng cấp lên thay thế ngay lập tức mà không làm đứt đoạn chuỗi hàng đợi ghi.
Hiểm họa cache invalidation và giải pháp đồng bộ dữ liệu đa tầng
Trong một chiến lược caching với redis, khâu khó khăn nhất không nằm ở việc nạp dữ liệu vào RAM, mà nằm ở việc nhận biết chính xác khi nào dữ liệu trong bộ nhớ đệm đã bị cũ để loại bỏ kịp thời. Hiện tượng dữ liệu sai lệch giữa cache và database là nguồn gốc của vô số lỗi nghiệp vụ nghiêm trọng trong các hệ thống phân tán.
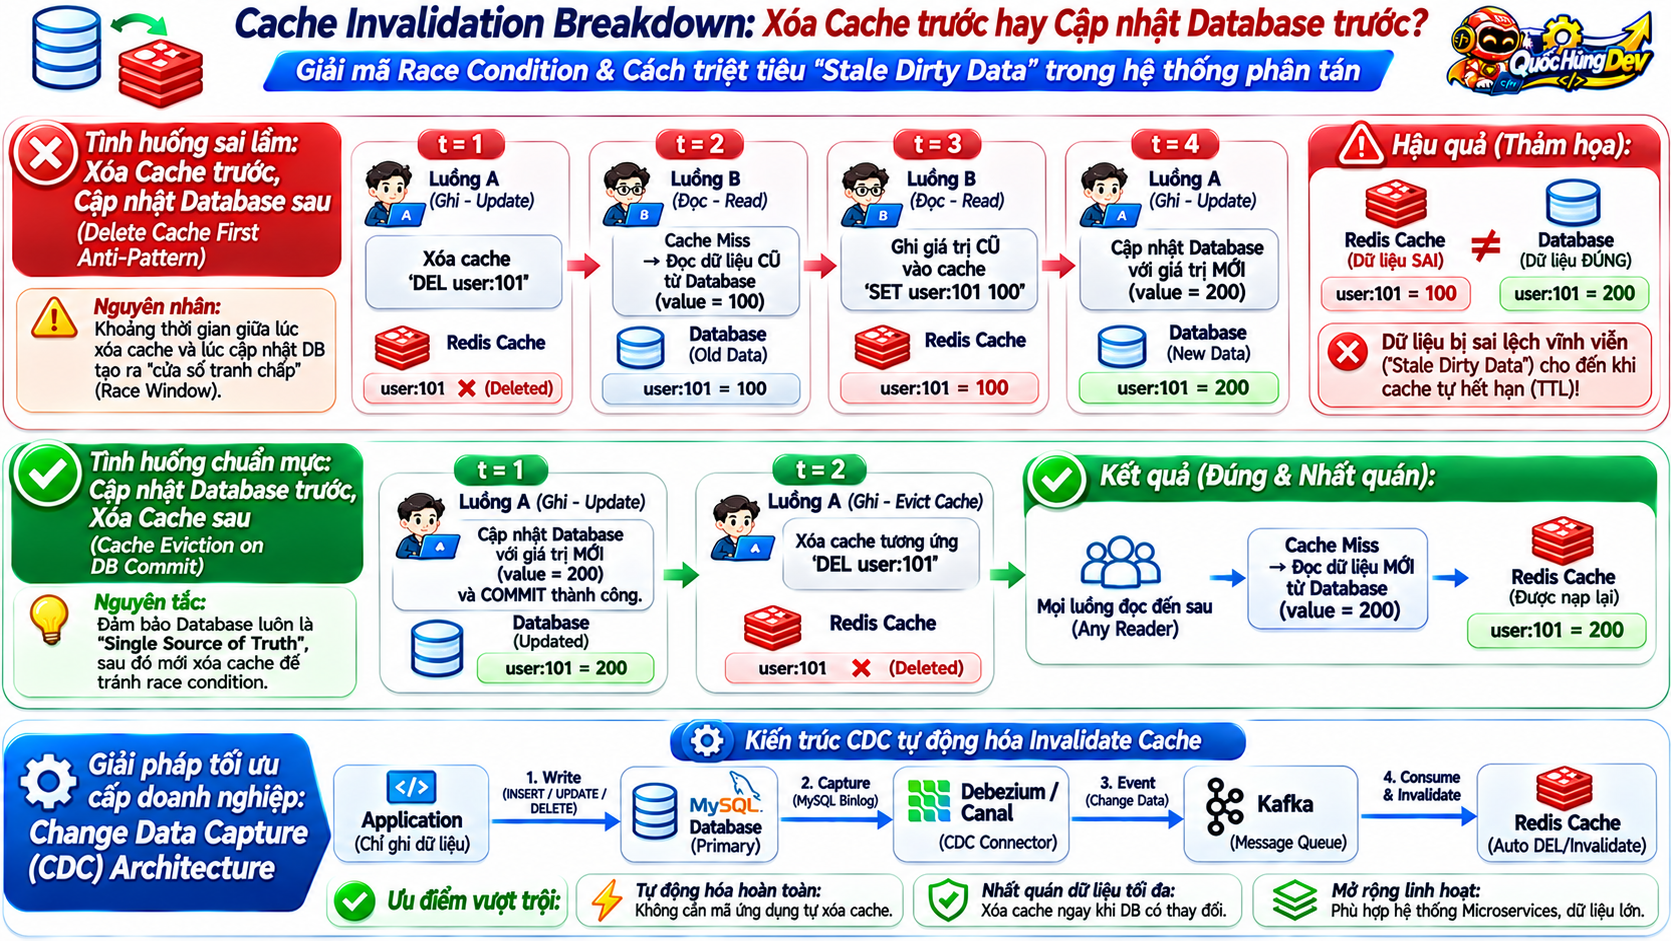
Bẫy tranh chấp đồng thời khi xóa cache trước hay cập nhật database trước
Khi tiến hành xử lý cache invalidation trong mã nguồn ứng dụng, câu hỏi muôn thuở đặt ra là: Nên xóa cache Redis trước rồi mới cập nhật Database, hay nên cập nhật Database trước rồi mới xóa cache Redis? Cả hai phương án đều tiềm ẩn những kịch bản tranh chấp luồng tinh vi mà nếu không phân tích kỹ, bạn sẽ tự gài bẫy chính mình.
Phương án xóa cache trước, cập nhật database sau: Đây là sai lầm phổ biến nhất của các lập trình viên. Khi Luồng Ghi xóa khóa trong Redis, ngay lập tức một Luồng Đọc xuất hiện. Do thấy cache rỗng, Luồng Đọc truy vấn xuống Database (lúc này chưa kịp cập nhật xong và vẫn chứa giá trị cũ) và ghi giá trị cũ đó ngược trở lại vào Redis. Sau đó Luồng Ghi mới cập nhật xong Database. Hậu quả là Database mang giá trị mới, nhưng Redis lại vĩnh viễn lưu trữ giá trị cũ sai lệch cho đến khi hết thời gian sống TTL!
Phương án cập nhật database trước, xóa cache sau: Đây là phương án chuẩn mực được cộng đồng kỹ sư thế giới khuyến nghị áp dụng. Luồng Ghi luôn cập nhật Database và đảm bảo giao dịch cơ sở dữ liệu đã hoàn tất thành công, sau đó mới gửi lệnh xóa khóa tới Redis. Khoảng thời gian xảy ra xung đột trong thực tế của phương án này là cực kỳ hiếm hoi và hoàn toàn có thể kiểm soát được.
Tự động hóa việc xóa cache bằng công nghệ change data capture
Trong các kiến trúc vi dịch vụ quy mô lớn, việc để từng đoạn mã ứng dụng tự chịu trách nhiệm gọi lệnh xóa Redis bộc lộ rất nhiều rủi ro: lập trình viên có thể quên thêm lệnh xóa, hoặc tiến trình ứng dụng bị sập đột ngột ngay sau khi cập nhật database khiến lệnh xóa cache không bao giờ được gửi đi.
Giải pháp tối tân nhất để xử lý cache invalidation hiện nay là tách rời hoàn toàn logic xóa cache ra khỏi mã ứng dụng thông qua kiến trúc Change Data Capture. Thay vì can thiệp thủ công trong code, chúng ta thiết lập một công cụ lắng nghe chuyên dụng như Debezium kết nối trực tiếp vào nhật ký nhị phân của cơ sở dữ liệu. Mỗi khi có một bản ghi trong database bị thêm mới, sửa đổi hoặc xóa bỏ, công cụ sẽ lập tức bắt trọn sự kiện này ở cấp độ cơ sở dữ liệu và đẩy vào một chủ đề trên hàng đợi phân tán.
Một dịch vụ xử lý nền sẽ lắng nghe chủ đề này, giải mã bản ghi vừa thay đổi, tìm ra các khóa Redis liên quan và thực thi lệnh xóa khóa một cách hoàn toàn tự động và bất đồng bộ. Nhờ cơ chế đảm bảo chuyển phát tin cậy, ngay cả khi dịch vụ xóa cache bị khởi động lại, nó vẫn sẽ tiếp tục đọc các sự kiện tồn đọng và xóa sạch các khóa cũ mà không bao giờ bị bỏ sót.
Chiến lược gắn thẻ khóa thông minh và cơ chế hai lần xóa trễ
Một thách thức lớn khác khi xử lý cache invalidation là việc một bản ghi thay đổi có thể ảnh hưởng đến hàng chục khóa cache khác nhau. Ví dụ: khi giá của một sản phẩm thay đổi, bạn không chỉ phải xóa khóa chi tiết sản phẩm, mà còn phải xóa toàn bộ các khóa danh sách danh mục liên quan. Nếu không có cơ chế quản lý khoa học, bạn sẽ không thể biết được cần phải xóa những khóa nào.
Trong một chiến lược caching với redis quy mô lớn, kỹ thuật gắn thẻ khóa giải quyết triệt để bài toán này. Bằng cách sử dụng cấu trúc dữ liệu Set trong Redis, mỗi khi nạp một khóa danh sách vào cache, chúng ta ghi nhận tên khóa đó vào một Set mang tên thẻ thực thể. Khi sản phẩm bị cập nhật, ứng dụng chỉ cần truy vấn tập hợp thẻ để lấy toàn bộ danh sách các khóa liên quan và xóa sạch chúng trong một lệnh duy nhất.
Ngoài ra, đối với các hệ thống có cấu hình cơ sở dữ liệu bị trễ bản sao giữa các nút đọc và ghi, kỹ thuật hai lần xóa trễ là một vũ khí phòng thủ đắc lực: ứng dụng xóa cache lần một khi cập nhật, sau đó đẩy một thông điệp vào hàng đợi trễ để thực thi việc xóa cache lần thứ hai sau một khoảng thời gian ngắn. Lần xóa thứ hai này đảm bảo quét sạch mọi dữ liệu cũ mà các luồng đọc vô tình nạp từ nút phụ lên trước khi dữ liệu kịp đồng bộ hoàn tất.
Bí quyết chống cache stampede và kiểm soát tải đột biến
Trong số tất cả các sự cố liên quan đến bộ nhớ đệm trong môi trường sản xuất, hiện tượng Cache Stampede là nguyên nhân hàng đầu khiến các hệ thống lớn sụp đổ dây chuyền chỉ trong vài giây. Một chiến lược caching với redis hoàn chỉnh bắt buộc phải trang bị các cơ chế phòng thủ đa lớp để kiểm soát triệt để hiện tượng này.
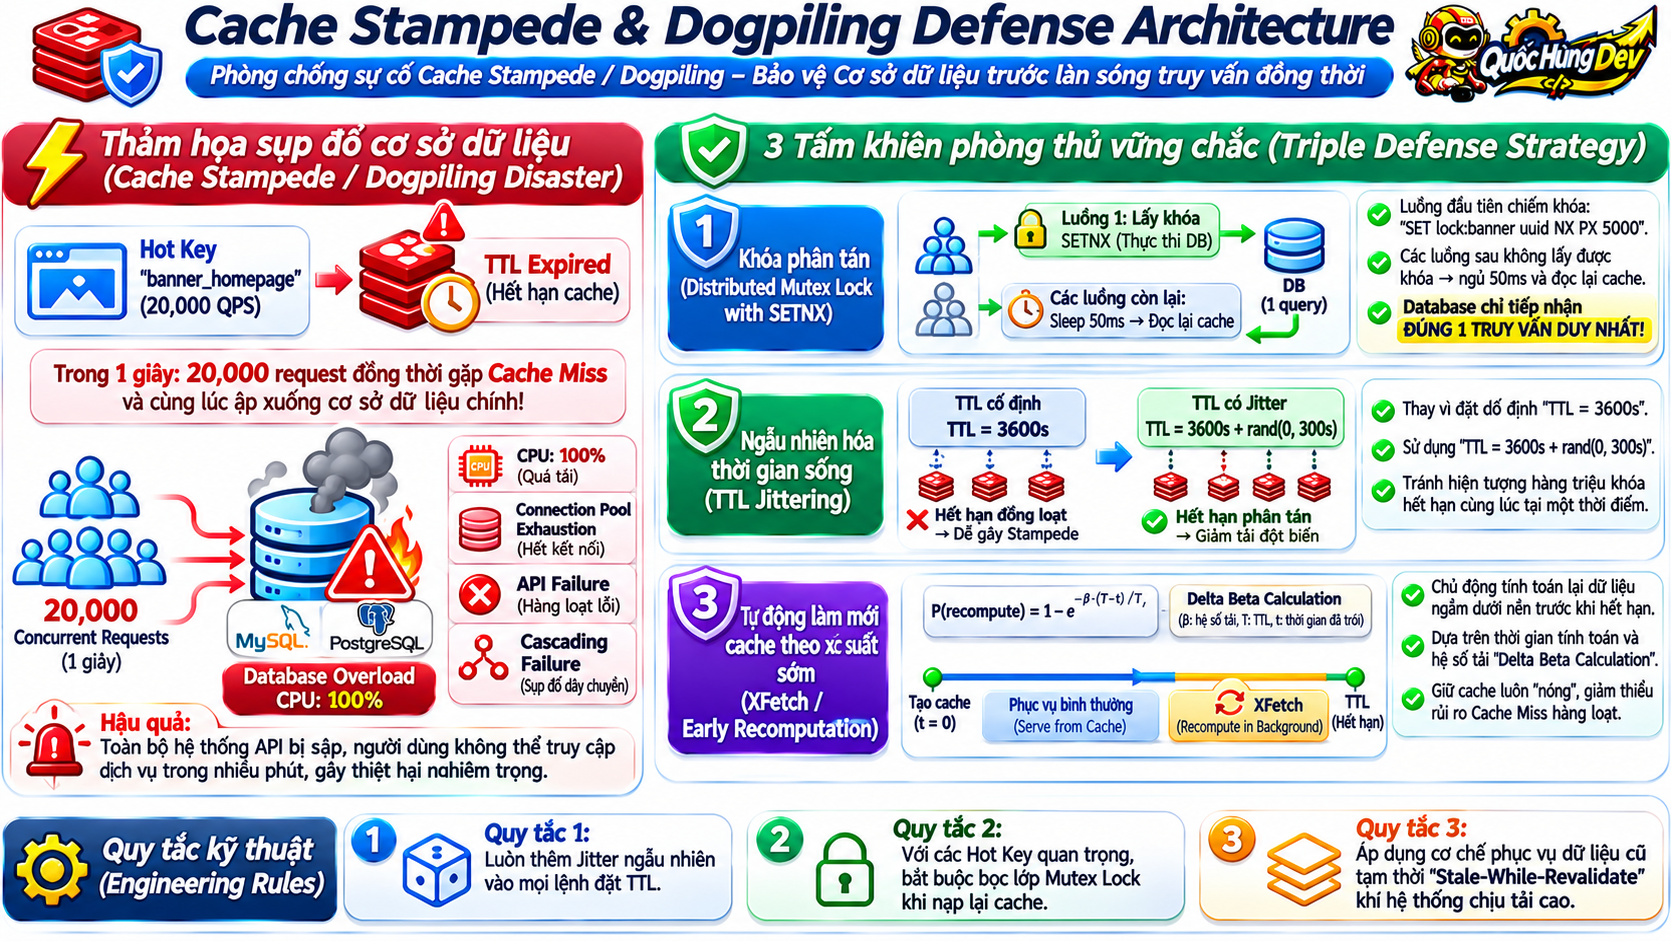
Hiện tượng sụp đổ dây chuyền khi các khóa nóng hết hạn đồng loạt
Hiện tượng Cache Stampede diễn ra khi một khóa nóng chứa dữ liệu có tần suất truy cập cực cao đột ngột hết hạn thời gian sống TTL. Trong đúng một khoảng thời gian ngắn mà khóa biến mất khỏi Redis, hàng chục ngàn luồng truy vấn đồng thời đều gặp tình trạng trượt đệm.
Theo logic thông thường của mô hình cache aside, khi gặp trượt đệm, ứng dụng sẽ chuyển hướng truy vấn xuống cơ sở dữ liệu để lấy lại dữ liệu. Kết quả là hàng chục ngàn kết nối SQL phức tạp đồng loạt giáng xuống máy chủ cơ sở dữ liệu trong cùng một thời điểm. Mức sử dụng bộ xử lý CPU của database vọt thẳng lên mức tối đa, hàng đợi kết nối bị tràn, thời gian phản hồi tăng vọt và toàn bộ cụm máy chủ cơ sở dữ liệu bị treo cứng. Khi database sập, toàn bộ các dịch vụ phụ thuộc khác trong hệ thống vi dịch vụ cũng đồng loạt ngừng hoạt động theo hiệu ứng tuyết lở.
Triển khai khóa phân tán với lệnh SET NX PX và kịch bản chờ đợi
Vũ khí phòng thủ đầu tiên và hiệu quả nhất để chống cache stampede là kỹ thuật khóa phân tán. Thay vì cho phép hàng ngàn luồng cùng lao xuống database khi gặp trượt đệm, chúng ta bắt buộc các luồng phải xếp hàng và chỉ cấp quyền duy nhất cho một luồng đại diện được phép truy cập database để nạp lại dữ liệu.
Trong Redis, chúng ta sử dụng lệnh nguyên tử SET với hai tham số điều kiện NX và PX. Tham số NX đảm bảo rằng khóa chỉ được tạo thành công nếu nó chưa từng tồn tại, và tham số PX gán một thời gian hết hạn tính bằng mili-giây để ngăn chặn tình trạng khóa chết nếu tiến trình nắm giữ khóa bị sập. Luồng nào chiếm được khóa sẽ đi xuống Database để truy vấn dữ liệu và nạp lại vào Redis. Hàng ngàn luồng còn lại do không lấy được khóa sẽ tự động ngủ tạm trong một khoảng thời gian ngắn, sau đó thức dậy và đọc lại dữ liệu mới từ Redis mà không hề chạm vào Database. Để hiểu sâu hơn về cơ chế này, bạn có thể tham khảo thêm bài phân tích về cơ chế locking database optimistic và pessimistic để nắm vững sự phối hợp giữa khóa tầng ứng dụng và khóa tầng dữ liệu.
import { randomUUID } from 'crypto';

async function getHotProductWithMutex(productId: string): Promise<any> {
  const cacheKey = `product:hot:${productId}`;
  const lockKey = `lock:${cacheKey}`;

  // 1. Kiểm tra cache Redis trước
  let data = await redis.get(cacheKey);
  if (data) {
    return JSON.parse(data);
  }

  // 2. Kịch bản trượt đệm: Thử chiếm khóa phân tán
  const lockToken = randomUUID();
  const acquired = await redis.set(lockKey, lockToken, 'NX', 'PX', 3000);

  if (acquired === 'OK') {
    try {
      // Chỉ DUY NHẤT luồng này được quyền truy vấn cơ sở dữ liệu
      const dbData = await db.queryProduct(productId);

      // Nạp lại vào cache với thời gian sống 300 giây
      await redis.set(cacheKey, JSON.stringify(dbData), 'EX', 300);
      return dbData;
    } finally {
      // Giải phóng khóa an toàn bằng kịch bản Lua (chỉ xóa nếu đúng token sở hữu)
      const releaseLua = `
        if redis.call("get", KEYS[1]) == ARGV[1] then
          return redis.call("del", KEYS[1])
        else
          return 0
        end
      `;
      await redis.eval(releaseLua, 1, lockKey, lockToken);
    }
  } else {
    // Các luồng khác không lấy được khóa: Chờ tạm 60ms và gọi lại hàm
    await new Promise((resolve) => setTimeout(resolve, 60));
    return getHotProductWithMutex(productId);
  }
}
Thuật toán tính toán lại ngầm sớm theo xác suất xfetch
Bên cạnh khóa phân tán, một chiến lược caching với redis hiện đại có thể áp dụng phương pháp tiếp cận đột phá để chống cache stampede mà không cần dùng đến khóa phân tán là thuật toán tính toán lại sớm theo xác suất, thường được biết đến với tên gọi thuật toán xfetch trong các nghiên cứu khoa học máy tính.
Thay vì chờ đợi cho khóa chạm đến thời điểm hết hạn tuyệt đối, thuật toán xfetch tính toán một hàm xác suất dựa trên thời gian tính toán thực tế của câu truy vấn, hệ số tải hệ thống và thời gian còn lại trước khi hết hạn. Khi khóa càng tiến gần tới thời điểm hết hạn và câu truy vấn tính toán càng nặng, xác suất kích hoạt việc tính toán lại ngầm ở một luồng đọc ngẫu nhiên sẽ tăng dần lên.
Một luồng đọc ngẫu nhiên trúng xác suất sẽ chủ động đi xuống database để nạp lại dữ liệu mới và cập nhật thời gian sống cho khóa ngay trong khi khóa vẫn đang hợp lệ. Các luồng đọc khác trong suốt thời gian đó vẫn tiếp tục đọc được dữ liệu hiện có từ cache mà không bị gián đoạn. Nhờ đó, khóa nóng luôn được làm mới liên tục ở chế độ nền mà không bao giờ rơi vào trạng thái trống rỗng.
Ngẫu nhiên hóa thời gian sống với kỹ thuật TTL jittering
Bên cạnh các khóa nóng riêng lẻ, thảm họa tuyết lở còn thường xảy ra khi hệ thống khởi động lại hoặc khi một tiến trình nạp hàng loạt nạp hàng ngàn khóa vào Redis cùng một lúc với cùng một giá trị TTL cố định. Sau một khoảng thời gian bằng đúng TTL, hàng chục ngàn khóa này sẽ đồng loạt hết hạn tại cùng một giây, tạo ra một cơn xung kích truy vấn khủng khiếp giáng xuống database.
Giải pháp kỹ thuật để triệt tiêu hiện tượng này là áp dụng kỹ thuật TTL jittering. Mỗi khi thiết lập thời gian sống cho khóa, chúng ta luôn cộng thêm một khoảng thời gian ngẫu nhiên từ 5% đến 15% vào giá trị gốc. Việc phân tán thời gian hết hạn của các khóa trải đều trên trục thời gian giúp làm phẳng biểu đồ tải của database, loại bỏ hoàn toàn các đỉnh tải nhọn nguy hiểm.
Chi phí hạ tầng bộ nhớ, giới hạn tài nguyên và bảng giá dịch vụ Redis
Một trong những yếu tố thực tế mang tính sống còn khi thiết kế một chiến lược caching với redis cho doanh nghiệp là bài toán kinh tế và quản trị chi phí tài nguyên phần cứng. Bộ nhớ RAM là một trong những tài nguyên máy chủ có giá thành đắt đỏ nhất. Nếu không kiểm soát dung lượng một cách chặt chẽ, chi phí hạ tầng đám mây cho Redis có thể tăng vọt trong khi hiệu quả mang lại không tương xứng.
Hoạch định dung lượng RAM và chính sách dọn dẹp khóa maxmemory-policy
Để tối ưu redis cache về mặt lưu trữ, khi dung lượng dữ liệu nạp vào Redis vượt quá giới hạn bộ nhớ được cấp phát trong tệp cấu hình, Redis sẽ xử lý như thế nào? Quyết định này phụ thuộc hoàn toàn vào cấu hình thông số maxmemory-policy của máy chủ:
Chính sách noeviction: Khi bộ nhớ đầy, Redis sẽ từ chối toàn bộ các lệnh ghi dữ liệu mới và trả về mã lỗi thông báo vượt quá bộ nhớ. Chính sách này tuyệt đối không phù hợp cho tầng bộ nhớ đệm vì nó sẽ làm sập logic ghi của ứng dụng.
Chính sách allkeys-lru: Đây là khuyến nghị hàng đầu cho tầng bộ nhớ đệm. Khi bộ nhớ chạm trần, Redis sẽ tự động quét và giải phóng các khóa ít được sử dụng nhất trong thời gian gần đây trên toàn bộ không gian khóa. Chính sách này đảm bảo các dữ liệu nóng luôn được giữ lại trong RAM, trong khi các dữ liệu nguội tự động bị đẩy ra ngoài để nhường chỗ cho dữ liệu mới.
Chính sách volatile-lru: Redis chỉ quét và dọn dẹp các khóa ít được sử dụng nhất trong số những khóa có cấu hình thời gian sống TTL. Các khóa không cài TTL sẽ được giữ lại vô thời hạn.
Chính sách allkeys-lfu: Dọn dẹp các khóa có tần suất truy cập thấp nhất, rất hiệu quả khi hệ thống có sự phân hóa rõ rệt giữa khóa cực nóng và khóa hiếm khi được gọi.
Bảng so sánh chi phí các giải pháp Redis managed và self-hosted
Tùy thuộc vào năng lực vận hành của đội ngũ kỹ sư và ngân sách dự án, doanh nghiệp có thể lựa chọn giữa việc tự cài đặt và quản trị Redis trên máy chủ ảo hoặc sử dụng các dịch vụ được quản trị hoàn toàn:
| Nhà cung cấp dịch vụ | Gói cấu hình RAM tiêu chuẩn | Chi phí ước tính hàng tháng | Tính năng tự động hóa | Mức độ phức tạp quản trị |
|---|---|---|---|---|
| Self-hosted (Hetzner / OVH Cloud) | 16GB RAM, 4 vCPU NVMe VPS | Khoảng $15 – $30 / tháng | Tự cấu hình Sentinel, Backup, Update | Rất cao; cần kỹ sư DevOps giàu kinh nghiệm |
| AWS ElastiCache for Redis | cache.r6g.large (13GB RAM, Multi-AZ) | Khoảng $120 – $180 / tháng | Tự động Failover, Backup tự động, Patching | Thấp; quản trị qua AWS Console và Terraform |
| Redis Cloud (Redis Ltd.) | Gói Pro 10GB RAM (99.999% SLA) | Khoảng $140 – $220 / tháng | Multi-Cloud, Active-Active, Auto-Scaling | Rất thấp; giải pháp tối ưu cho Enterprise |
| Upstash (Serverless Redis) | Tính theo lượt request ($0.2 / 100k lệnh) | Khoảng $5 – $50 / tháng (Pay-as-you-go) | Serverless hoàn toàn, tự động co giãn theo tải | Tối thiểu; phù hợp Edge Functions, Vercel |
Để quản lý trực quan hiệu năng và kiểm tra dung lượng các khóa bộ nhớ đệm trên máy chủ tự vận hành, bạn có thể tham khảo bài viết về các công cụ giao diện đồ họa quản lý Redis trên Linux nhằm trang bị các dashboard theo dõi trực quan và phát hiện sớm các khóa chiếm dụng nhiều bộ nhớ.
Kỹ thuật nén dữ liệu và tối ưu cấu trúc dữ liệu tiết kiệm bộ nhớ
Một chiến lược caching với redis tiết kiệm chi phí đòi hỏi đội ngũ kỹ sư phải tối ưu redis cache nhằm cắt giảm từ 40% đến 70% chi phí RAM, kỹ sư hệ thống cần áp dụng các kỹ thuật tinh chỉnh cấu trúc dữ liệu chuyên sâu:
Nén chuỗi JSON: Thay vì lưu trữ chuỗi JSON thô có kích thước lớn, hãy nén chuỗi dữ liệu trước khi đẩy vào Redis. Với thuật toán nén tốc độ cao, tốc độ xử lý chỉ mất vài chục microsecond nhưng giảm được hơn một nửa kích thước dữ liệu lưu trữ.
Tận dụng cấu trúc dữ liệu Hash: Khi lưu trữ các đối tượng có nhiều trường thuộc tính nhỏ, việc sử dụng Redis Hash giúp Redis nén toàn bộ đối tượng thành một mảng tuyến tính liên tục trong bộ nhớ, loại bỏ hoàn toàn các siêu dữ liệu con trỏ của từng khóa độc lập.
Rút ngắn tiền tố khóa: Tránh việc đặt tên khóa quá dài dòng. Việc sử dụng quy ước ngắn gọn chuẩn mực giúp tiết kiệm hàng trăm megabyte RAM khi hệ thống lưu trữ hàng chục triệu khóa trong cơ sở dữ liệu.
Ma trận ra quyết định kiến trúc caching theo quy mô hệ thống
Tùy thuộc vào quy mô lưu lượng truy cập, độ phức tạp của hạ tầng máy chủ và nguồn lực tài chính, kiến trúc sư phần mềm cần lựa chọn mô hình chiến lược caching với redis tương ứng nhằm tối đa hóa hiệu quả đầu tư mà không tạo ra sự phức tạp quá mức cần thiết.
Hệ thống đơn khối và ứng dụng khởi nghiệp
Quy mô tải: Dưới 1.000 QPS, lưu lượng truy cập tập trung vào giờ hành chính, hạ tầng chạy trên 1 đến 3 máy chủ đơn khối.
Mô hình khuyến nghị: Xây dựng một chiến lược caching với redis gọn nhẹ với máy chủ đơn lẻ kết hợp mô hình cache aside. Áp dụng chính sách allkeys-lru cho bộ nhớ, cài đặt TTL jittering cho mọi khóa.
Tham khảo thêm hướng dẫn chi tiết về cấu hình Redis cache trong Laravel để thiết lập kết nối an toàn và tận dụng tối đa các tiện ích có sẵn của framework.
Hệ thống phân tán và thương mại điện tử tải cao
Quy mô tải: Từ 5.000 đến 50.000 QPS, hệ thống phân tách thành hàng chục microservices chạy trên cụm container.
Mô hình khuyến nghị: Cụm Redis Sentinel hoặc Redis Cluster phân mảnh dữ liệu tự động. Kết hợp mô hình Cache-Aside cho đọc và Write-Behind qua hàng đợi cho các tác vụ đếm lượt.
Bắt buộc trang bị khóa phân tán Mutex để chống Cache Stampede, áp dụng kỹ thuật gắn thẻ khóa để làm sạch dữ liệu danh sách.
Hạ tầng dữ liệu lớn và tài chính đa vùng
Quy mô tải: Trên 100.000 QPS, dữ liệu phân tán trên nhiều trung tâm dữ liệu đa vùng địa lý.
Mô hình khuyến nghị: Kiến trúc Redis Enterprise cho phép ghi dữ liệu đồng thời ở cả hai miền địa lý mà không xảy ra xung đột dữ liệu.
Tự động hóa hoàn toàn chu trình vô hiệu hóa bộ nhớ đệm bằng kiến trúc Change Data Capture với Debezium, đảm bảo tính nhất quán dữ liệu xuyên suốt toàn cầu.
Checklist an toàn hạ tầng và các lưu ý kỹ thuật sống còn
Trước khi đưa bất kỳ một hệ thống bộ nhớ đệm nào vào vận hành chính thức trong môi trường sản xuất, đội ngũ phụ trách hạ tầng và kỹ sư phần mềm bắt buộc phải kiểm tra toàn diện danh mục tiêu chuẩn kỹ thuật dưới đây nhằm đảm bảo một chiến lược caching với redis an toàn tuyệt đối:
⚠️ Cảnh báo an toàn hệ thống: Bộ nhớ đệm không bao giờ được phép xem là nơi lưu trữ dữ liệu vĩnh viễn. Mọi quyết định thiết kế phải dựa trên giả định rằng máy chủ Redis có thể bị sập hoặc bị xóa trắng dữ liệu bất kỳ lúc nào mà không được làm sụp đổ các chức năng cốt lõi của doanh nghiệp.
- 100% khóa phải có TTL: Tuyệt đối không lưu trữ bất kỳ khóa đệm nào mà không cấu hình thời gian sống TTL, trừ trường hợp các cấu trúc dữ liệu khóa phân tán có tiến trình giám sát gia hạn riêng biệt.
- Luôn áp dụng TTL jittering: Bổ sung thêm khoảng thời gian ngẫu nhiên từ 5% đến 15% vào giá trị TTL để ngăn chặn hiện tượng hàng triệu khóa cùng hết hạn một thời điểm.
- Cấu hình Maxmemory và Policy: Luôn đặt giá trị giới hạn bộ nhớ tối đa và thiết lập chính sách dọn dẹp khóa phù hợp cho tầng đệm.
- Bọc khối xử lý lỗi an toàn: Mọi thao tác kết nối và truy vấn Redis trong mã ứng dụng bắt buộc phải có cơ chế xử lý lỗi an toàn để chuyển hướng xuống Database khi Redis gặp sự cố.
- Kiểm soát kích thước khóa và giá trị: Giữ kích thước giá trị dưới 1MB. Với các tập dữ liệu lớn, phân chia thành nhiều khóa nhỏ hoặc nén dữ liệu trước khi lưu trữ.
- Tránh các lệnh chặn luồng nguy hiểm: Cấm tuyệt đối việc sử dụng lệnh quét toàn bộ khóa trên môi trường sản xuất. Luôn thay thế bằng lệnh quét phân trang để không chặn vòng lặp sự kiện.
- Thay thế DEL bằng UNLINK cho khóa lớn: Khi cần xóa các cấu trúc dữ liệu lớn, sử dụng lệnh UNLINK để Redis giải phóng bộ nhớ ngầm ở luồng phụ bất đồng bộ.
- Giám sát tỷ lệ trúng bộ nhớ đệm: Thiết lập cảnh báo tự động trên hệ thống giám sát khi tỷ lệ trúng đệm giảm xuống dưới 85%.
- Bảo vệ an ninh mạng tầng truyền tải: Đổi cổng mặc định, đặt mật khẩu phức tạp, vô hiệu hóa các lệnh nguy hiểm và kích hoạt mã hóa TLS khi giao tiếp qua mạng công cộng.
- Diễn tập kịch bản phục hồi thảm họa: Định kỳ thực hiện kiểm thử tình huống tắt máy chủ Redis đột ngột để kiểm tra xem hệ thống cơ sở dữ liệu chính có chịu đựng được lưu lượng suy thoái hay không.
Câu hỏi thường gặp về chiến lược caching với Redis
Có nên lưu trữ toàn bộ dữ liệu người dùng vào Redis thay cho database chính không?
Tuyệt đối không nên làm như vậy đối với các dữ liệu nghiệp vụ quan trọng. Redis bản chất là hệ thống lưu trữ in-memory được tối ưu cho tốc độ và bộ nhớ tạm. Mặc dù Redis có các cơ chế lưu trữ bền vững xuống đĩa cứng, nó không thể thay thế hoàn toàn các cơ sở dữ liệu quan hệ đạt chuẩn ACID trong việc quản trị giao dịch tiền tệ, tính toàn vẹn khóa ngoại và truy vấn phân tích phức tạp. Hãy duy trì cơ sở dữ liệu quan hệ làm nguồn sự thật và sử dụng Redis như một tầng đệm tăng tốc.
Nên chọn chính sách dọn dẹp maxmemory-policy nào cho tầng caching?
Đối với tầng bộ nhớ đệm thông thường, chính sách allkeys-lru là lựa chọn tối ưu và an toàn nhất. Chính sách này tự động giải phóng các khóa ít được sử dụng nhất trên toàn bộ hệ thống khi bộ nhớ chạm trần, đảm bảo các dữ liệu nóng thường xuyên được truy cập luôn nằm trọn trong RAM. Nếu bạn muốn giữ lại một số khóa cấu hình không có TTL và chỉ muốn dọn dẹp các khóa có cài thời gian sống, hãy lựa chọn chính sách volatile-lru.
Làm thế nào để xử lý hiện tượng Cache Penetration khi truy vấn ID không tồn tại?
Hiện tượng Cache Penetration xảy ra khi kẻ tấn công cố tình gửi liên tục các yêu cầu truy vấn những bản ghi không hề tồn tại trong hệ thống. Vì dữ liệu không có trong Redis, yêu cầu sẽ lao thẳng xuống Database để tìm kiếm; và vì Database cũng không có, không có dữ liệu nào được ghi ngược lại vào Redis. Lần truy vấn sau lại tiếp tục đánh thẳng vào database. Để hoàn thiện chiến lược caching với redis và khắc phục triệt để rủi ro này, bạn có thể áp dụng hai giải pháp: Một là lưu trữ giá trị rỗng vào Redis kèm TTL ngắn khoảng 30 đến 60 giây; Hai là sử dụng cấu trúc dữ liệu Bloom Filter đặt trước tầng đệm để từ chối ngay các ID không tồn tại.
Kỹ thuật hai lần xóa trễ trong bộ nhớ đệm hoạt động như thế nào?
Kỹ thuật hai lần xóa trễ được thiết kế nhằm giải quyết triệt để rủi ro dữ liệu sai lệch trong các hệ thống có độ trễ đồng bộ giữa máy chủ cơ sở dữ liệu chính và các máy chủ bản sao đọc. Quy trình diễn ra qua ba bước: Bước 1, ứng dụng xóa khóa trong Redis; Bước 2, ứng dụng cập nhật dữ liệu vào cơ sở dữ liệu chính; Bước 3, ứng dụng đẩy một tác vụ nền để thực hiện việc xóa khóa lần thứ hai sau một khoảng thời gian chờ khoảng 500ms. Lần xóa thứ hai này đảm bảo loại bỏ bất kỳ dữ liệu cũ nào mà một luồng đọc vô tình nạp từ nút bản sao lên trong khoảng thời gian dữ liệu đang đồng bộ.
Khi nào nên chuyển từ Redis đơn lẻ sang Redis Sentinel hoặc Redis Cluster?
Bạn nên nâng cấp lên Redis Sentinel khi hệ thống yêu cầu tính sẵn sàng cao: Sentinel cung cấp cơ chế giám sát tự động và thăng cấp một nút phụ lên làm nút chính trong vòng vài giây nếu nút chính gặp sự cố, giúp dịch vụ không bị gián đoạn. Trong khi đó, bạn chỉ cần nâng cấp lên Redis Cluster khi dung lượng tập dữ liệu bộ nhớ đệm vượt quá giới hạn RAM của một máy chủ vật lý đơn lẻ, hoặc khi thông lượng truy vấn vượt quá năng lực xử lý của một nhân CPU duy nhất và cần phân mảnh dữ liệu trên nhiều nút mạng.
Kết luận và định hướng kiến trúc bộ nhớ đệm bền vững
Xây dựng một chiến lược caching với redis chuẩn xác và có kỷ luật là một trong những quyết định đầu tư kiến trúc mang lại tỷ suất sinh lời cao nhất cho mọi hệ thống phần mềm hiện đại. Sự chuyển dịch từ việc phụ thuộc hoàn toàn vào các truy vấn đĩa cứng sang việc khai thác triệt để sức mạnh xử lý siêu tốc của bộ nhớ RAM in-memory không chỉ nâng tầm trải nghiệm của người dùng cuối với độ trễ phản hồi cực thấp, mà còn tạo ra một lá chắn bảo vệ vững chắc giúp cơ sở dữ liệu quan hệ tồn tại an toàn trước những cơn bão lưu lượng truy cập khổng lồ.
Bằng cách nắm vững nguyên lý vận hành của mô hình cache aside, hiểu rõ các trường hợp ứng dụng chuyên biệt của Write-Through và Write-Behind, thiết lập quy trình tự động hóa nhằm xử lý cache invalidation qua các kiến trúc hiện đại như Change Data Capture, và trang bị đầy đủ các phòng tuyến kỹ thuật nhằm chống cache stampede như khóa phân tán hay thuật toán xfetch, đội ngũ kỹ sư của bạn hoàn toàn có thể tự tin vận hành các nền tảng công nghệ quy mô lớn với độ tin cậy và tính sẵn sàng cao nhất.
Hãy bắt đầu rà soát lại toàn bộ kiến trúc bộ nhớ đệm trong hệ thống của bạn ngay hôm nay: kiểm tra lại cấu hình thời gian sống TTL trên từng nhóm dữ liệu, bổ sung khoảng ngẫu nhiên TTL jittering để làm phẳng biểu đồ tải, và chuẩn hóa quy trình xóa khóa khi cập nhật dữ liệu. Một hệ thống phần mềm chỉ thực sự đạt đến độ hoàn mỹ khi mọi tầng công nghệ từ ứng dụng, bộ nhớ đệm đến cơ sở dữ liệu đều vận hành hài hòa và sẵn sàng ứng phó linh hoạt trước mọi thử thách về quy mô.
Khám phá thêm các cấu trúc dữ liệu chuyên sâu và hướng dẫn kỹ thuật chính thức từ nhà phát triển tại: tài liệu chính thức của Redis.