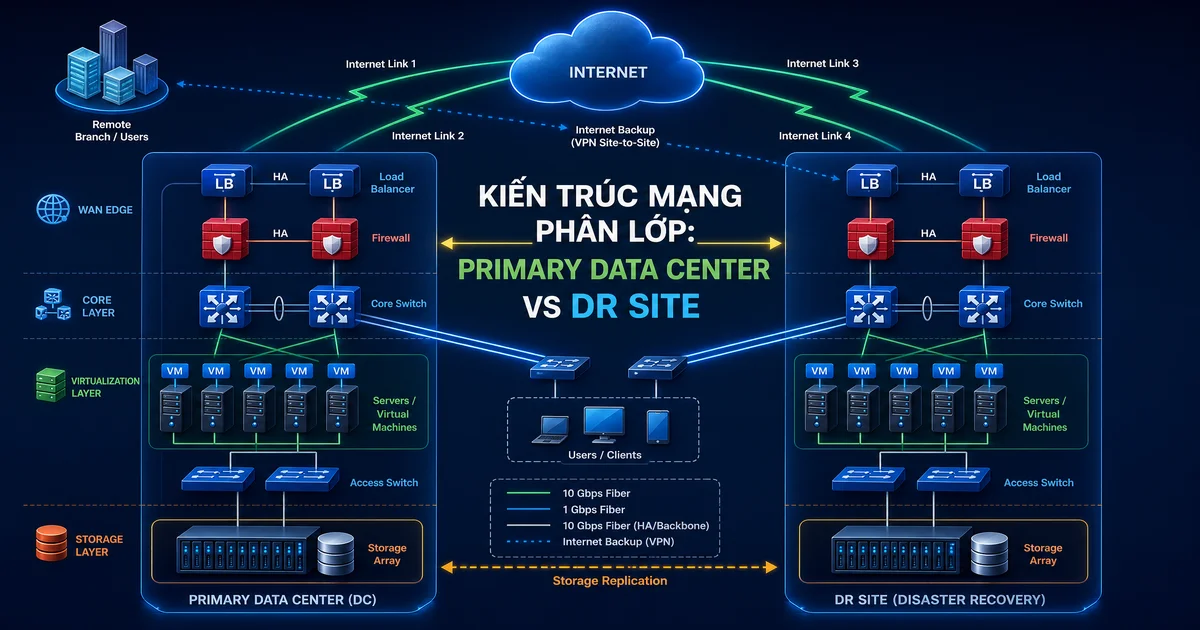
Một kiến trúc mạng Data Center chuẩn mực không đơn thuần là gom các tủ rack chứa switch và server lại với nhau rồi cắm dây mạng. Khi một sự cố mất điện nguồn hay đứt cáp quang huyết mạch xảy ra, mỗi phút hệ thống tê liệt đều được tính bằng tổn thất tài chính khổng lồ. Để đạt trạng thái sẵn sàng 24/7, việc xây dựng kiến trúc mạng Data Center kết hợp trung tâm dự phòng Disaster Recovery Site là yêu cầu sống còn của mọi hệ thống cấp doanh nghiệp.
Nhiều bạn thường nghĩ rằng chỉ cần mua thiết bị đắt tiền và hai đường Internet là có thể yên tâm. Thực tế thì sự cố luôn tìm đến những lỗ hổng tiềm ẩn: nghẽn cổ chai tại core switch, vòng lặp định tuyến ngầm, mất đồng bộ storage hoặc kịch bản chuyển đổi dự phòng failover chưa từng được thử nghiệm. Bài viết này mình sẽ phân tích sâu từng lớp thành phần và chia sẻ kinh nghiệm thực chiến khi triển khai một kiến trúc mạng Data Center hoàn chỉnh.
Mô hình 4 lớp trong kiến trúc mạng Data Center hiện đại
Để dễ quản lý và cô lập sự cố, một kiến trúc mạng Data Center chuẩn doanh nghiệp luôn được phân chia theo cấu trúc phân tầng rõ rệt. Mỗi tầng đảm nhận một nhiệm vụ chuyên biệt, ngăn chặn lỗi ở tầng này lan sang tầng khác và tối ưu hóa hiệu năng truyền dẫn dữ liệu.
Mô hình 4 lớp tiêu chuẩn bao gồm:
- WAN Edge Layer (Lớp biên kết nối): Đóng vai trò cửa ngõ giao tiếp giữa kiến trúc mạng Data Center với mạng diện rộng, các chi nhánh văn phòng, đối tác bên ngoài và mạng Internet công cộng qua các giao thức định tuyến động.
- Core & Security Layer (Lớp lõi và an ninh mạng): Trái tim điều phối lưu lượng nội bộ với thông lượng cực cao, tích hợp hệ thống tường lửa thế hệ mới và các bộ cân bằng tải ứng dụng.
- Virtualization Layer (Lớp ảo hóa máy chủ): Nền tảng tài nguyên tính toán cung cấp môi trường chạy máy ảo VM hoặc container với khả năng co giãn và di trú không gián đoạn dịch vụ.
- Storage Layer (Lớp lưu trữ chuyên dụng): Hạ tầng mạng lưu trữ SAN hoặc NAS độc lập, bảo vệ dữ liệu với độ bền bỉ cao và tốc độ truy xuất cực nhanh.
Sự phối hợp nhịp nhàng giữa 4 lớp thành phần này tạo nên khung xương vững chắc cho toàn bộ kiến trúc mạng Data Center, tạo điều kiện thuận lợi để thiết lập liên kết đồng bộ sang trung tâm dự phòng.
Lớp 1: WAN Edge Layer trong kiến trúc mạng Data Center
Lớp WAN Edge là chốt chặn đầu tiên tiếp nhận lưu lượng từ bên ngoài vào trung tâm dữ liệu. Một thiết kế kiến trúc mạng Data Center chuyên nghiệp không bao giờ cho phép xuất hiện bất kỳ điểm nghẽn đơn lẻ nào tại cửa ngõ này.
Đường truyền chính MPLS và mạng định tuyến BGP đa nhà mạng
Đối với lưu lượng nội bộ giữa trụ sở chính, các chi nhánh và kiến trúc mạng Data Center, kênh truyền thuê riêng MPLS qua cáp quang luôn là ưu tiên hàng đầu nhờ các đặc tính kỹ thuật vượt trội:
- Đảm bảo băng thông và chất lượng dịch vụ QoS: Lưu lượng thoại VoIP, hội nghị truyền hình và dữ liệu đồng bộ database được gán nhãn ưu tiên mức cao nhất, không bị chiếm dụng bởi lưu lượng tải web thông thường.
- Độ trễ thấp và ổn định: Đường truyền quang point-to-point khép kín cho phép độ trễ dưới 5ms trong nội thành và dưới 20ms liên tỉnh, yếu tố quyết định để giữ kết nối cluster.
- Bảo mật phân tách: Lưu lượng chạy hoàn toàn trong mạng riêng của nhà mạng viễn thông, cách ly vật lý và logic khỏi rủi ro tấn công từ Internet công cộng.
Đối với kết nối Internet, kiến trúc mạng Data Center sử dụng giao thức định tuyến BGP kết nối đa nhà mạng. Doanh nghiệp sở hữu dải IP độc lập để quảng bá đồng thời tới ít nhất hai nhà mạng ISP khác nhau. Khi một nhà mạng gặp sự cố đứt cáp hoặc bảo trì định kỳ, BGP tự động tái định tuyến lưu lượng sang đường truyền còn lại trong vài chục giây.
Đường truyền dự phòng Internet IPsec VPN Site-to-Site
Kênh truyền MPLS dù cao cấp đến đâu vẫn tiềm ẩn nguy cơ đứt sợi quang do thi công công trình. Do đó, trong kiến trúc mạng Data Center luôn bố trí kênh truyền dự phòng Internet VPN Site-to-Site chạy ngầm. Cơ chế IPsec VPN được mã hóa chuẩn AES-GCM 256-bit, sẵn sàng tiếp quản gói tin ngay lập tức khi phát hiện kênh MPLS mất tín hiệu.
! Cau hinh route failover tren Edge Router su dung IP SLA
ip sla 10
 icmp-echo 10.254.1.1 source-interface GigabitEthernet0/0/0
 threshold 200
 timeout 1000
 frequency 3
ip sla schedule 10 life forever start-time now

track 1 ip sla 10 reachability

! Dinh tuyen uu tien qua MPLS khi SLA tot
ip route 172.16.0.0 255.240.0.0 10.254.1.1 track 1
! Dinh tuyen du phong qua IPsec VPN tunnel khi MPLS rot
ip route 172.16.0.0 255.240.0.0 192.168.200.2 200
Đoạn cấu hình mẫu trên sử dụng kỹ thuật IP SLA để liên tục giám sát trạng thái đường truyền chính. Nếu đường truyền chính không phản hồi sau 3 nhịp kiểm tra, router tự động chuyển bảng định tuyến sang đường hầm VPN dự phòng mà quản trị viên không cần can thiệp thủ công.
Lớp 2: Core Layer trong kiến trúc mạng Data Center
Bước qua cửa ngõ biên, lưu lượng sẽ đi vào lớp lõi của kiến trúc mạng Data Center. Tại đây, mọi luồng dữ liệu nội bộ và dữ liệu truy cập từ bên ngoài vào đều phải được định tuyến tốc độ cao và kiểm soát an ninh nghiêm ngặt.
Chuyển đổi từ mô hình 3 tầng sang Spine-Leaf
Trong các thiết kế trước đây, mô hình 3 tầng dựa vào giao thức STP để chặn vòng lặp loop. Điểm yếu của STP là nó phải khóa một nửa số đường kết nối dự phòng, gây lãng phí băng thông và thời gian hội tụ khi đứt cáp có thể mất tới 30-50 giây. Bạn có thể tham khảo chi tiết về các nguyên lý mạng ảo trong bài viết hướng dẫn cấu hình mạng VLAN và Bridge trên blog vnhte để hiểu rõ hơn cách quản lý phân đoạn mạng.
Các kiến trúc mạng Data Center hiện đại ngày nay hầu hết đã chuyển dịch sang kiến trúc Spine-Leaf. Trong mô hình này, mọi switch Leaf đều kết nối tới tất cả các switch Spine. Kết hợp với giao thức BGP EVPN và đóng gói VXLAN, toàn bộ đường truyền đều hoạt động đồng thời thông qua công nghệ ECMP. Băng thông được tận dụng 100%, độ trễ giữa hai server bất kỳ trong trung tâm dữ liệu luôn giữ mức hằng số tối thiểu chỉ qua đúng hai bước nhảy hop.
Cụm tường lửa Firewall High Availability
Một thiết kế an ninh vững chắc cho kiến trúc mạng Data Center đòi hỏi cụm tường lửa Next-Gen Firewall phải được triển khai theo cặp High Availability với liên kết Heartbeat chuyên dụng qua cáp quang độc lập. Khi đó bảng trạng thái phiên kết nối của kiến trúc mạng Data Center được đồng bộ liên tục từng mili-giây.
- Cơ chế Active-Passive: Thiết bị chính xử lý toàn bộ lưu lượng, thiết bị phụ nhận dữ liệu đồng bộ trạng thái. Khi thiết bị chính gặp sự cố phần cứng, thiết bị phụ lập tức thế chỗ trong thời gian dưới 1 giây mà người dùng không hề bị đứt phiên tải file hay mất session đăng nhập.
- Cơ chế Active-Active: Cả hai tường lửa cùng tham gia định tuyến và kiểm tra gói tin, tăng gấp đôi lưu lượng xử lý đồng thời cho kiến trúc mạng Data Center. Tuy nhiên, việc chia sẻ trạng thái phiên giữa hai node đòi hỏi đường truyền liên kết HA có băng thông rất rộng để tránh tình trạng packet out-of-order.
# Cau hinh cuong buc dong bo Session tren FortiGate HA
config system ha
    set group-id 55
    set group-name DC-CORE-FW-HA
    set mode a-p
    set password "KhoaBaoMatDongBo123"
    set hbdev "port7" 100 "port8" 50
    set session-pickup enable
    set session-pickup-connectionless enable
    set ha-uptime-diff-margin 300
    set override disable
end
Tầng cân bằng tải Load Balancing và tối ưu hóa ứng dụng
Nằm ngay sau cụm tường lửa là các thiết bị cân bằng tải phần cứng hoặc phần mềm chuyên dụng. Bộ cân bằng tải trong kiến trúc mạng Data Center chịu trách nhiệm giải phóng tải tính toán cho máy chủ ứng dụng bằng cách thực hiện SSL Offloading, nén dữ liệu và duy trì kết nối persistent connection.
Bộ cân bằng tải chủ động gửi các gói tin Health Check sâu vào ứng dụng qua đường dẫn kiểm tra sức khỏe. Nếu một node backend phản hồi chậm hoặc trả về mã lỗi HTTP 500, nó sẽ bị cô lập khỏi luồng phân phối traffic ngay lập tức, ngăn ngừa hiện tượng lan truyền lỗi theo dây chuyền trong kiến trúc mạng Data Center.
Lớp 3: Virtualization Layer trong kiến trúc mạng Data Center
Trong tiến trình phát triển kiến trúc mạng Data Center, thời đại máy chủ vật lý chạy đơn lẻ một ứng dụng duy nhất đã lùi vào dĩ vãng. Lớp ảo hóa trong kiến trúc mạng Data Center cung cấp khả năng đóng gói toàn bộ hệ điều hành, thư viện và mã nguồn vào các máy ảo độc lập, tối ưu hóa việc khai thác CPU và RAM vật lý.
Hạ tầng Compute Cluster và cơ chế chống Split-Brain
Các máy chủ tính toán được gom thành các cụm tính toán Cluster sử dụng VMware vSphere hoặc nền tảng Proxmox VE. Để tìm hiểu cách triển khai cụm ảo hóa đạt tiêu chuẩn dự phòng cao cấp, bạn có thể tham khảo bài viết về cấu hình High Availability cluster trên hệ thống Proxmox.
Trong một cụm cluster nhiều node, nguy cơ lớn nhất là lỗi phân tách mạng dẫn đến phân mảnh não (Split-Brain) — hiện tượng hai nhóm node không nhìn thấy nhau và cùng ghi dữ liệu lên ổ đĩa gây hỏng dữ liệu. Một kiến trúc mạng Data Center bài bản giải quyết vấn đề này bằng cơ chế Corosync Quorum trên mạng nội bộ riêng biệt và trang bị thiết bị giám sát QDevice đặt tại địa điểm độc lập.
Công nghệ Live Migration không gián đoạn dịch vụ
Khả năng Live Migration cho phép di dời một máy ảo đang vận hành từ server vật lý này sang server vật lý khác mà không làm mất kết nối TCP của khách hàng. Quá trình này diễn ra bằng cách copy trước toàn bộ bộ nhớ RAM nền, sau đó tạm dừng máy ảo trong vài mili-giây để copy phần RAM thay đổi cuối cùng và đổi cổng switch ảo.
Để Live Migration diễn ra mượt mà không gây nghẽn dịch vụ, kiến trúc mạng Data Center luôn bố trí một dải mạng VLAN chuyên biệt với đường truyền quang 10Gbps hoặc 25Gbps chỉ dành cho lưu lượng di trú máy ảo. Mạng này hoàn toàn cách ly với luồng truy cập của khách hàng để đảm bảo an ninh thông tin và tốc độ truyền tải tối đa.
Lớp 4: Storage Fabric Layer trong kiến trúc mạng Data Center
Trong kiến trúc mạng Data Center, lớp lưu trữ là nơi bảo vệ tài sản quý giá nhất của mọi tổ chức: dữ liệu. Tại đây, kiến trúc mạng Data Center phải đảm bảo được hai tiêu chí quan trọng: tốc độ phản hồi cực nhanh với độ trễ dưới 1 mili-giây và độ tin cậy tuyệt đối không thể mất mát dữ liệu.
Cấu trúc mạng lưu trữ SAN và giao thức NVMe-oF
Thay vì sử dụng ổ đĩa gắn trực tiếp, trung tâm dữ liệu cấp doanh nghiệp luôn tách mạng lưu trữ thành một Storage Area Network riêng biệt. Các công nghệ kết nối chủ đạo trong kiến trúc mạng Data Center gồm:
- Fibre Channel (FC): Mạng cáp quang chuyên dụng chạy tốc độ 16Gbps hoặc 32Gbps qua switch FC chuyên dụng, loại bỏ hoàn toàn hiện tượng drop gói tin.
- iSCSI qua 10GbE/25GbE: Tận dụng hạ tầng cáp Ethernet tiêu chuẩn nhưng sử dụng khung Jumbo Frame MTU 9000 để giảm tải cho CPU máy chủ.
- NVMe over Fabrics (NVMe-oF): Xu hướng tận dụng công nghệ RDMA đưa dữ liệu trực tiếp từ ổ đĩa NVMe từ xa vào RAM của server tính toán mà không qua tầng kernel, mang lại hiệu năng cực cao cho kiến trúc mạng Data Center.
Bảo vệ đĩa cứng với cấu hình mảng RAID chuyên dụng
Trên các hệ thống lưu trữ SAN/NAS, việc lựa chọn cấu hình mảng đĩa RAID ảnh hưởng trực tiếp đến hiệu năng ghi ngẫu nhiên và khả năng sống sót khi ổ đĩa gặp sự cố phần cứng:
| Chuẩn RAID | Khả năng chịu lỗi đĩa | Hiệu năng đọc / ghi | Mục đích sử dụng tối ưu |
|---|---|---|---|
| RAID 10 | Chịu lỗi 1 đĩa mỗi cặp mirror | Đọc rất cao, Ghi cực nhanh | Hệ quản trị cơ sở dữ liệu OLTP, SQL, Oracle |
| RAID 6 | Chịu lỗi tối đa 2 đĩa bất kỳ | Đọc nhanh, Ghi trung bình | Lưu trữ dữ liệu tệp tin, File Server, VM OS disks |
| RAID-TP | Chịu lỗi tối đa 3 đĩa đồng thời | Đọc tốt, Ghi chậm hơn RAID 6 | Mảng đĩa dung lượng khổng lồ với ổ HDD SAS lớn |
| Erasure Coding | Tùy biến số block phân tán | Phân tán cao, chịu lỗi node mạng | Hệ thống Object Storage S3, Ceph, MinIO |
Thực tế vận hành cho thấy, việc xây dựng kiến trúc mạng Data Center chỉ giải quyết được các sự cố phần cứng cục bộ bên trong một tòa nhà. Nếu toàn bộ tòa nhà bị ngập nước, cháy nổ hoặc động đất, giải pháp duy nhất để bảo toàn dữ liệu là một trung tâm dữ liệu dự phòng đặt ở vị trí địa lý khác biệt.
Cầu nối giữa Data Center chính và Disaster Recovery Site
Một Disaster Recovery Site là bản sao của trung tâm dữ liệu chính, được đặt cách xa từ hàng chục đến hàng trăm kilomet để đảm bảo an toàn trước thảm họa diện rộng. Khoảng cách địa lý càng xa thì an toàn thiên tai càng cao, nhưng đi kèm với đó là bài toán vật lý khắc nghiệt về độ trễ truyền dẫn ánh sáng trên sợi quang.
Quy luật vật lý về độ trễ ánh sáng là thứ không thể phá vỡ: cứ mỗi 100km cáp quang, độ trễ RTT tăng thêm khoảng 1ms. Đây chính là yếu tố quyết định lựa chọn phương thức đồng bộ dữ liệu giữa hai site trong kiến trúc mạng Data Center.
Hai trung tâm dữ liệu liên kết với nhau thông qua hai đường trục kết nối riêng biệt: đường kết nối mạng Data Center Interconnect và đường đồng bộ dữ liệu Storage Replication của kiến trúc mạng Data Center.
Cơ chế đồng bộ dữ liệu Storage Replication
Kỹ thuật Storage Replication giữa Primary DC và Disaster Recovery Site được chia làm hai hình thức cốt lõi:
- Synchronous Replication (Đồng bộ thời gian thực): Khi ứng dụng thực hiện lệnh ghi, dữ liệu phải được ghi vào ổ đĩa của cả Primary Site và Disaster Recovery Site xong xuôi thì mới phản hồi cho ứng dụng là thành công. Phương pháp này đảm bảo không mất mát dữ liệu, nhưng đòi hỏi khoảng cách cáp quang dưới 60-80km và độ trễ RTT dưới 5ms.
- Asynchronous Replication (Đồng bộ bất đồng bộ): Dữ liệu được ghi ngay vào Primary Site rồi phản hồi cho ứng dụng, sau đó mảng lưu trữ đóng gói dữ liệu thay đổi và đẩy sang Disaster Recovery Site theo chu kỳ. Phương pháp này áp dụng cho các site cách xa hàng trăm kilomet trong kiến trúc mạng Data Center.
Bên cạnh việc đồng bộ tầng mảng lưu trữ cho kiến trúc mạng Data Center, các doanh nghiệp cũng cần trang bị hệ thống backup độc lập để chống lại mã độc tống tiền. Bạn có thể tham khảo thêm giải pháp Proxmox Backup Server để xây dựng cơ chế sao lưu dữ liệu bất biến và tối ưu dung lượng lưu trữ.
So sánh mô hình Active-Active và Active-Standby
Khi tích hợp trung tâm dự phòng vào kiến trúc mạng Data Center, quyết định mang tính chiến lược lớn nhất chính là chọn lựa giữa hai phương án: Active-Active và Active-Standby.
Mô hình Active-Standby (Chủ động – Chờ sẵn)
Trong mô hình này, Primary Data Center gánh 100% lưu lượng sản xuất của người dùng. Trung tâm Disaster Recovery Site luôn trong trạng thái trực chiến: máy chủ tính toán có thể bật sẵn hoặc ở chế độ chờ, dữ liệu được liên tục đồng bộ nhưng không phục vụ truy vấn của người dùng.
- Ưu điểm: Thiết kế kiến trúc mạng Data Center đơn giản, tránh hoàn toàn nguy cơ xung đột bản ghi dữ liệu hoặc chia cắt giao dịch tài chính, chi phí bản quyền phần mềm thường tiết kiệm hơn.
- Nhược điểm: Lãng phí một lượng lớn tài nguyên phần cứng tại Disaster Recovery Site khi bình thường không được dùng đến; quá trình chuyển giao failover cần thời gian kích hoạt dịch vụ.
Mô hình Active-Active (Song song hai trung tâm)
Ở mô hình này, cả hai Data Center đều đồng thời tiếp nhận và phục vụ người dùng cuối. Lưu lượng có thể được phân bổ theo vị trí địa lý của khách hàng thông qua công nghệ Anycast BGP hoặc máy chủ tên miền định vị GeoDNS. Nếu đang tìm hiểu cách thức vận hành của tầng định vị tên miền, bạn nên tham khảo bài viết hệ thống phân giải DNS để hiểu rõ cơ chế phân phối tải trên Internet.
| Tiêu chí đánh giá | Mô hình Active-Standby | Mô hình Active-Active |
|---|---|---|
| Hiệu suất sử dụng tài nguyên | 50% (Site phụ không phục vụ traffic chính) | 100% (Cả 2 site cùng chia sẻ lưu lượng) |
| Thời gian gián đoạn khi có sự cố | Vài phút đến vài giờ (cần thời gian failover) | Gần như bằng 0 (chuyển hướng mạng tức thì) |
| Độ phức tạp cơ sở dữ liệu | Thấp (Replication 1 chiều Master-Slave) | Rất cao (Distributed Multi-Master Database) |
| Yêu cầu hạ tầng mạng DCI | Băng thông trung bình, chấp nhận độ trễ | Băng thông cực lớn, độ trễ cực thấp dưới 5ms |
| Chi phí đầu tư và vận hành | Trung bình | Rất cao (gấp 2-3 lần) |
Chọn mô hình nào trong kiến trúc mạng Data Center hoàn toàn phụ thuộc vào bản chất nghiệp vụ và ngân sách của doanh nghiệp. Để lượng hóa sự đánh đổi trong kiến trúc mạng Data Center một cách khoa học, chúng ta bắt buộc phải sử dụng đến hai thước đo tiêu chuẩn: chỉ số RTO và RPO.
Đo lường năng lực phục hồi qua chỉ số RTO và RPO
Trong bất kỳ đề án thiết kế kiến trúc mạng Data Center nào, các kỹ sư trưởng và ban giám đốc bắt buộc phải thống nhất được hai chỉ số mục tiêu cốt lõi:
- RTO (Recovery Time Objective): Thời gian gián đoạn tối đa cho phép kể từ khi thảm họa ập đến cho tới lúc hệ thống phục hồi hoàn toàn để người dùng tiếp tục giao dịch. Ví dụ: RTO = 30 phút có nghĩa là toàn bộ quy trình nhận diện, kích hoạt Disaster Recovery Site và điều hướng mạng phải hoàn tất trong vòng 30 phút.
- RPO (Recovery Point Objective): Dung sai dữ liệu tối đa chấp nhận bị mất mát, tính theo thời gian. Ví dụ: Nếu hệ thống đồng bộ dữ liệu snapshot mỗi 15 phút một lần và gặp sự cố ở phút thứ 14, doanh nghiệp sẽ mất trắng dữ liệu phát sinh trong 14 phút đó, tương ứng RPO = 15 phút.
Phân cấp nghiệp vụ doanh nghiệp theo chuẩn RTO và RPO
Không có một doanh nghiệp nào có đủ ngân sách để đưa tất cả ứng dụng đạt mức RTO = 0 và RPO = 0 trong kiến trúc mạng Data Center. Do đó, phương pháp tiếp cận chuyên nghiệp theo hướng dẫn lập kế hoạch dự phòng NIST SP 800-34 là phân loại dịch vụ theo các mức độ ưu tiên nghiệp vụ rõ ràng:
| Cấp độ nghiệp vụ | Ví dụ ứng dụng thực tế | Mục tiêu RTO | Mục tiêu RPO | Giải pháp áp dụng |
|---|---|---|---|---|
| Mission-Critical | Core Banking, Cổng thanh toán, Chứng khoán | 0 – 5 phút | RPO = 0 | Active-Active, Synchronous Storage Replication |
| Business-Critical | Hệ thống ERP, CRM, Quản lý kho vận | 15 phút – 2 giờ | Dưới 15 phút | Active-Standby tự động, Async Storage Replication |
| Business-Operational | Mail Server nội bộ, Chấm công, File server | 4 giờ – 24 giờ | 1 giờ – 4 giờ | Chuyển đổi bán tự động, Snapshot backup định kỳ |
| Non-Critical | Môi trường Test, UAT, Đào tạo nội bộ | 24 giờ – 72 giờ | 12 giờ – 24 giờ | Khôi phục từ bản sao lưu offsite |
Kịch bản chuyển đổi Failover 4 bước khi thảm họa xảy ra
Một bản thiết kế kiến trúc mạng Data Center dù hoàn hảo trên giấy tờ nhưng nếu không xây dựng sẵn quy trình chuyển đổi tự động thì khi sự cố ập đến vào ban đêm, thảm họa sẽ nhân lên gấp bội. Dưới đây là chuỗi phản ứng 4 bước tiêu chuẩn đã được chuẩn hóa cho kiến trúc mạng Data Center:
Bước 1: Giám sát liên tục và phát hiện sự cố tự động
Hệ thống giám sát trung tâm kết hợp các công cụ chuyên dụng gửi tín hiệu Heartbeat theo chu kỳ mỗi 1-3 giây giữa hai site. Một sự cố chỉ được xác nhận là thảm họa thực sự khi thỏa mãn đồng thời hai điều kiện: kênh truyền mạng bị mất hoàn toàn và các thiết bị quản lý out-of-band không phản hồi sau một số ngưỡng thời gian nhất định trong kiến trúc mạng Data Center. Việc này nhằm loại trừ hiện tượng báo động giả do chập chờn mạng thoáng qua.
Bước 2: Kích hoạt chuyển đổi định tuyến mạng (Network Failover)
Ngay khi sự cố tại Primary Site được xác nhận, hệ thống tự động kích hoạt kịch bản điều phối mạng. Các router biên tại Disaster Recovery Site thực hiện rút cờ quảng bá mạng của Site chính và gửi gói tin cập nhật BGP Update với độ ưu tiên cao hơn ra toàn bộ các ISP đối tác của kiến trúc mạng Data Center.
Đồng thời, hệ thống cân bằng tải toàn cầu chuyển đổi bản ghi DNS, hạ TTL xuống mức 30 giây để hướng toàn bộ yêu cầu từ trình duyệt của người dùng sang dải địa chỉ IP công cộng của Disaster Recovery Site.
Bước 3: Bật tải ứng dụng và mount storage tại DR Site
Tại trung tâm dự phòng, các mảng lưu trữ SAN tự động phá vỡ liên kết Replication để chuyển ổ đĩa từ trạng thái Read-Only sang trạng thái Read-Write bình thường. Sau đó:
- Các cụm ảo hóa nhận diện Datastore mới và kích hoạt script khởi động máy ảo theo thứ tự ưu tiên: Cơ sở dữ liệu khởi động trước, sau đó đến máy chủ backend và cuối cùng là máy chủ frontend.
- Cụm cân bằng tải nội bộ tại DR Site tiến hành kiểm tra sức khỏe các máy ảo vừa khởi động thành công và bắt đầu mở van phân phối lưu lượng truy cập trong kiến trúc mạng Data Center.
Bước 4: Kiểm soát sau sự cố và lập kế hoạch Failback
Khi hệ thống tại Disaster Recovery Site đã hoạt động ổn định, ban chỉ huy thảm họa bắt đầu ghi nhận log kiểm toán để đối soát dữ liệu. Nhiệm vụ quan trọng không kém nhưng thường bị bỏ qua là chuẩn bị kịch bản khôi phục ngược.
Khi Primary Data Center được cấp điện trở lại và xử lý xong sự cố, toàn bộ dữ liệu mới phát sinh tại DR Site trong thời gian thảm họa phải được đồng bộ đảo chiều ngược về Primary Site trước khi chuyển giao lưu lượng trở lại, tránh hiện tượng mất mát dữ liệu ngược dòng trong kiến trúc mạng Data Center.
Những sai lầm chí mạng cần tránh trong kiến trúc mạng Data Center
Dưới đây là những bài học xương máu mà mình đã từng chứng kiến hoặc trực tiếp xử lý sau những lần cứu hỏa hệ thống:
- Có DR Site nhưng không bao giờ diễn tập: Xây dựng trung tâm dự phòng tiêu tốn rất nhiều ngân sách nhưng cả năm không diễn tập chuyển đổi một lần. Đến khi sự cố thật xảy ra, mật khẩu admin bị quên, license hết hạn, bản vá phần mềm giữa hai bên lệch phiên bản khiến kiến trúc mạng Data Center không thể vận hành bình thường.
- Chung một đường cấp quang vật lý: Mua hai đường truyền mạng của hai nhà mạng khác nhau nhưng cả hai nhà mạng lại cùng thuê một tuyến cống cáp quang của bên thứ ba dưới lòng đường. Một sự cố đào đường làm đứt cống cáp là cả hai đường truyền cùng đứt một lúc.
- Bỏ quên việc đồng bộ cấu hình mạng: Khi kỹ sư mở một port trên tường lửa hoặc thêm một VLAN mới ở Site chính nhưng quên cập nhật tại Disaster Recovery Site. Khi failover xảy ra, ứng dụng tại DR Site bị chặn kết nối hoàn toàn.
- Băng thông replication bị tính toán thiếu: Lưu lượng ghi dữ liệu trong giờ cao điểm vượt quá dung lượng kênh truyền quang, khiến hàng đợi dữ liệu replication bị trễ hàng giờ, phá vỡ hoàn toàn chỉ số RTO và RPO đã cam kết trong kiến trúc mạng Data Center.
Tài liệu kỹ thuật tham khảo chính thức
Để tìm hiểu sâu hơn về các chuẩn mực thiết kế và thông số kỹ thuật chi tiết của các hãng công nghệ lớn trên thế giới, bạn có thể tham khảo thêm các tài liệu chính thức sau:
- Tổng quan hướng dẫn thiết kế hạ tầng mạng trung tâm dữ liệu tại tài liệu kiến trúc Cisco Data Center.
- Hướng dẫn cấu hình phân cụm HA và cơ chế vMotion tại tài liệu VMware vSphere.
- Mô hình thiết kế phục hồi thảm họa đa vùng khả dụng tại kiến trúc Disaster Recovery của AWS.
- Tiêu chuẩn kỹ thuật đóng gói mạng ảo hóa VXLAN tại tài liệu RFC 7348 của IETF.
Lời kết từ Cypher
Xây dựng một kiến trúc mạng Data Center bền bỉ không phải là cuộc đua về việc ai mua được thiết bị đắt tiền hơn, mà là sự thấu hiểu tường tận về các điểm nghẽn và khả năng kiểm soát rủi ro của người kiến trúc sư. Một hệ thống vận hành 24/7 thực thụ chỉ tồn tại khi bạn luôn chuẩn bị cho tình huống xấu nhất ngay từ khi đặt những viên gạch thiết kế đầu tiên.
Hãy nhớ rằng, thảm họa không hỏi bạn đã sẵn sàng hay chưa trước khi ập đến. Đầu tư vào quy trình diễn tập định kỳ và tối ưu hóa kiến trúc mạng Data Center ngày hôm nay chính là tấm bảo hiểm vững chắc nhất cho sự phát triển bền vững của doanh nghiệp trong tương lai.