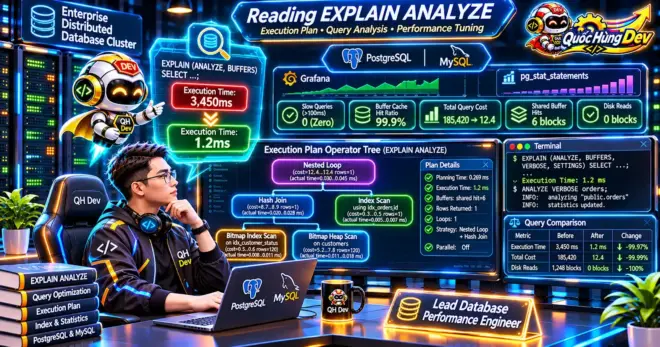
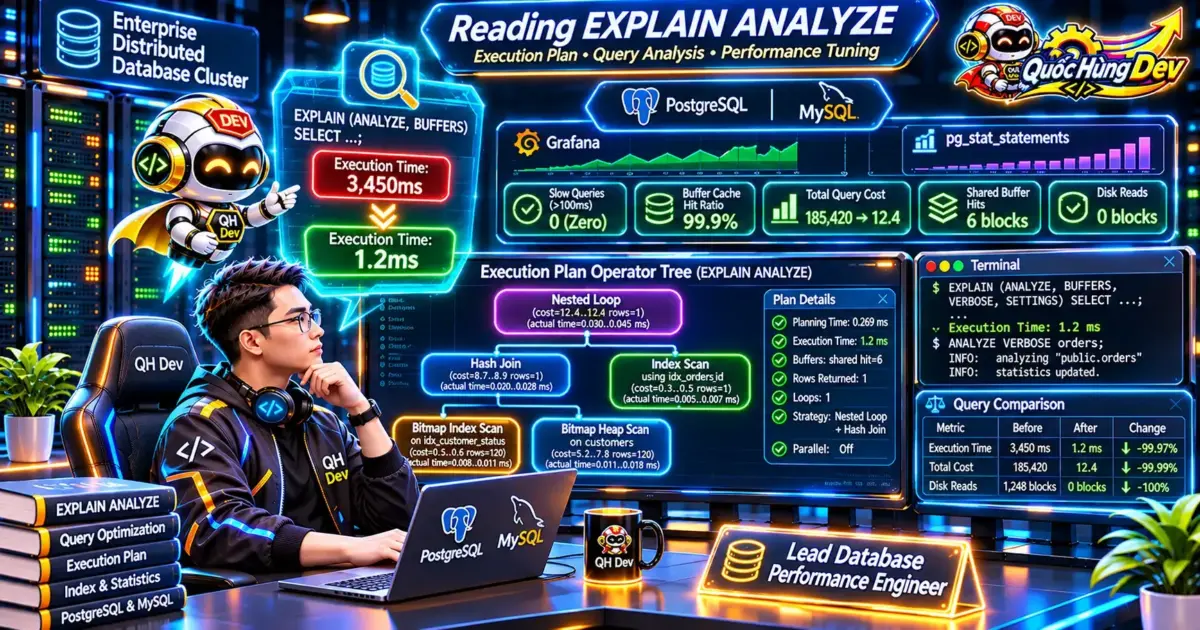
Kỹ năng đọc hiểu explain analyze là vũ khí tối thượng giúp mọi backend developer giải mã chính xác những gì đang thực sự diễn ra bên trong hạt nhân cơ sở dữ liệu thay vì tối ưu hóa dựa trên phỏng đoán. Một câu lệnh truy vấn có thể phản hồi chớp nhoáng dưới 10ms trên môi trường máy trạm, nhưng khi bước ra hạ tầng thực tế với hàng chục triệu bản ghi và hàng nghìn truy vấn đồng thời, câu lệnh đó có thể làm tê liệt toàn bộ hệ thống lưu trữ với thời gian phản hồi kéo dài hàng nghìn mili-giây.
Nhiều đội ngũ kỹ thuật khi đối mặt với tình trạng nghẽn database thường vội vã đánh thêm chỉ mục bừa bãi vào toàn bộ các cột trong mệnh đề WHERE hoặc nâng cấp máy chủ tốn kém. Cách tiếp cận chắp vá này không giải quyết tận gốc vấn đề, làm chậm các thao tác ghi INSERT, UPDATE và lãng phí bộ nhớ đệm. Nếu không nắm vững cách đọc execution plan, lập trình viên sẽ hoàn toàn mù mờ trước các quyết định của bộ tối ưu hóa chi phí CBO (Cost-Based Optimizer).
Bài viết này hướng dẫn chi tiết quy trình đọc hiểu explain analyze từ nền tảng lý thuyết đến phân tích thực chiến trên hai hệ quản trị PostgreSQL và MySQL. Chúng tôi sẽ mổ xẻ tường tận từng thông số chi phí startup cost, total cost, thời gian thực tế, các thuật toán quét dữ liệu vật lý và chiến lược phân bổ chỉ mục để bạn tự tin tối ưu truy vấn sql cho các hệ thống tải cao đạt hiệu năng vượt trội.
Định nghĩa bản chất công nghệ và nền tảng cốt lõi
Để xây dựng tư duy đọc hiểu explain analyze bài bản, trước hết chúng ta cần hiểu rõ vòng đời của một câu truy vấn SQL từ lúc gửi đi từ ứng dụng cho đến khi trả về tập kết quả dữ liệu. SQL là ngôn ngữ khai báo, nghĩa là lập trình viên chỉ mô tả dữ liệu mình muốn nhận qua các mệnh đề SELECT, FROM, WHERE, GROUP BY, chứ không trực tiếp chỉ định máy tính duyệt dữ liệu theo thuật toán nào.
Trách nhiệm chuyển đổi câu lệnh khai báo trừu tượng thành chuỗi thao tác phần cứng thuộc về bộ xử lý truy vấn nội bộ của database qua 4 giai đoạn nối tiếp nhau: Phân tích cú pháp (Parser), Viết lại truy vấn (Rewriter), Lập kế hoạch tối ưu (Optimizer/Planner), và Thực thi vật lý (Executor). Trong đó, bộ lập kế hoạch chi phí CBO đóng vai trò đầu não chiến lược, tính toán nhiều kịch bản duyệt dữ liệu khác nhau để chọn ra phương án có chi phí ước tính thấp nhất.
Mỗi phương án duyệt dữ liệu được biểu diễn dưới dạng cấu trúc cây phân cấp gồm các nút toán tử logic và vật lý, gọi là kế hoạch thực thi (Execution Plan). Mỗi nút trong cây đại diện cho một hành động dữ liệu đơn lẻ, ví dụ như đọc bảng dữ liệu từ đĩa, lọc hàng theo điều kiện logic, băm bảng vào bộ nhớ RAM, hoặc sắp xếp bản ghi. Dữ liệu chảy từ các nút lá ở đáy cây, được xử lý qua từng tầng trung gian, và dồn lên nút gốc để trả về cho người dùng.
Lệnh EXPLAIN là công cụ tiêu chuẩn cho phép lập trình viên khảo sát cây kế hoạch thực thi mà bộ tối ưu hóa đã lựa chọn. Nếu chỉ dùng lệnh EXPLAIN đơn thuần, cơ sở dữ liệu chỉ hiển thị dự đoán lý thuyết dựa trên siêu dữ liệu thống kê trong danh mục catalog. Nhưng khi bổ sung từ khóa ANALYZE, database engine thực sự kích hoạt bộ thực thi vật lý chạy câu truy vấn trên dữ liệu thực, đo lường chính xác từng mili-giây và từng khối bộ nhớ. Nắm vững tính chất ACID cũng là tiền đề quan trọng, bạn có thể xem thêm bài viết về transaction và ACID trong database để nắm vững kiến trúc dữ liệu nền tảng.
Bảng so sánh tổng quan nhanh và sơ đồ luồng

Trong quá trình điều tra hiệu năng cơ sở dữ liệu, việc chọn đúng cờ tham số khi thực thi lệnh EXPLAIN sẽ quyết định độ sâu và độ chính xác của dữ liệu thu thập được. Không phải lúc nào chúng ta cũng cần chạy toàn bộ các tùy chọn phân tích nặng nề trên hệ thống đang chịu tải cao. Bảng so sánh dưới đây đối chiếu chi tiết các chế độ phân tích lệnh EXPLAIN phổ biến trong thực tế để hỗ trợ cách đọc execution plan chuẩn xác nhất.
| Chế độ phân tích | Có thực thi câu query thật? | Chi phí tài nguyên I/O & CPU | Các chỉ số thu thập được | Ngữ cảnh khuyến nghị sử dụng |
|---|---|---|---|---|
| EXPLAIN thuần túy | Không thực thi | Gần như bằng 0 (chỉ đọc metadata) | Ước lượng cost, số dòng dự đoán, độ rộng byte | Kiểm tra nhanh lựa chọn index trên môi trường production chịu tải cao |
| EXPLAIN ANALYZE | Có thực thi câu lệnh thật | Tương đương hoặc cao hơn câu query thật | Thời gian thực tế (actual time), số dòng thực tế, số vòng lặp | Môi trường staging hoặc chẩn đoán truy vấn chậm cục bộ |
| EXPLAIN (ANALYZE, BUFFERS) | Có thực thi câu lệnh thật | Phát sinh chi phí đo đếm bộ đếm hạt nhân | Thêm thống kê shared read, shared hit, dirtied, written blocks | Tiêu chuẩn vàng để phát hiện nghẽn ổ đĩa và tràn bộ nhớ đệm RAM |
| EXPLAIN (ANALYZE, WAL) | Có thực thi câu lệnh thật | Phát sinh đo đếm nhật ký ghi trước | Ghi nhận lượng bản ghi và dung lượng byte ghi vào file WAL | Tối ưu hóa các thao tác ghi nặng INSERT, UPDATE, DELETE trong PostgreSQL |
| EXPLAIN FORMAT=JSON | Tùy chọn theo cờ đi kèm | Không đáng kể so với định dạng văn bản | Cung cấp cấu trúc dữ liệu JSON chi tiết đầy đủ thuộc tính | Tích hợp vào các công cụ phân tích tự động hoặc công cụ vẽ biểu đồ trực quan |
Sơ đồ luồng phân tích kế hoạch thực thi tiêu chuẩn luôn vận hành theo chu trình khép kín: Khởi tạo câu lệnh có bọc kiểm soát giao dịch an toàn -> Thu thập kết quả cây thực thi chi tiết kèm thống kê bộ nhớ đệm -> Định vị nút toán tử thắt cổ chai chiếm nhiều thời gian nhất -> Đưa ra giải pháp tái cấu trúc câu lệnh hoặc bổ sung chỉ mục tương ứng -> Đo lường đối chiếu lại sau tối ưu để thẩm định hiệu quả thực tế và bảo đảm tối ưu truy vấn sql thành công.
Điểm khác biệt cốt lõi giữa EXPLAIN và EXPLAIN ANALYZE
Sự nhầm lẫn phổ biến nhất của các lập trình viên mới làm quen với việc tinh chỉnh cơ sở dữ liệu là coi EXPLAIN và EXPLAIN ANALYZE là hai phiên bản tương đương của cùng một công cụ. Về bản chất kỹ thuật, sự khác biệt giữa hai lệnh này nằm ở ranh giới giữa việc dự đoán mô phỏng trên giấy và việc đưa hệ thống ra vận hành thực tế.
Khi bạn chỉ chạy lệnh EXPLAIN SELECT ..., công cụ tối ưu hóa truy vấn chỉ tra cứu các bảng thống kê nội bộ (như bảng pg_statistic trong PostgreSQL hoặc thông tin trong mysql.innodb_table_stats) để phỏng đoán xem bảng có bao nhiêu dòng, phân phối giá trị các cột ra sao, và chọn ra con đường đi dự kiến. Quá trình này diễn ra trong vài phần mười mili-giây vì database hoàn toàn không chạm vào các trang dữ liệu thực trên đĩa. Do đó, toàn bộ các chỉ số về chi phí và số dòng hiển thị đều chỉ là con số ước lượng.
Ngược lại, khi bạn thực hiện đọc hiểu explain analyze với câu lệnh thực tế, database engine thực sự khởi chạy toàn bộ quy trình đọc dữ liệu, nạp trang từ ổ đĩa vào RAM, thực hiện các phép so sánh bộ lọc, kết nối các bảng dữ liệu, và gom nhóm dữ liệu. Mỗi nút trong cây thực thi được gắn một đồng hồ đo thời gian có độ chính xác cao để ghi nhận thời điểm bắt đầu trả về dòng dữ liệu đầu tiên và thời điểm hoàn tất toàn bộ nút. Điều này đem lại thông tin vô giá về thời gian chạy thực tế (Actual Time) và số lượng bản ghi thực tế (Actual Rows), cho phép lập trình viên nhận biết ngay sự sai lệch giữa dự đoán của bộ lập kế hoạch và thực tế vận hành.
Một khía cạnh tối quan trọng khác là sự khác biệt giữa trạng thái bộ nhớ đệm nguội (Cold Cache) và bộ nhớ đệm ấm (Warm Cache). Trong lần chạy đầu tiên, dữ liệu có thể phải đọc trực tiếp từ các sector của ổ cứng vật lý qua lệnh gọi hệ thống. Nhưng từ lần chạy thứ hai trở đi, toàn bộ trang dữ liệu đã nằm sẵn trong bộ nhớ đệm Shared Buffers của database và Page Cache của hệ điều hành, khiến thời gian thực thi giảm đi đáng kể. Người làm kỹ thuật cần lưu ý điều này để không đưa ra những kết luận sai lệch về hiệu năng thật.
⚠️ Cảnh báo an toàn tuyệt đối trên production: Vì lệnh EXPLAIN ANALYZE thực sự chạy câu lệnh bên dưới hạt nhân, nếu bạn chạy lệnh này với các câu lệnh sửa đổi dữ liệu như UPDATE hoặc DELETE, dữ liệu của bạn sẽ bị thay đổi hoặc xóa bỏ vĩnh viễn trên cơ sở dữ liệu! Bắt buộc phải bọc câu lệnh trong một transaction có lệnh ROLLBACK an toàn như sau:
BEGIN; EXPLAIN ANALYZE DELETE FROM orders WHERE status = 'cancelled'; ROLLBACK;để kiểm tra hiệu năng mà không làm biến đổi trạng thái dữ liệu thực tế.
Phân tích kỹ thuật và cơ chế chuyên sâu về chi phí truy vấn
Một trong những bước then chốt nhất khi thực hiện phân tích chi phí query là hiểu rõ từng con số xuất hiện trong chuỗi ký tự hiển thị kế hoạch thực thi. Nhiều lập trình viên nhìn vào con số cost=0.00..452.10 và lầm tưởng rằng đó là số mili-giây, số phép toán CPU hoặc dung lượng bộ nhớ. Trên thực tế, cost là một đơn vị quy ước tương đối không có thứ nguyên vật lý, được tính toán dựa trên các tham số cấu hình phần cứng của hệ quản trị cơ sở dữ liệu.
Bản chất các tham số chi phí trong hoạch định tối ưu
Trong công thức của bộ tối ưu PostgreSQL, phân tích chi phí query được thiết lập chuẩn hóa dựa trên một thước đo cơ bản: seq_page_cost = 1.0, đại diện cho chi phí đọc tuần tự một trang đĩa 8KB từ ổ cứng. Từ đơn vị cơ sở này, các tham số khác được quy định theo tỷ lệ tương ứng nhằm phản ánh đúng bản chất vật lý của máy chủ:
- random_page_cost (mặc định 4.0): Chi phí đọc một trang đĩa ngẫu nhiên. Con số 4.0 phản ánh thời gian đầu đọc cơ học của ổ đĩa HDD phải di chuyển vị trí. Trên hệ thống máy chủ sử dụng ổ đĩa NVMe SSD tốc độ cao, giá trị này nên được cấu hình giảm xuống mức 1.1 đến 1.5 để bộ tối ưu ưu tiên sử dụng chỉ mục nhiều hơn.
- cpu_tuple_cost (mặc định 0.01): Chi phí của bộ vi xử lý CPU để kiểm tra và xử lý một hàng dữ liệu sau khi trang đĩa đã được nạp vào bộ nhớ RAM.
- cpu_index_tuple_cost (mặc định 0.005): Chi phí CPU để duyệt qua một mục chỉ mục trong cây B-Tree.
- cpu_operator_cost (mặc định 0.0025): Chi phí CPU để thực thi một toán tử logic hoặc biểu thức hàm trong mệnh đề WHERE hoặc SELECT.
Khi hiển thị trên cây kế hoạch, giá trị chi phí luôn có dạng cost=A..B. Trong đó, A là chi phí khởi động (Startup Cost) phản ánh công sức tiêu hao để lấy ra được bản ghi đầu tiên (ví dụ như chi phí xây dựng bảng băm Hash Table trước khi thực hiện phép Join). Còn B là tổng chi phí (Total Cost) phản ánh công sức tiêu hao để lấy ra toàn bộ các bản ghi của nút đó và chuyển giao lên nút cha. Khi thực hiện phân tích chi phí query cho các câu truy vấn có LIMIT nhỏ, một nút có Startup Cost thấp thường được bộ lập kế hoạch ưu tiên hơn dù Total Cost của nó có thể cao hơn.
Ý nghĩa thời gian thực tế và số vòng lặp loops
Bên cạnh phần ước lượng chi phí, phần thông tin đo lường thực tế trong kết quả khi đọc hiểu explain analyze cung cấp dữ liệu sống về câu truy vấn với cấu trúc: (actual time=X..Y rows=N loops=M). Đây là nơi thể hiện sự chênh lệch then chốt giữa lý thuyết và thực tiễn:
- actual time=X..Y: Đo bằng mili-giây (ms). Giá trị
Xlà thời gian trôi qua để nút bắt đầu nhả ra bản ghi đầu tiên, vàYlà thời gian hoàn tất nút đó cho một vòng lặp đơn lẻ. - rows=N: Số lượng hàng dữ liệu thực tế trung bình được nút đó sinh ra sau mỗi vòng lặp.
- loops=M: Số lần nút toán tử này được thực thi lặp lại trong suốt vòng đời của câu truy vấn. Thông số này cực kỳ phổ biến trong các thuật toán lặp Nested Loop Join hoặc Subplan phụ thuộc.
Một cái bẫy toán học rất lớn mà lập trình viên thường mắc phải khi đọc hiểu explain analyze là chỉ nhìn vào con số thời gian Y mà quên nhân với số lượng vòng lặp loops=M. Nếu một nút có actual time=0.012..0.085 ms nhưng số vòng lặp là loops=50000, thì tổng thời gian tiêu hao thực sự của nút đó trên hệ thống là 0.085 * 50000 = 4250 ms (hơn 4.2 giây). Việc bỏ quên số vòng lặp sẽ khiến bạn hoàn toàn phán đoán sai vị trí nút thắt cổ chai của hệ thống.
Đo lường dung lượng bộ nhớ đệm với tùy chọn BUFFERS
Mặc dù thời gian thực thi (actual time) là chỉ số trực quan nhất, con số này có thể biến động liên tục tùy thuộc vào tải CPU, xung đột luồng và trạng thái mạng tại thời điểm truy vấn. Chỉ số khách quan và ổn định nhất để đánh giá một câu truy vấn có được tối ưu tốt hay không chính là khối lượng I/O bộ nhớ đệm được đo đếm qua cờ BUFFERS:
EXPLAIN (ANALYZE, BUFFERS)
SELECT customer_id, count(id) as total_orders
FROM orders
WHERE status = 'completed' AND order_date >= CURRENT_DATE - INTERVAL '30 days'
GROUP BY customer_id;
Khi bật tùy chọn BUFFERS, database sẽ cung cấp thêm các dòng thống kê bộ nhớ chi tiết bên dưới mỗi nút toán tử bao gồm shared hit, shared read, shared dirtied và shared written. Để tìm hiểu cách thiết lập cấu hình tham số Shared Buffers và các thông số máy chủ PostgreSQL đạt chuẩn công nghiệp, bạn có thể tham khảo thêm hướng dẫn chi tiết về cách cấu hình server PostgreSQL chuẩn của chúng tôi.
So sánh các thuật toán quét dữ liệu trong hệ quản trị cơ sở dữ liệu
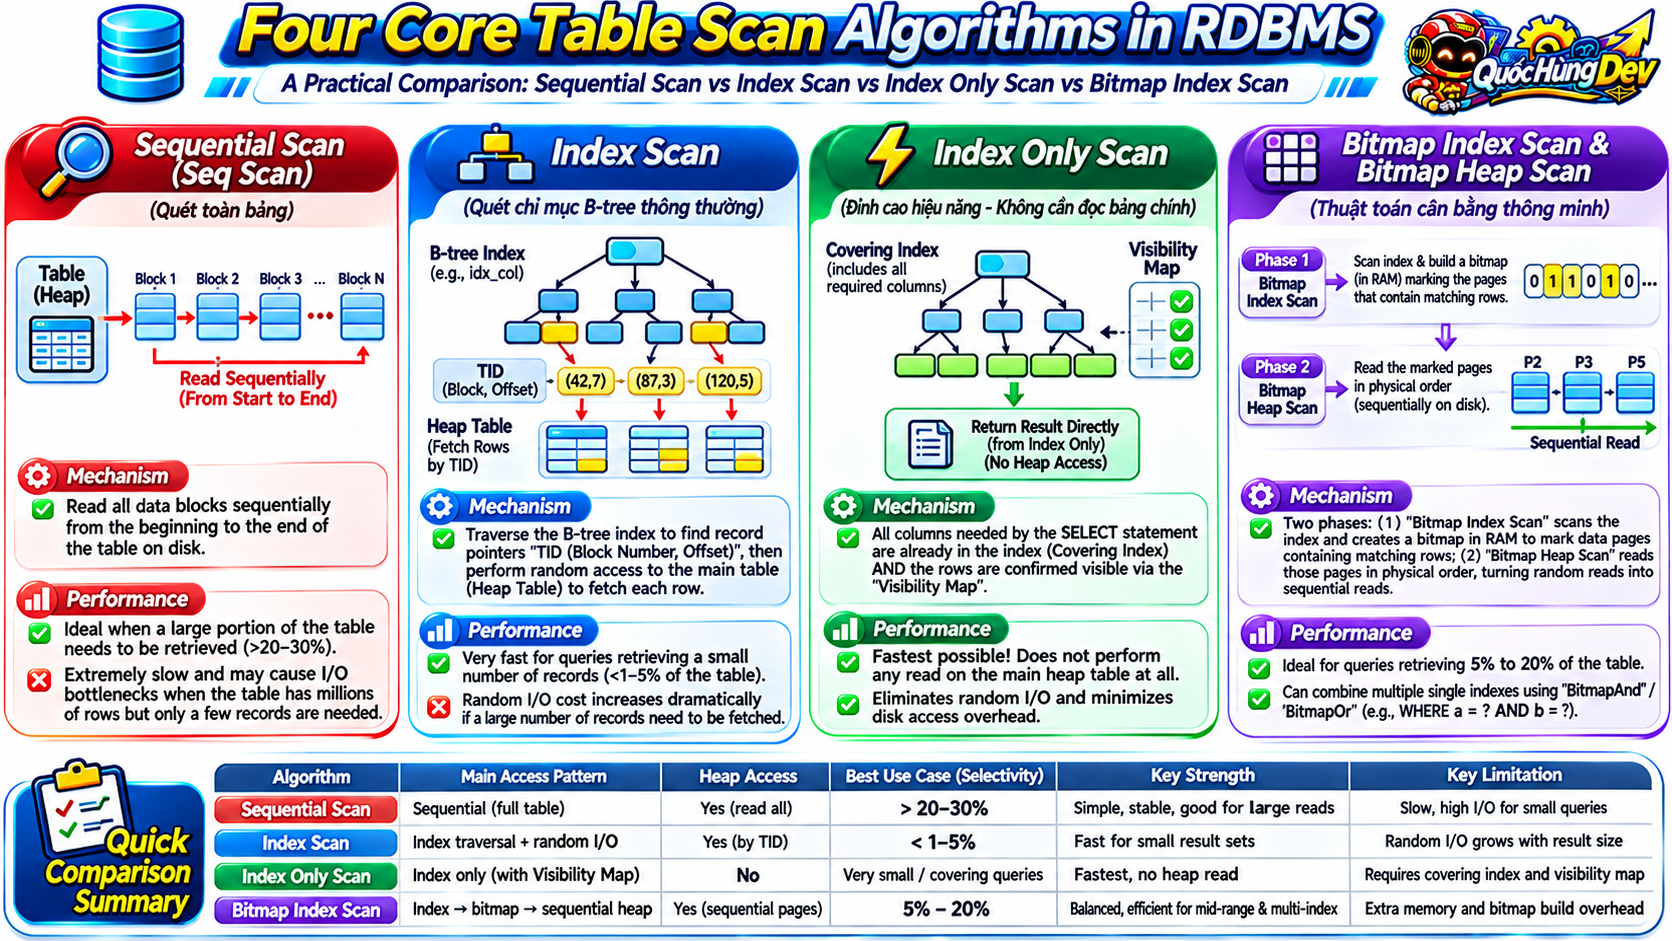
Trọng tâm kỹ thuật quan trọng hàng đầu trong việc đọc hiểu explain analyze chính là nhận diện các thuật toán truy cập dữ liệu (Access Methods) mà engine sử dụng để đọc các bản ghi từ bảng lưu trữ. Trong các cuộc thảo luận kỹ thuật về so sánh index scan và seq scan, nhiều lập trình viên thường có định kiến sai lầm rằng việc dùng index luôn luôn tốt hơn quét tuần tự toàn bảng. Trên thực tế, mỗi thuật toán đều được thiết kế tối ưu cho một phân khúc mẫu dữ liệu riêng biệt.
Thuật toán quét tuần tự sequential scan
Sequential Scan (viết tắt là Seq Scan trong PostgreSQL hoặc Full Table Scan trong MySQL) là phương thức truy cập đơn giản và căn bản nhất: động cơ cơ sở dữ liệu đọc toàn bộ các khối dữ liệu của bảng từ đầu đến cuối một cách tuần tự từ ổ đĩa cứng, sau đó áp dụng biểu thức lọc trong mệnh đề WHERE để loại bỏ các bản ghi không phù hợp.
Khi tiến hành so sánh index scan và seq scan, mặc dù thường bị xem là biểu hiện của một truy vấn chưa được tối ưu, Seq Scan lại là lựa chọn có hiệu năng vượt trội nhất khi bảng dữ liệu có kích thước nhỏ (dưới vài nghìn dòng), hoặc khi câu truy vấn cần lấy ra tỷ lệ lớn dữ liệu trong bảng (trên 25% đến 30% tổng số dòng). Lúc này, đọc tuần tự đĩa với cơ chế đọc trước Prefetching của phần cứng sẽ có thông lượng I/O cao gấp nhiều lần so với việc đọc ngẫu nhiên rải rác từng trang thông qua con trỏ chỉ mục.
Thuật toán quét chỉ mục index scan và index only scan
Khi câu truy vấn có độ chọn lọc cao (Selectivity cao, chỉ cần lấy một phần nhỏ các bản ghi dưới 5% đến 10% của bảng), thuật toán Index Scan sẽ thể hiện sức mạnh tuyệt đối. Trong thuật toán này, database duyệt qua cấu trúc cây B-Tree cân bằng của chỉ mục để tìm các khóa khớp với điều kiện, thu thập con trỏ vật lý trỏ tới vị trí của từng dòng trong bảng chính, sau đó truy cập ngẫu nhiên vào các trang bảng (Heap Pages) để lấy toàn bộ các cột dữ liệu cần thiết.
Đỉnh cao của việc so sánh index scan và seq scan chính là nhận diện được cơ hội áp dụng thuật toán Index Only Scan (hoặc Covering Index trong MySQL). Trong kịch bản này, toàn bộ các cột xuất hiện trong câu lệnh SELECT, WHERE, ORDER BY, GROUP BY đều đã nằm trọn vẹn bên trong cấu trúc của chỉ mục. Nhờ đó, cơ sở dữ liệu hoàn toàn không cần phải thực hiện bất kỳ thao tác đọc nhảy cóc nào vào bảng chính (Heap Table), giúp triệt tiêu 100% chi phí Random Disk I/O. Trong PostgreSQL, để Index Only Scan hoạt động hiệu quả, bản đồ trạng thái hiển thị (Visibility Map) của bảng phải sạch sẽ, điều này phụ thuộc vào chu kỳ dọn dẹp định kỳ của tiến trình AutoVacuum.
Thuật toán quét bản đồ bit bitmap index scan
Nằm ở khoảng giữa khi so sánh index scan và seq scan chính là thuật toán quét bản đồ bit cực kỳ thông minh của PostgreSQL, bao gồm hai giai đoạn phối hợp: Bitmap Index Scan và Bitmap Heap Scan. Thuật toán này được kích hoạt khi câu truy vấn cần lấy một lượng bản ghi vừa phải (khoảng 5% đến 20% dữ liệu), hoặc khi có nhiều điều kiện lọc kết hợp giữa các cột có chỉ mục độc lập.
Quy trình vận hành của cơ chế này diễn ra như sau: Ở giai đoạn 1, Bitmap Index Scan duyệt qua một hoặc nhiều chỉ mục và xây dựng một mảng bản đồ bit trong bộ nhớ RAM, trong đó mỗi bit đại diện cho một trang đĩa có chứa dữ liệu thỏa mãn điều kiện. Ở giai đoạn 2, Bitmap Heap Scan sẽ sắp xếp các trang đĩa cần đọc theo thứ tự vật lý trên đĩa cứng và đọc chúng một cách tuần tự, biến các thao tác đọc ngẫu nhiên tốn kém thành các thao tác đọc tuần tự mượt mà. Để hiểu sâu hơn về kiến trúc xây dựng chỉ mục kết hợp đa cột, bạn có thể tham khảo bài viết phân tích chuyên sâu về kỹ thuật tối ưu truy vấn bằng composite index của chúng tôi.
Tình huống ứng dụng thực tế theo phòng ban và nghiệp vụ

Lý thuyết về các nút toán tử và chi phí chỉ thực sự phát huy giá trị khi được áp dụng để giải quyết các sự cố suy thoái hiệu năng thực tế trong môi trường sản phẩm. Dưới đây là hai tình huống kinh điển mô tả cách các kỹ sư dữ liệu sử dụng kỹ năng đọc hiểu explain analyze để cứu vớt hệ thống khỏi nguy cơ sụp đổ khi lưu lượng người dùng tăng đột biến.
Tối ưu truy vấn lịch sử đơn hàng trong sàn thương mại điện tử
Trong một đợt khuyến mãi lớn, dịch vụ xem lịch sử đơn hàng của khách hàng trên ứng dụng mua sắm trực tuyến bất ngờ bị nghẽn nghiêm trọng, thời gian phản hồi của API vọt lên hơn 3.5 giây khiến hàng loạt yêu cầu bị ngắt kết nối do quá hạn timeout. Câu lệnh SQL gây ra sự cố được trích xuất từ nhật ký truy vấn chậm như sau:
SELECT id, order_code, total_amount, created_at
FROM orders
WHERE customer_id = 845920
ORDER BY created_at DESC
LIMIT 10;
Bảng orders có tổng cộng 15 triệu bản ghi. Bảng đã có sẵn một chỉ mục đơn lẻ trên cột customer_id. Tuy nhiên, khi kỹ sư chạy lệnh EXPLAIN ANALYZE với bọc giao dịch kiểm tra, kết quả trả về bộc lộ rõ nút thắt cổ chai để tiến hành tối ưu truy vấn sql:
Limit  (cost=185420.10..185420.12 rows=10 width=48) (actual time=3450.210..3450.215 rows=10 loops=1)
  ->  Sort  (cost=185420.10..185420.80 rows=280 width=48) (actual time=3450.208..3450.212 rows=10 loops=1)
        Sort Key: created_at DESC
        Sort Method: external merge  Disk: 4280kB
        ->  Bitmap Heap Scan on orders  (cost=12.40..185390.10 rows=280 width=48) (actual time=15.120..3420.800 rows=280 loops=1)
              Recheck Cond: (customer_id = 845920)
              ->  Bitmap Index Scan on idx_orders_customer_id  (cost=0.00..12.35 rows=280 width=0) (actual time=0.045..0.045 rows=280 loops=1)
Planning Time: 0.280 ms
Execution Time: 3452.120 ms
Phân tích cây thực thi trên: Nút Bitmap Index Scan chỉ tốn 0.045 ms để tìm ra 280 đơn hàng của khách hàng này. Tuy nhiên, nút Sort ở tầng trên lại tốn tới hơn 3.4 giây với dòng chữ cực kỳ nguy hiểm: Sort Method: external merge Disk: 4280kB, chứng tỏ RAM bị thiếu hụt buộc database phải xả dữ liệu tạm ra ổ đĩa SSD để trộn sắp xếp. Giải pháp kỹ thuật được áp dụng ngay lập tức là khởi tạo một chỉ mục tổ hợp Composite Index:
CREATE INDEX idx_orders_customer_created ON orders (customer_id, created_at DESC);Kết quả sau khi chạy lại EXPLAIN ANALYZE với chỉ mục mới:
Limit  (cost=0.43..8.55 rows=10 width=48) (actual time=0.028..0.042 rows=10 loops=1)
  ->  Index Scan using idx_orders_customer_created on orders  (cost=0.43..228.10 rows=280 width=48) (actual time=0.027..0.039 rows=10 loops=1)
        Index Cond: (customer_id = 845920)
Planning Time: 0.150 ms
Execution Time: 0.065 ms
Thời gian thực thi giảm ngoạn mục từ 3452 ms xuống còn 0.065 ms (tăng tốc hơn 53.000 lần). Nút Sort tốn kém hoàn toàn biến mất khỏi cây thực thi vì dữ liệu trong cây B-Tree của chỉ mục mới đã được sắp xếp sẵn theo đúng thứ tự created_at DESC. Engine chỉ cần duyệt đúng 10 nút lá đầu tiên trong index và dừng lại ngay lập tức, hoàn tất xuất sắc mục tiêu tối ưu truy vấn sql cho phân hệ đơn hàng.
Xử lý nghẽn bộ nhớ khi đối soát giao dịch cổng thanh toán
Trong hệ thống xử lý thanh toán tài chính, tác vụ đối soát số dư cuối ngày thường xuyên thực hiện các phép kết nối giữa bảng nhật ký chuyển tiền (transactions) với bảng tài khoản người dùng (wallets). Một câu truy vấn báo cáo đối soát chạy mất hơn 45 giây và thường xuyên gây hiện tượng sụt giảm hiệu năng của các giao dịch ghi đồng thời:
SELECT w.account_number, sum(t.amount) as daily_total
FROM wallets w
JOIN transactions t ON w.id = t.wallet_id
WHERE t.transacted_at >= CURRENT_DATE - INTERVAL '7 days' AND t.status = 'success'
GROUP BY w.account_number;
Kết quả phân tích khi đọc hiểu explain analyze cho thấy phép kết nối sử dụng thuật toán Hash Join, nhưng bảng băm Hash Table của các tài khoản ví có dung lượng quá lớn, vượt quá hạn mức bộ nhớ cấu hình, buộc PostgreSQL phải chia nhỏ bảng băm thành nhiều đợt xử lý (Batches) và ghi tạm 28.5MB xuống đĩa (Disk Spill). Bằng cách bổ sung chỉ mục Composite idx_trans_status_date (status, transacted_at, wallet_id, amount) để tạo thành Covering Index, kết hợp với việc tạm thời tăng tham số bộ nhớ SET work_mem = '64MB'; riêng trong phiên đối soát báo cáo, thời gian chạy câu lệnh đã giảm từ 42 giây xuống còn 1.4 giây mà không làm tràn bộ nhớ ra đĩa.
Giải pháp khắc phục nút thắt cổ chai và kỹ thuật tái cấu trúc câu truy vấn
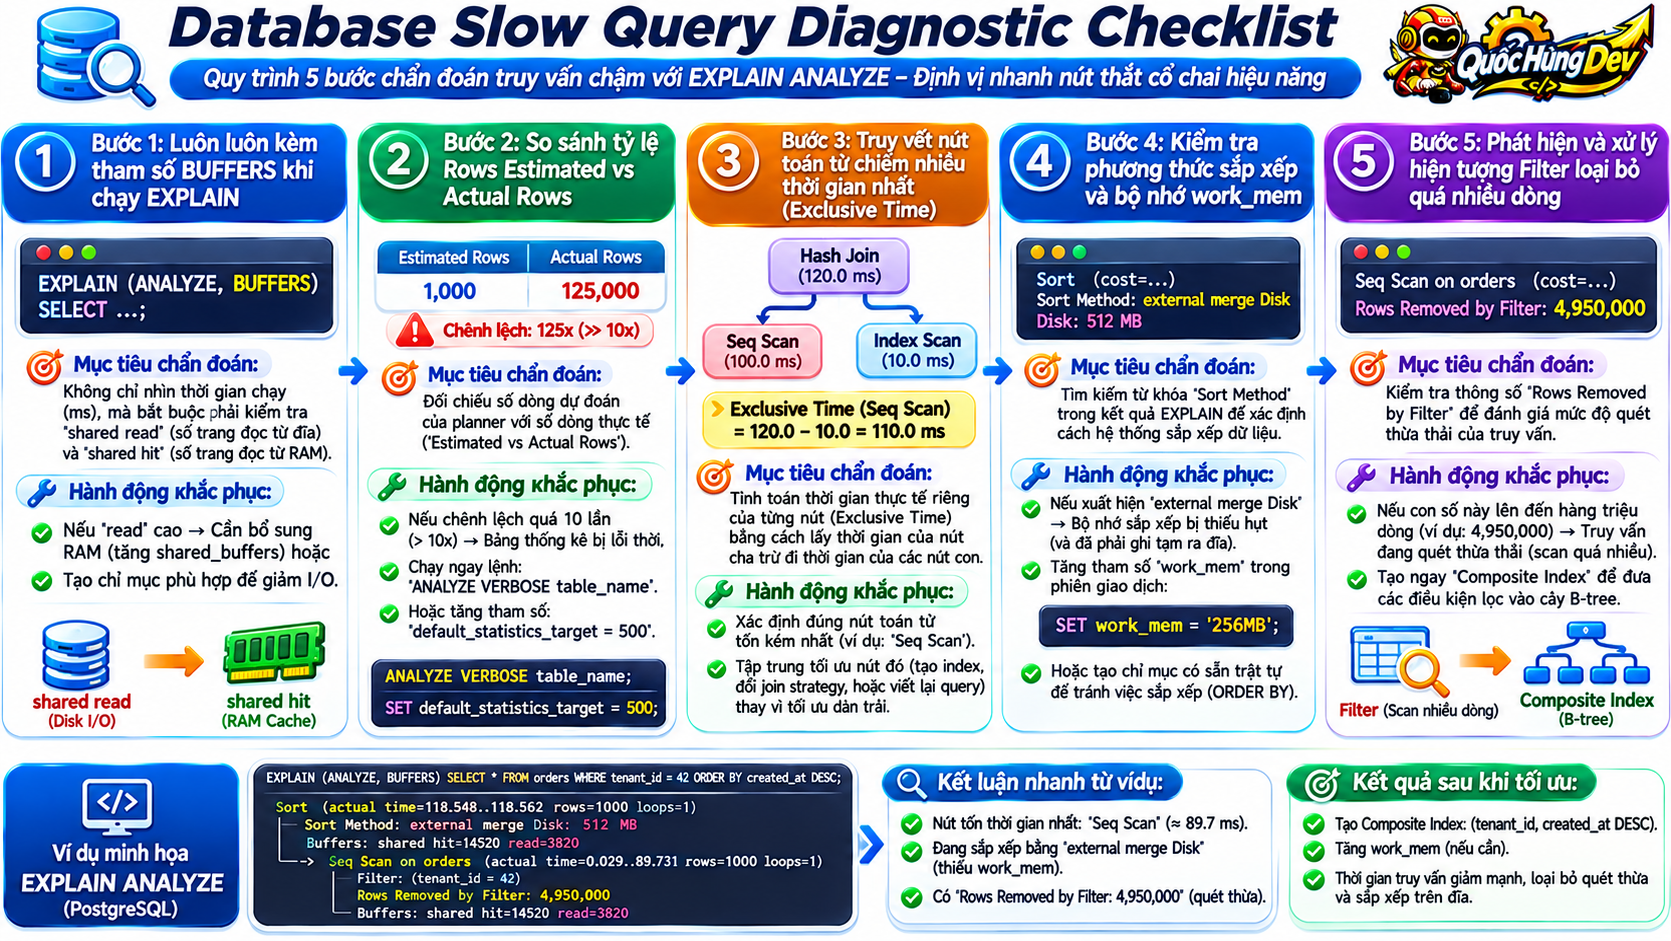
Nắm vững phương pháp luận và cách đọc execution plan một cách có hệ thống là chiếc chìa khóa giúp các lập trình viên nhanh chóng cô lập nguyên nhân gốc rễ và đưa ra giải pháp sửa chữa chính xác thay vì sửa đổi mò mẫm. Dưới đây là 3 kỹ thuật chuẩn mực được các chuyên gia kiến trúc dữ liệu áp dụng hàng ngày.
Kỹ thuật giải phẫu cây thực thi execution plan từ dưới lên
Quy tắc vàng khi tìm hiểu cách đọc execution plan cho một câu truy vấn phức tạp có hàng chục nút lồng nhau là: Đọc từ trong ra ngoài, từ dưới lên trên (Bottom-Up Analysis). Các nút thụt vào sâu nhất chính là các toán tử được thực thi đầu tiên. Khi một nút con hoàn thành việc lấy và lọc dữ liệu, luồng kết quả mới được đẩy lên nút cha để thực hiện các phép kết nối hoặc biến đổi tiếp theo.
Để tìm nút chiếm nhiều tài nguyên nhất, chúng ta không nhìn vào con số Actual Total Time của nút gốc (vì con số đó là thời gian tích lũy của toàn bộ cây), mà phải tính toán Thời gian độc quyền (Exclusive Time) của từng nút. Công thức tính thời gian độc quyền của một nút bằng: Thời gian thực tế của nút đó trừ đi tổng thời gian thực tế của tất cả các nút con trực tiếp bên dưới nó. Nút nào có Thời gian độc quyền cao nhất chính là điểm nóng thắt cổ chai cần được ưu tiên tập trung xử lý đầu tiên nhằm tối ưu truy vấn sql hiệu quả.
Khử triệt để hiện tượng loại bỏ bản ghi sau bộ lọc
Một dấu hiệu kinh điển cho thấy câu truy vấn đang lãng phí tài nguyên CPU và I/O đĩa cứng khi học cách đọc execution plan là thông số Rows Removed by Filter: X xuất hiện với giá trị lên đến hàng trăm nghìn hoặc hàng triệu. Thông số này phản ánh rằng động cơ cơ sở dữ liệu đã phải đọc từng trang đĩa, nạp bản ghi vào bộ nhớ, rồi sau đó lại phải dùng CPU kiểm tra điều kiện và vứt bỏ bản ghi đó vì không khớp mệnh đề WHERE.
Mục tiêu tối thượng của việc tối ưu hóa chỉ mục là đưa các điều kiện trong bộ lọc Filter trở thành các điều kiện trong chỉ mục Index Cond (Index Condition). Khi điều kiện nằm trong Index Cond, database engine chỉ việc duyệt cây B-Tree trực tiếp tới các bản ghi thỏa mãn mà không bao giờ phải nạp các bản ghi không phù hợp lên bộ nhớ, từ đó triệt tiêu hoàn toàn con số Rows Removed by Filter về mức bằng 0.
Tối ưu hóa các toán tử nối bảng nested loop và hash join
Trong các câu truy vấn phức tạp kết nối nhiều bảng, việc hiểu rõ cách đọc execution plan giúp lập trình viên phát hiện lựa chọn sai thuật toán Join giữa Nested Loop, Hash Join và Merge Join. Nested Loop Join vận hành giống như hai vòng lặp lồng nhau, cực kỳ tối ưu khi bảng ngoài có ít bản ghi và bảng bên trong có chỉ mục tốt. Hash Join đọc toàn bộ bảng nhỏ hơn để tạo bảng băm trong RAM, rất mạnh cho dữ liệu lớn nhưng đòi hỏi work_mem đủ lớn. Merge Join đòi hỏi cả hai bảng đã sắp xếp trước theo cột liên kết, rất nhanh và tiết kiệm RAM. Trong môi trường có nhiều giao dịch đồng thời, bạn có thể tham khảo thêm bài phân tích chuyên sâu về cơ chế locking database: optimistic và pessimistic locking để có góc nhìn toàn diện về quản trị tương tranh.
Chi phí tài nguyên phần cứng và bảng tính toán hiệu năng hệ thống
Một câu truy vấn SQL chạy chậm không chỉ làm tăng độ trễ phản hồi của người dùng mà còn gây ra tác động dây chuyền phá hủy ngân sách vận hành hạ tầng đám mây. Khi việc đọc hiểu explain analyze được thực hiện chuẩn xác, đội ngũ kỹ thuật có thể định lượng rõ ràng mối liên hệ giữa các nút toán tử truy vấn và việc tiêu hao tài nguyên phần cứng CPU, RAM, IOPS.
Áp lực đọc ghi ổ đĩa và bài toán tràn bộ nhớ tạm thời
Trong cấu hình mặc định của PostgreSQL, tham số work_mem thường được thiết lập ở mức khiêm tốn là 4MB cho mỗi thao tác sắp xếp hoặc băm. Khi một nút toán tử yêu cầu xử lý tập dữ liệu lớn hơn dung lượng được cấp phát, database engine sẽ lập tức kích hoạt cơ chế tràn đĩa (Disk Spill) tạo tệp tin tạm trên ổ đĩa lưu trữ, làm tăng vọt độ trễ truy vấn lên gấp hàng trăm lần. Nhìn thấy từ khóa Sort Method: external merge Disk hoặc Batches: N (Disk) khi đọc hiểu explain analyze là hồi chuông báo động đỏ về sự thiếu hụt bộ nhớ tạm thời.
Tác động của bảng thống kê lỗi thời tới quyết định của bộ tối ưu
Bộ tối ưu hóa truy vấn CBO hoàn toàn phụ thuộc vào tính chính xác của dữ liệu thống kê để ước lượng số dòng rows=N. Nếu bảng dữ liệu vừa trải qua đợt nhập dữ liệu hàng loạt lớn hoặc xóa bỏ hàng triệu dòng mà tiến trình thu thập thống kê chưa kịp chạy, các con số trong catalog sẽ bị sai lệch nghiêm trọng so với thực tế. Khi đọc hiểu explain analyze, nếu bạn phát hiện số lượng dòng ước lượng lệch xa quá 10 đến 100 lần so với số dòng thực tế, hành động khắc phục tức thì là chạy ngay lệnh ANALYZE VERBOSE table_name; để tái tạo lại phân phối histogram thống kê.
Bảng tổng hợp dưới đây minh họa sự cải thiện vượt bậc về mặt tài nguyên phần cứng sau khi hoàn tất quy trình chuẩn hóa và tối ưu truy vấn sql trên môi trường thực tế:
| Chỉ số hiệu năng & tài nguyên | Trước khi tối ưu hóa | Sau khi tối ưu hóa | Mức độ cải thiện thực tế |
|---|---|---|---|
| Thời gian phản hồi truy vấn (Execution Time) | 3.850 ms | 1,82 ms | Tăng tốc gấp hơn 2.100 lần |
| Tổng chi phí hoạch định (Total Planner Cost) | 245.100 điểm cost | 12,45 điểm cost | Giảm 99,99% chi phí thuật toán |
| Dung lượng đọc từ ổ đĩa (Disk Shared Reads) | 42.500 blocks (~340MB) | 0 blocks (Zero Disk I/O) | Loại bỏ 100% áp lực đọc ổ đĩa |
| Tỷ lệ trúng bộ nhớ đệm (Buffer Cache Hit) | 12,4% | 100% | Tận dụng hoàn hảo RAM Shared Buffers |
| Dung lượng bộ nhớ xả đĩa tạm (Disk Spill) | 48.500 kB ghi tạm | 0 kB (Hoàn toàn trong RAM) | Triệt tiêu hoàn toàn tệp tin tạm trên SSD |
| Năng lực phục vụ thông lượng (Throughput) | 25 QPS (Queries Per Second) | 4.500 QPS | Khả năng chịu tải tăng gấp 180 lần |
Việc bỏ bê công tác tối ưu truy vấn sql thường xuyên đẩy các doanh nghiệp vào tình thế phải tăng gấp đôi dung lượng phần cứng trong khi hiệu năng vẫn lẹt đẹt. Để nhận diện thêm các cạm bẫy thiết kế cơ sở dữ liệu tai hại khác, bạn có thể tham khảo bài viết về những sai lầm khi tối ưu cơ sở dữ liệu của chúng tôi.
Ma trận ra quyết định theo quy mô hệ thống và tính chất dự án
Không có một giải pháp tối ưu hóa đơn lẻ nào có thể áp dụng rập khuôn cho mọi dự án. Một chiến lược đánh chỉ mục hoàn hảo trên hệ thống có 100 nghìn bản ghi có thể trở thành gánh nặng khổng lồ trên hệ thống có 100 triệu bản ghi. Dưới đây là ma trận định hướng chiến lược phân bổ công cụ và kỹ thuật phân tích chi phí query theo từng quy mô dữ liệu.
Quy mô nhỏ & hệ thống khởi nghiệp
Dữ liệu dưới 500 nghìn bản ghi trên mỗi bảng. Tập trung tối ưu hóa các câu truy vấn có Seq Scan quét qua các bảng phát triển nhanh. Sử dụng các chỉ mục đơn B-Tree trên các khóa ngoại liên kết JOIN và các cột lọc chính. Chưa cần cấu hình các tham số bộ nhớ phức tạp, giữ nguyên giá trị mặc định của hệ thống.
Quy mô vừa & sàn thương mại điện tử
Dữ liệu từ 1 triệu đến 50 triệu bản ghi. Bắt buộc kích hoạt công cụ theo dõi truy vấn chậm pg_stat_statements. Khảo sát định kỳ bằng EXPLAIN (ANALYZE, BUFFERS) cho các truy vấn có tần suất gọi cao. Xây dựng các chỉ mục tổ hợp Composite Index, Covering Index và Partial Index để bảo vệ bộ nhớ đệm RAM và tối ưu truy vấn sql hiệu quả.
Quy mô lớn & dữ liệu phân tán cao
Dữ liệu trên 100 triệu bản ghi. Áp dụng kỹ thuật phân vùng bảng Table Partitioning theo thời gian hoặc danh mục. Tinh chỉnh chuyên sâu các tham số cost của planner phù hợp với ổ đĩa NVMe SSD. Kết hợp mức độ cô lập transaction nghiêm ngặt và phân tách luồng đọc ghi Read Replica để giải tỏa áp lực cho nút chính.
Khi hệ thống mở rộng quy mô, sự tương tranh giữa các giao dịch đọc và ghi sẽ gia tăng đáng kể. Việc hiểu rõ cơ chế cô lập giữa các phiên làm việc là kiến thức bổ trợ bắt buộc, bạn nên tham khảo thêm bài phân tích về mức cô lập transaction trong PostgreSQL và MySQL để bảo toàn tính toàn vẹn dữ liệu.
Checklist an toàn và lưu ý vận hành trên môi trường production
Việc thực thi lệnh EXPLAIN ANALYZE trực tiếp trên môi trường production tiềm ẩn nhiều rủi ro nếu lập trình viên không tuân thủ các quy tắc an toàn hạ tầng. Trước khi tiến hành phân tích câu truy vấn trên máy chủ thật, đội ngũ kỹ thuật cần kiểm tra nghiêm ngặt danh sách các điểm kiểm soát dưới đây.
Cảnh báo kiến trúc an toàn: Tuyệt đối không bao giờ chạy lệnh EXPLAIN ANALYZE trên các câu truy vấn chưa rõ nguồn gốc hoặc nghi ngờ bị treo vô tận mà không thiết lập giới hạn thời gian thực thi (statement timeout). Một câu truy vấn nghẽn có thể chiếm giữ khóa độc quyền trên bảng dữ liệu, khiến hàng nghìn kết nối khác bị ùn ứ và đánh sập toàn bộ hồ kết nối kết nối Connection Pool của ứng dụng.
- 1. Luôn thiết lập giới hạn thời gian phiên làm việc: Trước khi thực thi phân tích, hãy đặt giới hạn thời gian tối đa cho câu truy vấn bằng lệnh:
SET statement_timeout = '5000ms';để đảm bảo câu lệnh tự động bị ngắt an toàn nếu vượt quá 5 giây. - 2. Bọc toàn bộ câu lệnh sửa đổi trong Transaction Rollback: Với các câu lệnh UPDATE, DELETE, INSERT, quy tắc bất di bất dịch là bắt đầu bằng
BEGIN;, thực thi câu lệnh phân tích, và kết thúc bằngROLLBACK;để ngăn chặn việc ghi dữ liệu ngoài ý muốn. - 3. Ưu tiên thực hiện trên máy chủ bản sao đọc (Read Replica): Khi cần khảo sát các câu truy vấn phức tạp phục vụ báo cáo hoặc phân tích dữ liệu, hãy chuyển hướng kết nối sang máy chủ Read Replica để tránh tiêu hao tài nguyên CPU và bộ nhớ của máy chủ ghi chính (Primary Master).
- 4. Bật cờ BUFFERS thay vì chỉ dựa vào thời gian: Luôn luôn chạy cú pháp
EXPLAIN (ANALYZE, BUFFERS)để kiểm soát chính xác lượng dữ liệu đọc từ đĩa và hiệu quả sử dụng bộ nhớ đệm trong quá trình tối ưu truy vấn sql. - 5. Kiểm tra và cập nhật bảng thống kê catalog định kỳ: Nếu phát hiện số dòng ước lượng lệch xa thực tế, thực hiện cập nhật thống kê bằng lệnh
ANALYZEtrong các khung giờ thấp điểm của hệ thống. - 6. Khảo sát chỉ mục thừa và chỉ mục không được sử dụng: Sau khi tạo chỉ mục mới, hãy theo dõi bảng
pg_stat_user_indexesđể đảm bảo chỉ mục đó thực sự được bộ tối ưu sử dụng và chủ động dọn dẹp các chỉ mục mồ côi để giải phóng tài nguyên ghi. - 7. Cấu hình cẩn trọng tham số random_page_cost: Đảm bảo tham số
random_page_costtrên máy chủ sử dụng ổ đĩa SSD được hạ xuống mức 1.1 đến 1.5 để phản ánh đúng tốc độ phần cứng thực tế.
Câu hỏi thường gặp về EXPLAIN ANALYZE và tối ưu hóa truy vấn
Dưới đây là phần giải đáp chi tiết cho những câu hỏi thường gặp nhất của các kỹ sư backend và quản trị viên cơ sở dữ liệu trong quá trình áp dụng kỹ năng đọc hiểu explain analyze vào thực tiễn.
Vì sao câu truy vấn chạy EXPLAIN ANALYZE lần đầu rất chậm nhưng lần thứ hai lại rất nhanh?
Hiện tượng này bắt nguồn từ sự khác biệt cơ bản giữa trạng thái bộ nhớ đệm nguội (Cold Cache) và bộ nhớ đệm ấm (Warm Cache). Trong lần thực thi đầu tiên, các khối dữ liệu của bảng và chỉ mục chưa có sẵn trong bộ nhớ RAM (Shared Buffers của database hoặc Page Cache của hệ điều hành), buộc hệ thống phải gửi các lệnh I/O vật lý xuống ổ đĩa cứng để nạp dữ liệu. Quá trình đọc đĩa này tốn nhiều mili-giây. Tuy nhiên, sau khi hoàn tất lần chạy đầu tiên, toàn bộ các trang dữ liệu này đã được giữ lại trong bộ nhớ RAM. Ở lần chạy thứ hai, database engine chỉ việc đọc trực tiếp dữ liệu từ RAM với tốc độ hàng chục gigabyte mỗi giây mà không phát sinh thêm bất kỳ thao tác đọc đĩa nào (shared hit 100%), khiến thời gian thực thi giảm đi hàng chục đến hàng trăm lần.
Làm thế nào để biết một chỉ mục đã tạo có thực sự được database sử dụng hay không?
Để kiểm tra xem một chỉ mục có được bộ tối ưu hóa truy vấn lựa chọn hay không, cách trực tiếp nhất là chạy lệnh EXPLAIN cho câu truy vấn và quan sát xem trong cây thực thi có xuất hiện nút Index Scan, Index Only Scan hoặc Bitmap Index Scan đi kèm tên chỉ mục của bạn hay không. Ngoài ra, trên quy mô toàn bộ máy chủ PostgreSQL, bạn có thể truy vấn bảng thống kê hệ thống pg_stat_user_indexes và quan sát cột idx_scan. Nếu cột idx_scan của một chỉ mục bằng 0 sau một thời gian dài hệ thống vận hành, điều đó chứng tỏ chỉ mục này chưa từng được bất kỳ câu truy vấn nào sử dụng và bạn nên cân nhắc gỡ bỏ để tối ưu hóa hiệu năng ghi.
Chỉ số cost trong EXPLAIN có tương ứng trực tiếp với thời gian mili-giây không?
Hoàn toàn không. Chỉ số cost là một đơn vị quy ước tương đối không có thứ nguyên vật lý, được bộ tối ưu hóa truy vấn CBO tính toán dựa trên các công thức ước lượng chi phí I/O trang đĩa và chu kỳ xử lý của CPU. Giá trị cost chỉ có ý nghĩa tương đối để bộ lập kế hoạch so sánh các phương án thực thi khác nhau trong cùng một thời điểm và chọn ra phương án tối ưu nhất. Hai câu truy vấn khác nhau có cùng điểm cost là 500 có thể có thời gian thực thi thực tế chênh lệch nhau gấp hàng trăm lần tùy thuộc vào tỷ lệ dữ liệu nằm trong RAM và năng lực xử lý của phần cứng.
Khi nào nên ưu tiên Partial Index thay vì B-Tree Index thông thường?
Partial Index (chỉ mục từng phần) là giải pháp tối ưu vượt trội khi dữ liệu trong bảng của bạn có sự phân bổ không đồng đều (High Skewness) và các câu truy vấn thường xuyên lọc theo một tập con dữ liệu cố định. Ví dụ: Nếu bảng đơn hàng có 10 triệu bản ghi nhưng có tới 98% đơn hàng ở trạng thái ‘completed’ và chỉ có 2% đơn hàng ở trạng thái ‘pending’ cần xử lý gấp. Việc tạo B-Tree Index thông thường cho cột status sẽ tạo ra một cây chỉ mục khổng lồ tốn hàng gigabyte RAM. Thay vào đó, tạo một Partial Index với điều kiện WHERE status = 'pending' sẽ tạo ra một cây chỉ mục siêu nhỏ gọn chỉ vài megabyte, vừa tăng tốc độ lọc tức thì vừa tiết kiệm tối đa bộ nhớ đệm RAM và tài nguyên ghi.
Sự khác biệt giữa EXPLAIN ANALYZE trên PostgreSQL và MySQL là gì?
Cả hai hệ quản trị đều hỗ trợ EXPLAIN ANALYZE nhưng có cú pháp và cách thức hiển thị khác nhau. PostgreSQL hỗ trợ cú pháp mở rộng với nhiều cờ tùy chọn sâu như EXPLAIN (ANALYZE, BUFFERS, VERBOSE, SETTINGS), cung cấp chi tiết số khối bộ nhớ đệm, cấu hình tham số bị ghi đè và hỗ trợ đa dạng định dạng xuất kết quả như TEXT, JSON, XML, YAML. Trong khi đó, MySQL hỗ trợ EXPLAIN ANALYZE từ phiên bản 8.0 trở lên, xuất kết quả dưới dạng cây thụt lề định dạng văn bản mặc định hiển thị chi phí và thời gian thực thi của từng toán tử lặp Iterator. Cả hai hệ thống đều đòi hỏi lập trình viên phải nắm vững bản chất toán học của các nút toán tử để đưa ra quyết định tối ưu truy vấn sql chính xác.
Kết luận và định hướng kiến trúc dữ liệu bền vững
Năng lực đọc hiểu explain analyze không đơn thuần là một kỹ năng gỡ lỗi tình thế khi cơ sở dữ liệu gặp sự cố, mà là tư duy nền tảng định hình phong cách thiết kế phần mềm chuyên nghiệp của một kỹ sư backend cấp cao. Khi bạn có khả năng nhìn thấu từng chuyển động dữ liệu trong cây kế hoạch thực thi, bạn sẽ không còn phải suy đoán mù quáng hay vội vã đánh bừa các chỉ mục gây tổn hại tới hệ thống.
Tối ưu hóa hiệu năng cơ sở dữ liệu là một hành trình liên tục gắn liền với sự trưởng thành của sản phẩm. Một hệ thống dữ liệu bền vững luôn được xây dựng dựa trên sự cân bằng hài hòa giữa việc thiết kế cấu trúc bảng chuẩn mực, chiến lược phân bổ chỉ mục tinh gọn, cấu hình phần cứng bám sát thực tế, và việc giám sát định kỳ các chỉ số truy vấn chậm. Việc làm chủ toàn diện các nút toán tử và các tham số chi phí của bộ lập kế hoạch chính là bước đệm vững chắc giúp bạn tự tin xây dựng và vận hành các hạ tầng dữ liệu quy mô lớn, đảm bảo tính sẵn sàng cao và mang lại trải nghiệm tối ưu cho người dùng. Bạn có thể tham khảo thêm tài liệu kỹ thuật chính thức tại PostgreSQL documentation on EXPLAIN để liên tục cập nhật các cải tiến mới nhất của hệ quản trị cơ sở dữ liệu.