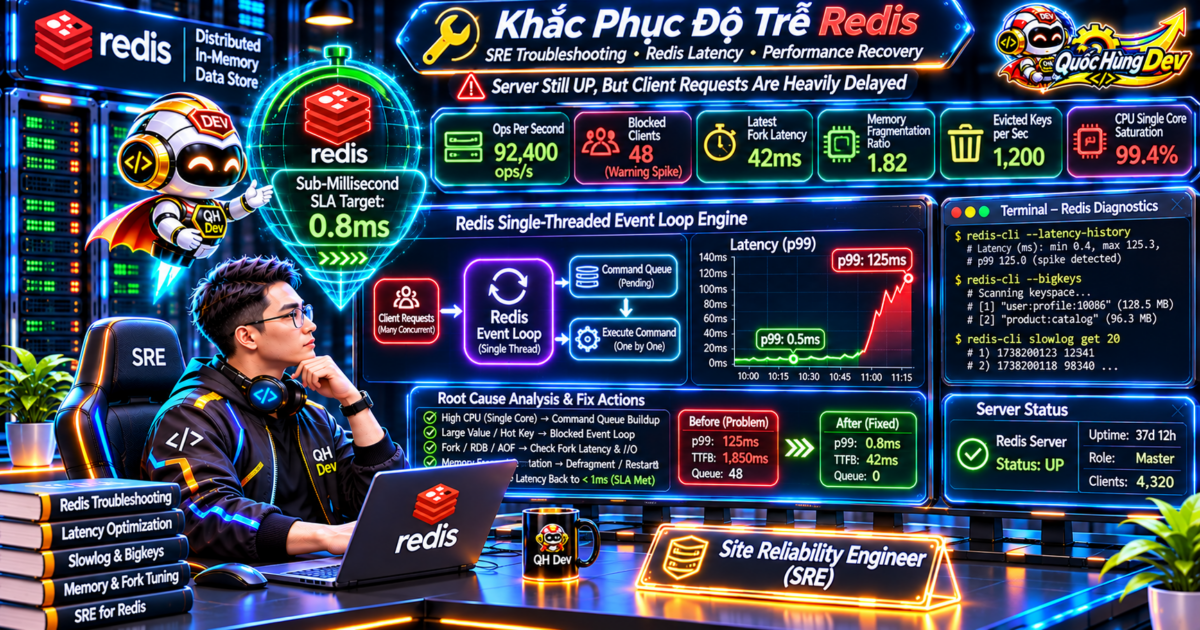
Kỹ thuật khắc phục độ trễ redis đóng vai trò sống còn trong việc bảo vệ tính sẵn sàng của các hệ thống microservices và nền tảng giao dịch trực tuyến hiện nay. Nhiều kỹ sư đối mặt với nghịch lý khi tiến trình báo redis_up bằng 1, cổng TCP 6379 thông suốt, lệnh PING nhận PONG tức thì nhưng ứng dụng backend liên tục sụp đổ.
Hậu quả trực tiếp là tỷ lệ lỗi HTTP 504 Gateway Timeout tăng vọt lên mức 4.8%, thời gian phản hồi p95 API leo thang từ 45 mili-giây lên 5.2 giây. Nhóm luồng xử lý Active HTTP Threads phía cổng giao tiếp bị chiếm dụng hoàn toàn, gây cạn kiệt connection pool và làm gián đoạn doanh thu doanh nghiệp.
Để giải quyết dứt điểm sự cố, cẩm nang chuyên sâu này phân tích bản chất kiến trúc xử lý đơn luồng, truy vết 5 nguyên nhân gốc rễ gây nghẽn event loop. Chúng tôi cung cấp quy trình 3 bước chẩn đoán bằng dòng lệnh chuyên dụng, kết hợp ma trận cấu hình connection pool chuẩn mực cho toàn bộ hạ tầng.
Bản chất kiến trúc reactor pattern và giải pháp khắc phục độ trễ Redis
Khi triển khai khắc phục độ trễ redis trên môi trường thực tế, kỹ sư cần hiểu sâu bản chất reactor pattern mà bộ nhớ đệm này áp dụng. Khác với hệ cơ sở dữ liệu đa luồng, lõi xử lý logic của Redis vận hành trên một vòng lặp sự kiện đơn luồng duy nhất nhằm loại bỏ chi phí context switching.
Cơ chế này tận dụng khả năng I/O multiplexing phi chặn thông qua các lời gọi hệ thống như epoll trên Linux hoặc kqueue trên BSD. Khi hàng nghìn kết nối client gửi tín hiệu đến socket, bộ điều phối Event Dispatcher gom gói tin vào hàng đợi rồi chuyển tiếp tuần tự từng lệnh tới luồng chính Main Thread.
Nhờ truy xuất trực tiếp trên bộ nhớ RAM với cấu trúc dữ liệu tối ưu, Redis xử lý hàng trăm nghìn thao tác mỗi giây đối với các lệnh O(1). Tuy nhiên, thiết kế đơn luồng tạo ra điểm nghẽn nghiêm trọng: luồng chính chỉ có thể thực thi duy nhất một câu lệnh tại một thời điểm nhất định.
Khi xuất hiện câu lệnh phức tạp O(N), luồng chính sẽ bị phong tỏa trong toàn bộ thời gian duyệt dữ liệu. Điều này giải thích tại sao chỉ số CPU tổng thể trên dashboard chỉ dao động 25% đến 38% trên máy chủ 4 nhân, nhưng nhân CPU chạy luồng Redis Main Thread đã chạm ngưỡng 100% công suất.
Trong hoàn cảnh này, các lệnh kiểm tra sức khỏe liveness probe như PING vẫn được luồng mạng phản hồi PONG giữa các chu kỳ giải lao ngắn của socket. Hệ thống điều phối lầm tưởng máy chủ còn khỏe mạnh, trong khi hàng nghìn tiến trình phía sau đã bị giữ chặt trong hàng đợi chờ xử lý.
Bảng so sánh tổng quan nhanh giữa các phương pháp kiểm tra trạng thái Redis
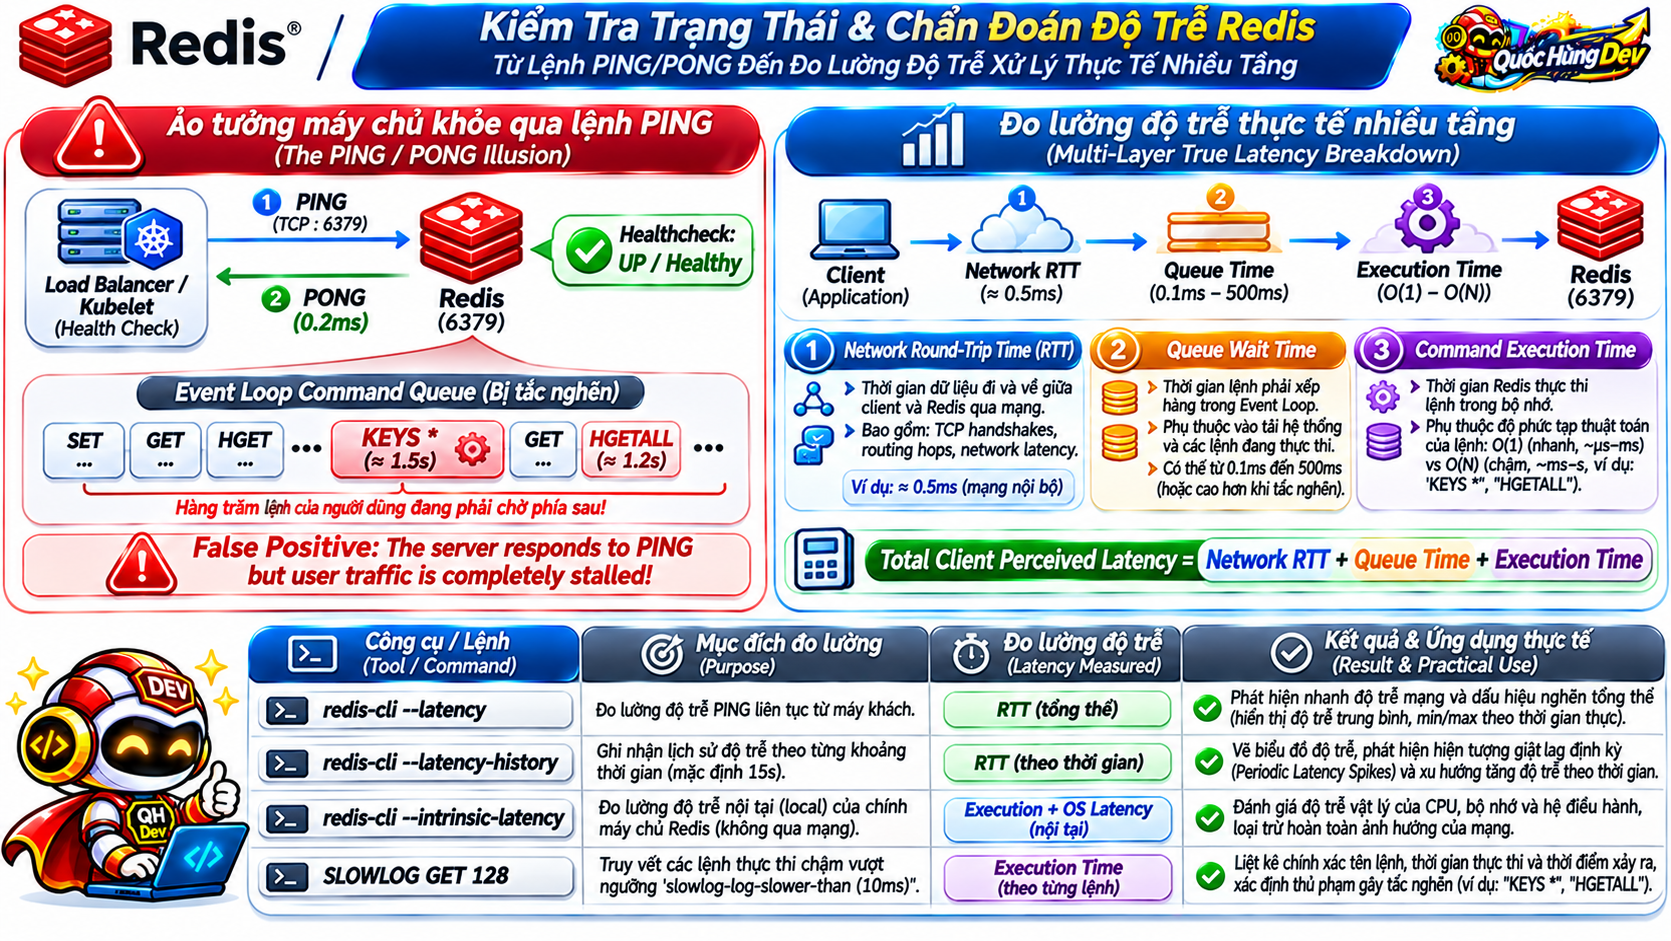
Việc lựa chọn sai công cụ kiểm thử khiến đội ngũ vận hành phản ứng chậm trước các đợt suy giảm hiệu năng nghiêm trọng. Nhằm hỗ trợ quy trình khắc phục độ trễ redis đạt độ chính xác cao, bảng đối chiếu dưới đây phân loại rõ ràng mục đích, phạm vi phản ánh và điểm mù của từng phương pháp kiểm tra.
Sơ đồ kiến trúc trên phản ánh tiến trình các câu lệnh O(1) bị ứ đọng sau một tác vụ nặng chiếm dụng CPU. Bảng dưới đây cung cấp tiêu chuẩn đánh giá giúp bạn chọn đúng công cụ cho từng kịch bản kiểm toán hạ tầng.
| Phương pháp kiểm tra | Độ phức tạp lệnh | Phạm vi phản ánh thực tế | Điểm mù kỹ thuật nguy hiểm | Khuyến nghị sử dụng |
|---|---|---|---|---|
| Lệnh PING / PONG | O(1) cực nhẹ | Xác nhận socket TCP mở và tiến trình còn sống | Hoàn toàn bỏ qua hàng đợi lệnh và tải CPU nhân đơn | Chỉ dùng cho basic liveness probe khởi động container |
| redis-cli –latency | O(1) liên tục | Đo độ trễ mạng trọn vòng RTT và phản hồi tức thời | Chưa chỉ ra cụ thể câu lệnh hoặc key gây nghẽn | Dùng để chẩn đoán sơ bộ độ trễ vật lý và mạng |
| Lệnh SLOWLOG GET | O(1) trong RAM | Đo chính xác thời gian CPU thực thi lệnh vượt ngưỡng | Không ghi nhận thời gian lệnh phải xếp hàng chờ | Bắt buộc dùng khi truy vết câu lệnh chạy chậm |
| Lệnh INFO stats/clients | O(1) thống kê | Cung cấp chỉ số QPS, client kết nối và bộ nhớ | Dữ liệu tổng hợp theo mẫu, không có ngữ cảnh thời gian thực | Dùng để đánh giá sức khỏe tổng thể và rò rỉ kết nối |
| APM Tracing (p95/p99) | Đo tầng Client | Đo toàn diện độ trễ từ góc nhìn trải nghiệm người dùng | Đòi hỏi chi phí tài nguyên và công cụ phân tán | Tiêu chuẩn vàng để phát hiện suy giảm dịch vụ |
Từ bảng đối chiếu, kỹ sư không bao giờ được phép chỉ dựa vào tín hiệu PONG để kết luận hệ thống ổn định. Sự kết hợp giữa chỉ số nội tại và giám sát APM là phương pháp duy nhất bảo đảm chất lượng dịch vụ.
Phân định ranh giới giữa độ trễ mạng và độ trễ hàng đợi nội bộ
Một bước cốt lõi khi thực hiện khắc phục độ trễ redis là phân định ranh giới giữa độ trễ đường truyền vật lý Network Latency và độ trễ hàng đợi nội bộ Queueing Latency. Nhiều nhóm kỹ thuật mất hàng giờ rà soát thiết bị mạng switch và router trong khi gốc rễ sự cố nằm ở bộ đệm tiến trình máy chủ.
Độ trễ mạng thuần túy cấu thành từ thời gian truyền tín hiệu Round-Trip Time (RTT), độ trễ bắt tay TCP, nghẽn gói tin tại card mạng ảo hóa và phân mảnh khung truyền MTU. Trong cùng mạng nội bộ Virtual Private Cloud (VPC), độ trễ RTT giữa ứng dụng và máy chủ lưu trữ đệm chỉ dao động 0.2 đến 0.8 mili-giây.
Ngược lại, độ trễ hàng đợi Queueing Latency phát sinh khi yêu cầu truy vấn đã đến socket mạng nhưng phải nằm chờ tại bộ đệm Client Input Buffer do Main Thread bận xử lý tác vụ trước đó. Tình trạng này tương tự hiện tượng nghẽn đầu hàng Head-of-Line Blocking trong giao thức HTTP/1.1 cổ điển.
Giả sử một tiến trình gửi lệnh HGETALL quét 50.000 phần tử trong hash giỏ hàng khổng lồ, khiến luồng chính mất 400 mili-giây tuần tự hóa dữ liệu. Suốt 400 mili-giây đó, mọi truy vấn đọc khóa GET vốn chỉ tốn 10 micro-giây đều phải đứng chờ, kéo độ trễ thực tế phía ứng dụng lên hơn 400 mili-giây.
Khi hàng trăm client cùng gửi request, độ trễ hàng đợi tích lũy nhanh chóng, vượt qua ngưỡng Command Timeout của client. Để tối ưu kết nối mạng cổng biên trước khi chạm tới tầng cache, bạn có thể xem thêm hướng dẫn về cấu hình load balancer Nginx API Gateway chuẩn mực.
Phân tích kỹ thuật chuyên sâu 5 nguyên nhân gốc rễ khiến Redis bị nghẽn
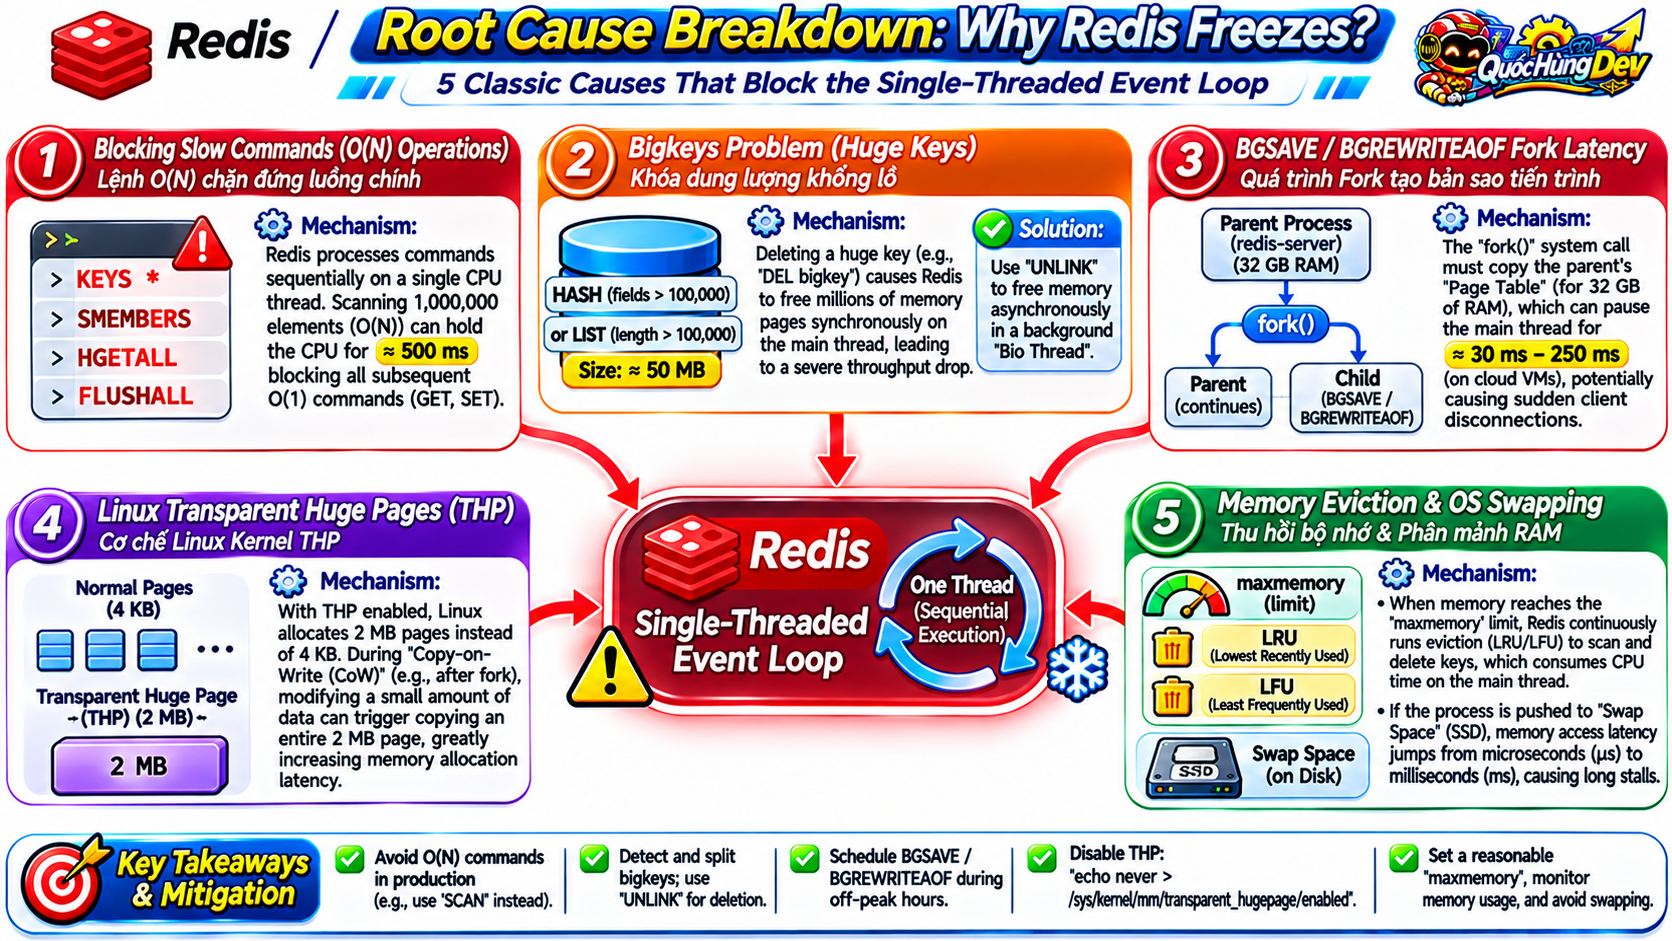
Quá trình triển khai khắc phục độ trễ redis đòi hỏi kỹ sư nắm vững 5 cơ chế gây nghẽn điển hình trên hệ thống production. Mỗi nguyên nhân bắt nguồn từ đặc tính kiến trúc hạt nhân Linux, cách tổ chức cấu trúc dữ liệu và thói quen lập trình của đội ngũ phát triển ứng dụng.
Quét dữ liệu trên cấu trúc big key khổng lồ
Khái niệm big key chỉ các tập hợp phức tạp như Hash, Set, ZSet hoặc List chứa hàng chục nghìn đến hàng triệu phần tử con. Khi lập trình viên gọi lệnh quét toàn phần như HGETALL, SMEMBERS hoặc KEYS *, Redis buộc phải duyệt qua toàn bộ bảng băm nội bộ dict và cấp phát bộ nhớ liên tục.
Thao tác xóa big key bằng lệnh DEL cũng rất nguy hiểm vì giải phóng bộ nhớ đồng bộ trên Main Thread, làm tiến trình đơ nhiều giây. Kỹ thuật đúng là dùng con trỏ phân trang HSCAN, SSCAN và xóa bất đồng bộ bằng lệnh UNLINK để giao việc giải phóng bộ nhớ cho luồng ngầm Background Bio Thread.
# Quét big key an toàn với khoảng nghỉ tránh nghẽn luồng chính
redis-cli -h 10.0.1.20 -p 6379 --bigkeys -i 0.05

# Xóa bất đồng bộ an toàn qua luồng ngầm bằng UNLINK
redis-cli -h 10.0.1.20 -p 6379 UNLINK ecommerce:cache:user_cart
Bão hết hạn khóa và hiện tượng sụp đổ bộ nhớ đệm
Hiện tượng bão hết hạn TTL Storm xảy ra khi hàng loạt khóa được gán thời gian sống cố định cùng thời điểm, ví dụ 3600 giây. Cơ chế dọn rác chủ động Active Expiration của Redis lấy ngẫu nhiên 20 khóa có TTL mỗi chu kỳ 100 mili-giây để kiểm tra và giải phóng.
Nếu tỷ lệ khóa hết hạn vượt quá 25% số mẫu, Redis lặp lại vòng quét ngay trên Main Thread và tạm ngừng nhận lệnh mới. Giải pháp bắt buộc là thêm khoảng trễ ngẫu nhiên Jitter vào TTL, đồng thời dùng khóa phân tán Mutex SingleFlight phía ứng dụng để chặn truy vấn dồn xuống cơ sở dữ liệu.
import random

def set_cache_with_jitter(client, key, data, base_ttl=3600):
    # Thêm jitter từ 0 đến 300 giây để phân tán đỉnh dọn rác
    jitter = random.randint(0, 300)
    client.set(key, data, ex=base_ttl + jitter)
Độ trễ do tiến trình snapshot dữ liệu và cơ chế copy-on-write
Khi sao lưu dữ liệu ra đĩa qua RDB hoặc AOF rewrite, Redis thực thi lệnh gọi hệ thống fork() để nhân bản tiến trình. Dù bộ nhớ thực tế không sao chép ngay nhờ cơ chế Copy-on-Write (CoW), hạt nhân Linux vẫn phải sao chép toàn bộ bảng phân trang bộ nhớ Page Table.
Trên máy chủ dung lượng RAM lớn từ 64GB với hàng triệu khóa, Page Table có thể nặng vài trăm megabyte, làm Main Thread bị treo 100 đến 800 mili-giây. Nếu tính năng Transparent Huge Pages (THP) trên Linux đang bật, khối nhớ 2MB cưỡng bức sẽ bùng nổ lượng dữ liệu CoW, đẩy độ trễ lên mức báo động.
# Kiểm tra thời gian fork gần nhất trên Redis
redis-cli INFO stats | grep latest_fork_usec

# Tắt Transparent Huge Pages trên Linux
echo never > /sys/kernel/mm/transparent_hugepage/enabled
Quá tải socket mạng và nghẽn băng thông network i/o
Tại hệ thống lưu lượng trên 50.000 QPS, chi phí CPU cho việc đọc socket, giải mã RESP và gửi phản hồi chiếm hơn 60% năng lực xử lý. Dù các câu lệnh thực thi cực nhẹ O(1), luồng chính vẫn quá tải vì phải trực tiếp đảm nhiệm các thao tác nhập xuất mạng tuần tự.
Từ phiên bản Redis 6.0 trở đi, tính năng Multi-threaded I/O đã giải quyết triệt để nút thắt bằng cách tách việc đọc ghi socket sang các luồng io-threads riêng biệt. Logic thực thi lệnh vẫn giữ đơn luồng an toàn, giúp thông lượng mạng tăng gấp đôi mà không phát sinh xung đột dữ liệu.
# Bật Multi-threaded I/O trong redis.conf
io-threads 4            # Đặt bằng vCPU - 1 hoặc vCPU / 2
io-threads-do-reads yes # Đa luồng cả tác vụ đọc socket
Phân mảnh bộ nhớ và thảm họa swap thrashing
Nguyên nhân thứ năm là tỷ lệ phân mảnh Memory Fragmentation Ratio vượt ngưỡng hoặc máy chủ bị đẩy vào phân vùng Swap trên đĩa cứng. Khi liên tục ghi đè các khóa có kích thước không đều, trình cấp phát jemalloc để lại các khoảng trống bộ nhớ không thể thu hồi.
Nếu mem_fragmentation_ratio vượt quá 1.5, Redis tiêu tốn RAM thực tế cao gấp rưỡi dung lượng hữu ích. Khi RAM cạn và hệ điều hành tráo đổi dữ liệu sang Swap trên đĩa SSD, tốc độ đọc ngẫu nhiên giảm hàng nghìn lần, biến các câu lệnh đơn giản thành các điểm nghẽn tê liệt dịch vụ.
Quy trình 3 bước chẩn đoán độ trễ bằng CLI và công cụ kernel
Khi đối mặt với sự cố trên môi trường sản xuất, đội ngũ kỹ thuật tuyệt đối không được khởi động lại dịch vụ vội vàng. Hành vi restart đột ngột làm bốc hơi toàn bộ dữ liệu trên RAM, biến sự cố suy giảm hiệu năng bộ nhớ đệm thành thảm họa sụp đổ cơ sở dữ liệu quan hệ phía sau do lưu lượng khổng lồ tràn xuống bất ngờ.
Thay vào đó, kỹ sư cần triển khai quy trình chẩn đoán 3 bước tuần tự bằng các công cụ dòng lệnh tiêu chuẩn nhằm khoanh vùng nguồn gốc lỗi chỉ trong 3 đến 5 phút.
Bước 1: Đo lường độ trễ tức thời bằng cờ latency
Trong quá trình khắc phục độ trễ redis, thao tác đầu tiên là chạy công cụ đo độ trễ trực tiếp từ chính pod ứng dụng trỏ về địa chỉ IP của máy chủ Redis. Việc này giúp xác định ngay lập tức độ trễ xuất phát từ phía máy chủ bộ nhớ đệm hay nằm ở tầng mã nguồn ứng dụng nội bộ.
# Đo độ trễ tức thời liên tục
redis-cli -h 10.0.1.20 -p 6379 --latency

# Theo dõi biến thiên độ trễ theo chu kỳ 15 giây
redis-cli -h 10.0.1.20 -p 6379 --latency-history -i 15
Nếu kết quả đo vượt mức 20 đến 50 mili-giây, nguyên nhân chắc chắn nằm ở máy chủ Redis do luồng chính nghẽn hoặc CPU bão hòa. Ngược lại, nếu giá trị dưới 1 mili-giây nhưng ứng dụng vẫn timeout, vấn đề nằm ở tầng ứng dụng do cạn connection pool hoặc tranh chấp khóa nội bộ.
Bước 2: Hướng dẫn kiểm tra slowlog redis và truy vết câu lệnh chậm
Một cấu phần không thể thiếu là hướng dẫn kiểm tra slowlog redis để truy tìm chính xác câu lệnh nào đang chiếm dụng thời gian xử lý của Main Thread. Redis trang bị sẵn bộ đệm vòng nhớ trong RAM chuyên ghi nhận các lệnh có thời gian thực thi CPU vượt qua ngưỡng quy định.
# Cấu hình ngưỡng ghi nhận lệnh chậm (10000 µs = 10ms)
redis-cli CONFIG SET slowlog-log-slower-than 10000

# Lấy ra 10 câu lệnh chậm nhất gần đây
redis-cli SLOWLOG GET 10
Kết quả từ lệnh SLOWLOG hiển thị mã định danh, thời gian Unix, thời gian thực thi micro-giây, câu lệnh cùng tham số khóa và IP client. Điểm mù cốt lõi của Slowlog là chỉ ghi nhận thời gian CPU xử lý chứ không tính thời gian lệnh xếp hàng chờ. Bạn có thể tham khảo thêm tài liệu chính thức Redis Latency Doctor để hiểu rõ phương pháp phân tích nâng cao.
Bước 3: Đánh giá toàn diện các chỉ số tài nguyên qua lệnh info
Sau khi xác định câu lệnh chậm, bước kế tiếp là đánh giá sức khỏe máy chủ qua lệnh INFO. Các thông số then chốt gồm: instantaneous_ops_per_sec để kiểm tra lưu lượng đột biến; connected_clients và blocked_clients để phát hiện rò rỉ kết nối; rejected_connections nhằm xác định chạm trần maxclients; và latest_fork_usec đo thời gian dừng luồng khi snapshot đĩa.
Tình huống ứng dụng thực tế theo phòng ban và dịch vụ
Việc áp dụng chiến lược khắc phục độ trễ redis vào thực tế vận hành doanh nghiệp đòi hỏi sự thấu hiểu sâu sắc đặc thù nghiệp vụ của từng phòng ban. Các mô hình kinh doanh khác nhau sẽ tạo ra các mô thức truy cập dữ liệu và nguy cơ tắc nghẽn hoàn toàn khác biệt.
Phòng ban thương mại điện tử và sự kiện bán hàng chớp nhoáng flash sale
Tại các doanh nghiệp thương mại điện tử, chiến dịch Flash Sale lúc 0h là bài thử nghiệm khắc nghiệt nhất. Hàng trăm nghìn người dùng đồng thời truy cập vào cùng danh mục khuyến mãi, dồn ép truy vấn vào một số lượng khóa cực kỳ giới hạn.
Nếu thông tin sản phẩm gom vào một Hash duy nhất, lệnh HGETALL gọi dồn dập sẽ làm nghẽn Event Loop ngay lập tức. Giải pháp là băm nhỏ khóa bằng Key Sharding và bật Client-side Caching với tính năng Tracking trong giao thức RESP3 để ứng dụng lưu bản sao đệm ngay trong RAM của pod backend.
Phòng ban công nghệ tài chính và cổng thanh toán trực tuyến
Trong lĩnh vực FinTech, tính toàn vẹn dữ liệu và độ trễ giao dịch đòi hỏi tiêu chuẩn micro-giây khắt khe. Các kỹ sư tài chính thường dùng Redis quản lý hạn mức và khóa phân tán Redlock để chống thanh toán kép Double Spending.
Nếu khóa phân tán đặt TTL quá ngắn trong khi luồng Redis gián đoạn do snapshot, khóa bị giải phóng sớm làm sai lệch số dư. Kỹ sư cần kết hợp linh hoạt nguyên lý khóa với cơ chế locking dữ liệu chuẩn mực để bảo vệ an toàn cho dòng tiền doanh nghiệp.
Phòng ban dịch vụ trò chơi trực tuyến và phát sóng đa phương tiện
Hệ thống Game Online và Live Streaming thường dùng Sorted Set (ZSet) duy trì bảng xếp hạng Leaderboard theo thời gian thực. Mỗi khi người chơi ghi điểm, hệ thống phát lệnh ZADD và liên tục lấy danh sách người dẫn đầu qua ZREVRANGE.
Khi bảng xếp hạng lên hàng triệu thành viên, truy vấn khoảng rộng ngốn lượng lớn chu kỳ CPU. Giải pháp là chia bảng xếp hạng theo Rank hoặc mùa giải, chỉ giữ top 100 trong Redis và lưu lịch sử dài hạn vào cơ sở dữ liệu quan hệ tuân thủ tính chất ACID trong cơ sở dữ liệu an toàn.
Kiến trúc xử lý bất đồng bộ và tối ưu hóa connection pool phía ứng dụng
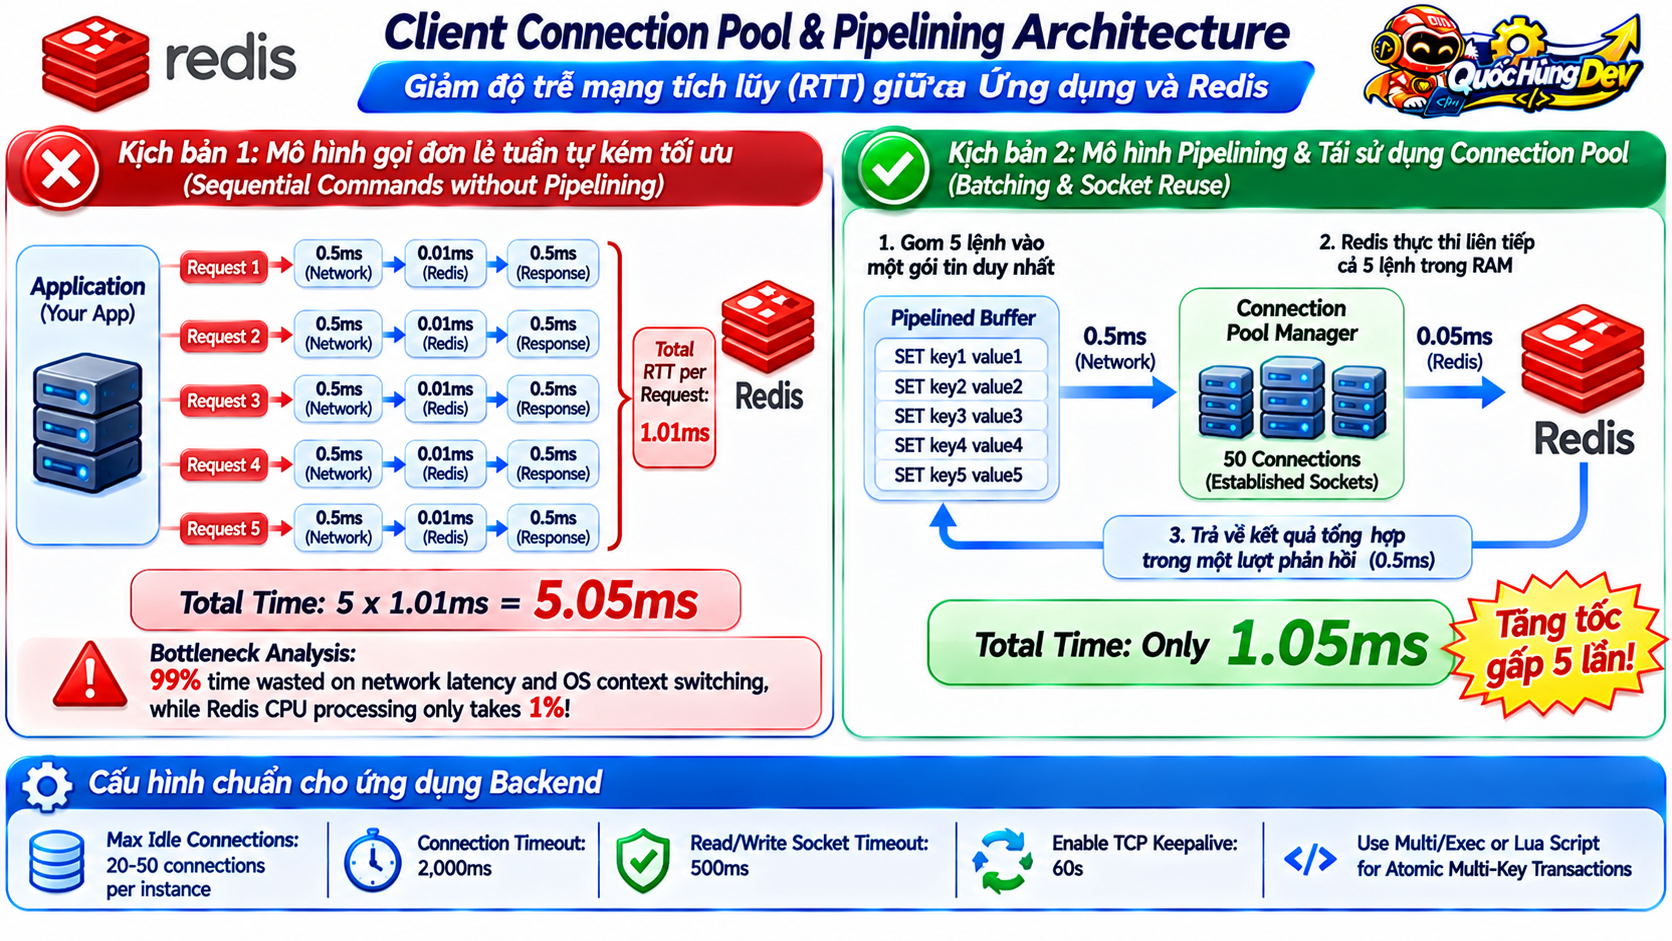
Hơn 70% trường hợp ứng dụng báo lỗi timeout xuất phát từ việc cấu hình sai thư viện client ở máy chủ ứng dụng. Nhóm kỹ sư cần ghi nhớ các lưu ý chống nghẽn hàng đợi redis thông qua việc định cỡ nhóm kết nối Connection Pool và thiết lập thời gian chờ đa tầng một cách khoa học.
Sơ đồ kiến trúc ở trên minh họa cách thức các cơ chế bảo vệ chủ động ngăn chặn thảm họa cạn kiệt tài nguyên luồng ứng dụng. Nhằm hỗ trợ quy trình khắc phục độ trễ redis đạt hiệu quả dài hạn, chúng ta cần triển khai đồng bộ 3 kỹ thuật cốt lõi sau đây trong tầng mã nguồn dịch vụ.
Công thức định cỡ connection pool theo thông lượng thực tế
Nhiều lập trình viên sai lầm khi đặt số kết nối tối đa lên 500 hoặc 1000 cho mỗi pod. Trong cụm Kubernetes với hàng trăm pod, hành vi này tạo ra hàng chục nghìn kết nối đồng thời ép xuống Redis, làm cạn bộ nhớ RAM chỉ để nuôi bộ đệm socket.
Kích thước pool tối ưu cần tính theo định luật Little: Kích thước bằng QPS nhân Latency chia cho Hệ số đồng thời. Với dịch vụ 2.000 QPS và độ trễ Redis 1 mili-giây, kích thước pool lý tưởng chỉ cần 10 đến 25 kết nối cho mỗi tiến trình, giúp giải phóng tài nguyên hệ điều hành.
Chiến lược thiết lập thời gian chờ timeout đa tầng
Việc không cấu hình hoặc để timeout mặc định 5 giây khiến một đợt chậm tạm thời biến thành sự cố sụp đổ toàn bộ dịch vụ web. Kỹ sư cần siết Command Timeout từ 50 đến 100 mili-giây để ứng dụng ngắt kết nối và giải phóng thread kịp thời khi cache không phản hồi.
// Cấu hình mẫu cho ioredis trong Node.js
const Redis = require("ioredis");
const redis = new Redis({
  host: "10.0.1.20",
  port: 6379,
  connectTimeout: 500,     // Chờ kết nối TCP tối đa 500ms
  commandTimeout: 100,     // Chờ lệnh tối đa 100ms
  maxRetriesPerRequest: 1  // Giới hạn thử lại tránh bão retry
});
Mô hình ngắt mạch circuit breaker và dữ liệu dự phòng stale cache
Để hoàn thiện hệ thống phòng thủ, dịch vụ cần tích hợp Circuit Breaker. Khi tỷ lệ lỗi hoặc độ trễ từ Redis vượt ngưỡng an toàn (ví dụ trên 15% trong 10 giây), khối ngắt mạch chuyển sang trạng thái Open, tạm dừng gửi truy vấn xuống bộ nhớ đệm.
Ứng dụng sẽ chủ động trả về dữ liệu dự phòng Stale Data hoặc kích hoạt kịch bản giảm tải thay vì báo lỗi 504. Khi độ trễ Redis bình thường trở lại, Circuit Breaker chuyển qua Half-Open để thăm dò trước khi đóng hoàn toàn vòng bảo vệ. Bạn có thể tham khảo trực tiếp các mẫu triển khai từ mã nguồn mở Redis trên GitHub để tích hợp vào ứng dụng.
Chi phí tối ưu cụm Redis và dự toán ngân sách hạ tầng
Khi quy mô dịch vụ mở rộng, bài toán cân đối chi phí tối ưu cụm redis trở thành mối quan tâm hàng đầu của các giám đốc công nghệ CTO và kỹ sư trưởng hạ tầng. Một chiến lược hạ tầng thông minh không chỉ giải quyết triệt để bài toán hiệu năng mà còn phải tối ưu hóa từng đồng ngân sách chi trả cho tài nguyên phần cứng và điện toán đám mây.
Để tối ưu ngân sách khi khắc phục độ trễ redis, việc so sánh redis standalone và cluster là trọng tâm kỹ thuật then chốt giúp doanh nghiệp đưa ra quyết định đầu tư đúng đắn. Việc chuyển dịch từ mô hình máy chủ đơn lẻ lên cụm phân mảnh dữ liệu đòi hỏi sự đánh đổi rõ ràng giữa chi phí bản quyền, độ phức tạp vận hành và năng lực đáp ứng độ trễ.
| Mô hình triển khai | Chi phí phần cứng ước tính | Năng lực chịu tải QPS | Độ trễ trung bình | Mức độ phức tạp vận hành |
|---|---|---|---|---|
| Tự host Standalone VM | $80 – $250 / tháng | 20.000 – 60.000 QPS | 0.3 – 0.8 ms | Thấp, dễ cấu hình và sao lưu |
| Tự host Redis Cluster (6 nodes) | $450 – $1.200 / tháng | 150.000 – 500.000 QPS | 0.5 – 1.2 ms | Cao, đòi hỏi quản trị hash slot |
| AWS ElastiCache Managed | $800 – $3.500 / tháng | Không giới hạn (Scale tự động) | 0.8 – 1.5 ms | Rất thấp, nhà cung cấp lo bảo trì |
| Redis Enterprise Cloud | $1.500 – $6.000 / tháng | Hàng triệu QPS với Active-Active | 0.2 – 0.5 ms | Thấp, hỗ trợ SLA 99.999% |
Mô hình tự quản trị Standalone mang lại tỷ suất chi phí trên hiệu năng tốt cho hệ thống vừa và nhỏ. Khi vượt ngưỡng 100.000 QPS, việc đầu tư cụm phân tán Sharding là bắt buộc để phân bổ tải sang nhiều nhân vi xử lý độc lập.
Nếu doanh nghiệp của bạn đang theo đuổi các giải pháp tối ưu hóa tổng thể trải nghiệm người dùng web, việc cải thiện tốc độ bộ nhớ đệm cần được phối hợp nhịp nhàng với lộ trình tối ưu chỉ số TTFB nhằm giảm thiểu thời gian chờ byte đầu tiên của trang web về mức dưới 200 mili-giây trên toàn cầu.
Ma trận ra quyết định kiến trúc bộ nhớ đệm theo quy mô hệ thống
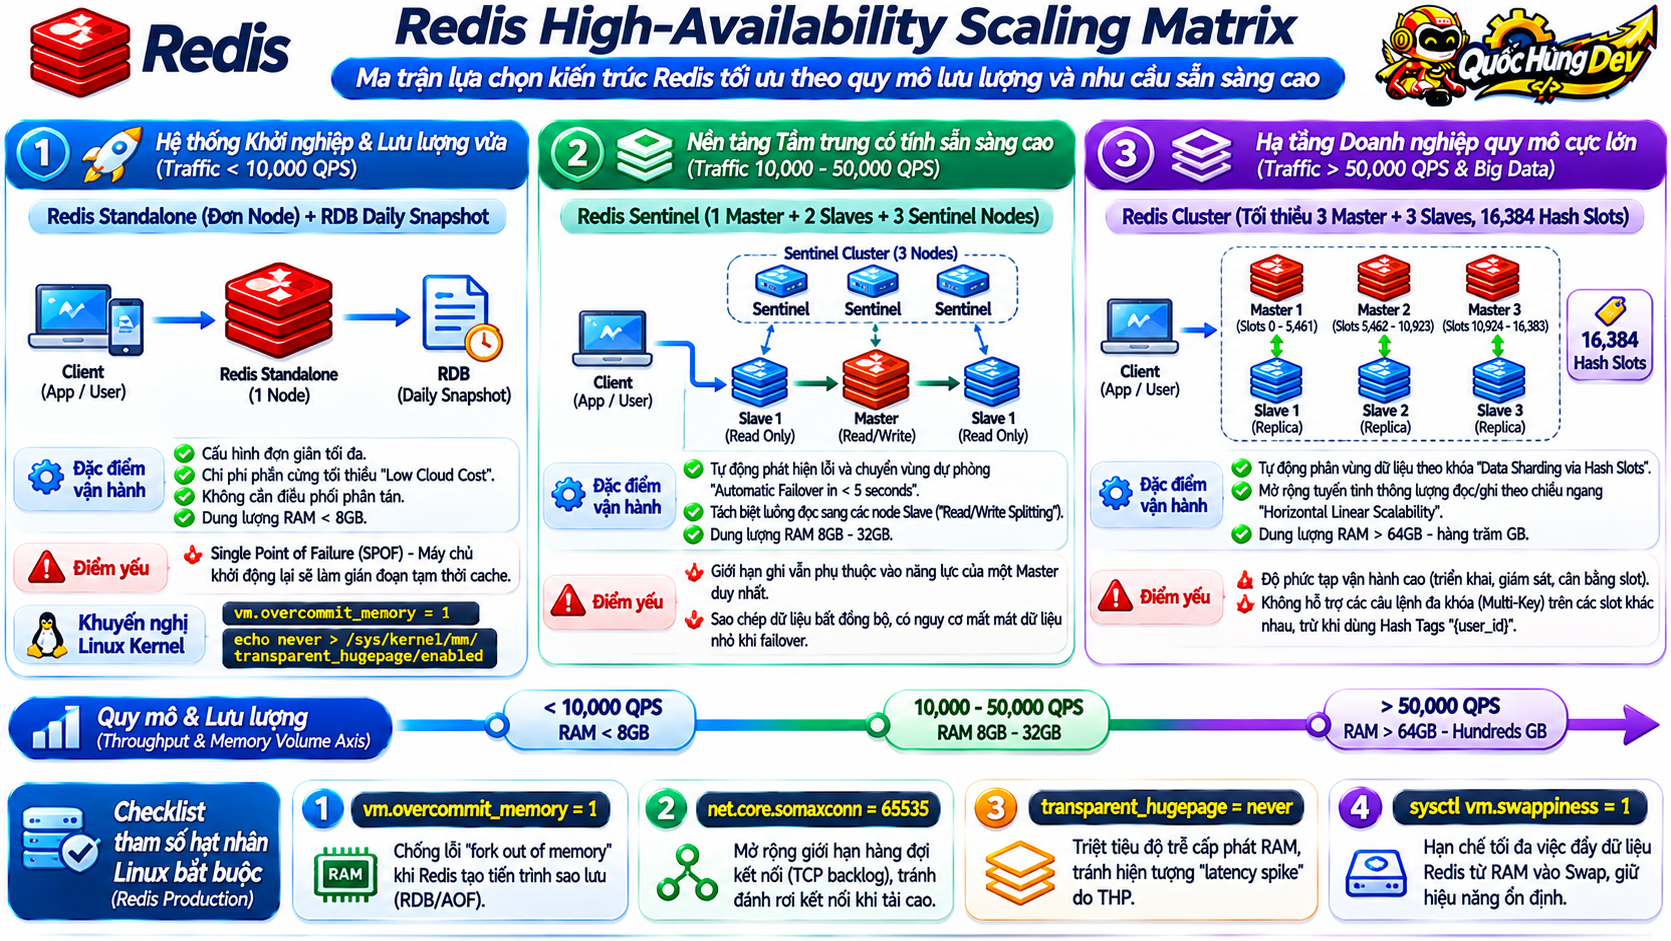
Nhằm loại bỏ sự mơ hồ trong việc thiết kế kiến trúc, ma trận ra quyết định dưới đây được chuẩn hóa thành 3 phân khúc rõ rệt, tương ứng với quy mô người dùng và thông lượng giao dịch thực tế của doanh nghiệp trong kỷ nguyên chuyển đổi số.
Phân khúc khởi nghiệp < 5.000 QPS
Ở giai đoạn ban đầu, ưu tiên số một là sự tinh gọn và tốc độ triển khai. Kiến trúc khuyến nghị là một máy chủ Redis Standalone duy nhất chạy trên máy chủ ảo 2 vCPU và 4GB RAM.
Tắt toàn bộ tiến trình RDB định kỳ trên môi trường chính và chỉ kích hoạt AOF với chế độ appendfsync everysec để cân bằng giữa an toàn dữ liệu và hiệu năng ghi. Đặt giới hạn maxmemory-policy là allkeys-lru để tự động loại bỏ các khóa ít sử dụng.
Phân khúc tăng trưởng 5.000 – 50.000 QPS
Khi sản phẩm bắt đầu có lượng người dùng ổn định, tính sẵn sàng cao trở thành điều kiện tiên quyết. Kiến trúc tối ưu là mô hình Master-Replica kết hợp với cụm 3 node Redis Sentinel để tự động phát hiện sự cố và chuyển đổi dự phòng Failover.
Tách biệt hoàn toàn luồng đọc và ghi: đẩy toàn bộ tác vụ đọc dữ liệu sang các nút Replica, trong khi nút Master chỉ tập trung tiếp nhận các thao tác ghi và cập nhật. Kích hoạt tính năng Multi-threaded I/O với 3 luồng phụ trợ để tối ưu thông lượng mạng.
Phân khúc nền tảng lớn > 100.000 QPS
Ở quy mô doanh nghiệp lớn với lưu lượng khổng lồ, kiến trúc bắt buộc phải chuyển sang cụm Redis Cluster phân mảnh dữ liệu dựa trên 16.384 Hash Slots, bao gồm tối thiểu 3 Master nodes và 3 Replica nodes tương ứng.
Tích hợp cơ chế Client-side Caching thông qua tính năng Tracking trong giao thức RESP3 nhằm lưu giữ bản sao dữ liệu nóng trực tiếp trong RAM của các pod microservices, giảm thiểu tới 85% lưu lượng mạng đi tới cụm máy chủ trung tâm.
Việc áp dụng đúng ma trận kiến trúc trên sẽ giúp các kỹ sư trưởng tự tin bảo vệ hệ thống trước mọi đợt tăng trưởng đột biến, ngăn ngừa triệt để nguy cơ quá tải phần cứng và giảm thiểu tối đa các sự cố kỹ thuật ngoài ý muốn.
Checklist an toàn hạ tầng và lưu ý tuân thủ ToS khi vận hành cache
Khi tiến hành các bước kỹ thuật nhằm khắc phục độ trễ redis, việc tuân thủ các quy tắc bảo mật và chính sách điều khoản dịch vụ (ToS) là nền tảng bảo vệ sự an toàn của toàn bộ tổ chức. Rất nhiều sự cố rò rỉ dữ liệu nghiêm trọng xuất phát từ sự chủ quan trong việc bảo vệ cổng dịch vụ bộ nhớ đệm.
Cảnh báo an toàn: Tuyệt đối không bao giờ mở công khai cổng TCP 6379 của Redis ra môi trường Internet công cộng mà không có lớp bảo vệ mạng ảo hóa VPC và tường lửa nghiêm ngặt. Hàng chục nghìn máy chủ Redis đã bị cài mã độc đào tiền ảo chỉ sau vài phút xuất bản IP công khai do thiếu cơ chế xác thực.
Trước khi đưa bất kỳ cấu hình tối ưu hóa nào lên môi trường sản xuất chính thức, đội ngũ kỹ thuật bắt buộc phải rà soát và đánh dấu hoàn thành toàn bộ 8 hạng mục an toàn trong danh sách kiểm tra tiêu chuẩn dưới đây:
1. Đổi tên và vô hiệu hóa các lệnh nguy hiểm: Sử dụng chỉ thị rename-command trong tệp cấu hình redis.conf để vô hiệu hóa hoàn toàn hoặc gán chuỗi bí mật phức tạp cho các lệnh có sức hủy diệt cao như FLUSHALL, FLUSHDB, KEYS, CONFIG, SHUTDOWN và DEBUG.
2. Bật cơ chế xác thực mật khẩu mạnh: Thiết lập tham số requirepass với mật khẩu có độ dài tối thiểu 32 ký tự ngẫu nhiên hoặc triển khai danh sách điều khiển truy cập phân quyền người dùng ACL (Access Control Lists) có sẵn từ phiên bản Redis 6.0 trở lên.
3. Cô lập mạng nội bộ VPC: Ràng buộc dịch vụ chỉ lắng nghe trên địa chỉ IP nội bộ thông qua chỉ thị bind 10.0.x.x 127.0.0.1 và cấu hình Security Group nghiêm ngặt, chỉ cho phép các máy chủ ứng dụng được chỉ định truy cập vào cổng 6379.
4. Giới hạn trần bộ nhớ tối đa: Bắt buộc thiết lập thông số maxmemory (khuyến nghị đặt mức 75% đến 80% tổng dung lượng RAM vật lý của máy chủ) nhằm dự phòng không gian an toàn cho bảng phân trang Page Table, bộ đệm kết nối và tiến trình fork Copy-on-Write.
5. Chính sách giải phóng bộ nhớ chủ động: Lựa chọn chính sách maxmemory-policy phù hợp với bản chất nghiệp vụ, ưu tiên sử dụng volatile-lru hoặc allkeys-lru để tự động thu hồi tài nguyên một cách mềm dẻo khi bộ nhớ chạm ngưỡng giới hạn.
6. Mã hóa đường truyền TLS: Kích hoạt giao thức bảo mật tầng truyền tải TLS cho toàn bộ các luồng giao tiếp giữa ứng dụng và máy chủ Redis trên môi trường Cloud để phòng chống nghe lén và giả mạo gói tin trong mạng phân tán.
7. Tắt tính năng swap của hệ điều hành: Cấu hình giá trị sysctl vm.swappiness = 1 hoặc tắt phân vùng swap để đảm bảo tiến trình Redis không bao giờ bị tráo đổi dữ liệu xuống đĩa cứng, duy trì độ trễ nano-giây ổn định.
8. Tuân thủ quyền riêng tư dữ liệu: Tuyệt đối không lưu trữ dữ liệu nhạy cảm của người dùng (mật khẩu dạng rõ, thông tin thẻ tín dụng, số căn cước) vào bộ nhớ đệm mà không có lớp mã hóa đầu cuối nhằm tuân thủ tuyệt đối các tiêu chuẩn bảo mật dữ liệu PCI-DSS và ToS quốc tế.
Câu hỏi thường gặp về độ trễ và hiệu năng Redis
Dưới đây là phần giải đáp chi tiết cho những thắc mắc kỹ thuật phổ biến nhất được các kỹ sư hệ thống và lập trình viên backend đặt ra trong quá trình vận hành hạ tầng lưu trữ đệm hiệu năng cao.
Tại sao lệnh PING vẫn trả về PONG trong khi ứng dụng liên tục bị lỗi 504 Gateway Timeout?
Lệnh PING là thao tác cực nhẹ O(1) chỉ yêu cầu tài nguyên tối thiểu để xác nhận socket TCP mở và event loop chưa treo hoàn toàn. Khi xuất hiện lệnh chạy chậm như HGETALL hoặc bão dọn rác TTL Storm, các câu lệnh GET thông thường bị dồn ứ tại Client Input Buffer. Do ứng dụng có Command Timeout hữu hạn (100ms), luồng xử lý web hết hạn chờ và trả về lỗi 504 Gateway Timeout trước khi câu lệnh được luồng chính xử lý.
Làm thế nào để phát hiện và xử lý big key mà không làm ảnh hưởng đến môi trường Production?
Tuyệt đối không dùng lệnh KEYS * trên môi trường thật. Hãy dùng redis-cli với cờ –bigkeys và tham số giãn cách -i 0.05 để chèn khoảng nghỉ 50 mili-giây sau mỗi 100 truy vấn SCAN, giữ tải CPU luôn thấp. Khi xóa big key, hãy dùng lệnh UNLINK thay vì DEL để chuyển việc giải phóng bộ nhớ sang luồng ngầm Background Bio Thread độc lập.
Tại sao chỉ số CPU tổng thể trên máy chủ chỉ có 35% nhưng Redis đã bị tắc nghẽn?
Hệ thống giám sát như Grafana hoặc lệnh top hiển thị CPU Usage trung bình cộng của toàn bộ các nhân vi xử lý. Trên máy chủ 4 vCPU, nếu luồng chính duy nhất của Redis ngốn 100% công suất của 1 nhân trong khi 3 nhân còn lại nhàn rỗi (0%), chỉ số CPU trung bình hiển thị chỉ là 25%. Sự chủ quan này khiến kỹ sư lầm tưởng hệ thống còn dư tải trong khi hạt nhân xử lý Redis đã bão hòa hoàn toàn.
Có nên tắt hoàn toàn tính năng lưu dữ liệu ra đĩa Persistence trên Redis không?
Nếu cụm Redis chỉ đóng vai trò bộ nhớ đệm tạm thời (Cache-Aside Pattern) mà cơ sở dữ liệu quan hệ phía sau có thể tái nạp an toàn, việc tắt lưu đĩa RDB và AOF trên node Master giúp triệt tiêu hoàn toàn độ trễ từ fork() và nghẽn I/O. Nếu có node Replica, bạn có thể bật sao lưu RDB trên Replica để dự phòng thảm họa mà không ảnh hưởng hiệu năng Master.
Sự khác biệt cốt lõi giữa Redis 7.0 và các phiên bản mới hơn như Redis 8.8 trong việc tối ưu hóa độ trễ là gì?
Các bản phát hành mới tối ưu sâu công nghệ Multi-threaded I/O, nâng cấp giao thức RESP3 với cơ chế vô hiệu hóa cache phía client và tái cấu trúc jemalloc giúp giảm tới 40% phân mảnh RAM. Bạn có thể tìm hiểu thêm về các bước tiến này trong bài viết về bản cập nhật Redis 8.8 để nắm bắt xu hướng kỹ thuật tiên phong.
Kết luận và định hướng quản trị Redis hiệu năng cao
Tổng kết lại, bài toán khắc phục độ trễ redis khi máy chủ vẫn báo cáo UP là phép thử toàn diện về năng lực am hiểu kiến trúc hạt nhân và tư duy vận hành hệ thống phân tán của kỹ sư. Chỉ báo màu xanh trên dashboard không đồng nghĩa với việc người dùng đang có trải nghiệm truy cập mượt mà.
Chìa khóa xây dựng hạ tầng đệm kiên cố là nhận thức rõ bản chất vòng lặp sự kiện đơn luồng, chủ động loại bỏ big key và bão hết hạn TTL Storm, áp dụng linh hoạt công cụ chẩn đoán chuyên dụng và thiết lập vòng bảo vệ đa tầng từ ứng dụng.
Trong tương lai dữ liệu lớn, việc kết hợp kiến trúc phân mảnh, cơ chế Client-side Caching thông minh và tăng tốc mạng eBPF sẽ là chuẩn mực bắt buộc. Bằng việc tuân thủ các nguyên tắc thiết kế trong cẩm nang này, hệ thống của bạn sẽ luôn duy trì hiệu năng đỉnh cao và sẵn sàng trước mọi thử thách quy mô.