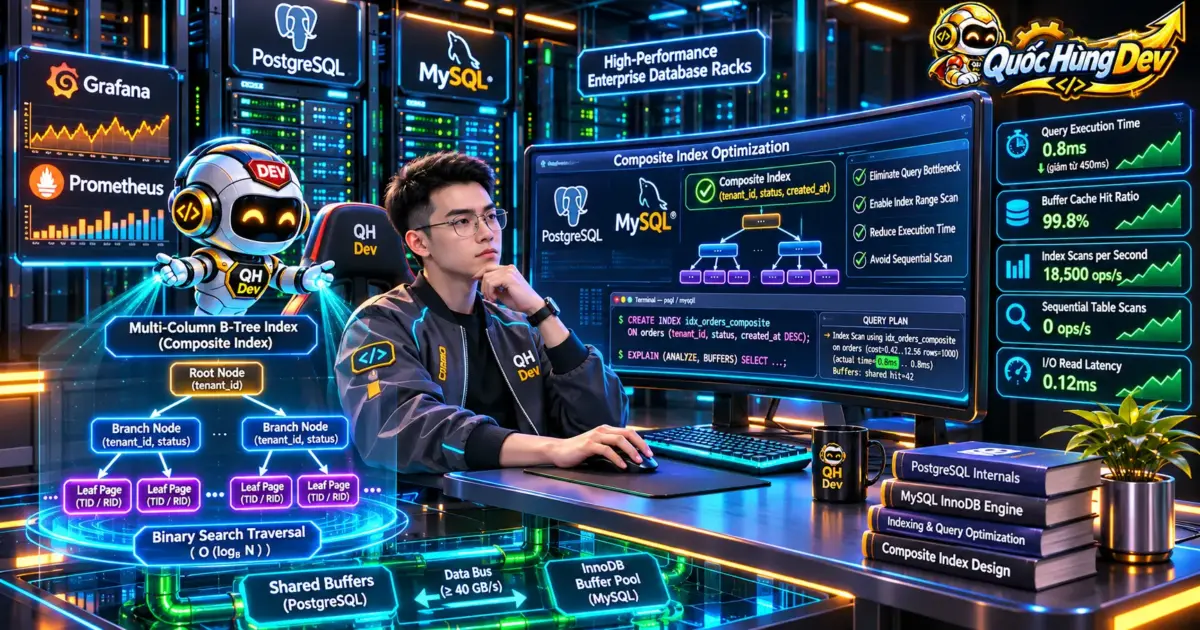
Composite index là gì trong thiết kế cơ sở dữ liệu quan hệ luôn là bài toán sống còn khi lưu lượng truy cập hệ thống bùng nổ mạnh mẽ. Về mặt kiến trúc, đây là cấu trúc chỉ mục cây B-tree đa cột được khởi tạo trên cùng một bảng dữ liệu nhằm phục vụ tối ưu cho các truy vấn lọc đa điều kiện đồng thời.
Trong các hệ thống sản xuất thực tế, việc thiếu vắng chỉ mục đa cột phù hợp sẽ đẩy cụm máy chủ vào tình trạng cạn kiệt tài nguyên xử lý dữ liệu. Khi số lượng bản ghi chạm ngưỡng hàng triệu dòng, các truy vấn phức tạp buộc bộ xử lý phải quét tuần tự toàn bộ bảng, gây nghẽn hàng đợi nghiêm trọng.
Bài viết phân tích chuyên sâu toàn diện cơ chế vận hành của chỉ mục kết hợp trên MySQL và PostgreSQL. Độc giả sẽ hiểu rõ nguyên tắc tiền tố bên trái, cách giải mã chỉ số trong câu lệnh EXPLAIN, trật tự sắp xếp cột chuẩn mực và kỹ thuật loại bỏ hoàn toàn các tác vụ sắp xếp tốn kém trong bộ nhớ RAM.
Bản chất composite index là gì và cơ chế hoạt động B-tree đa cột
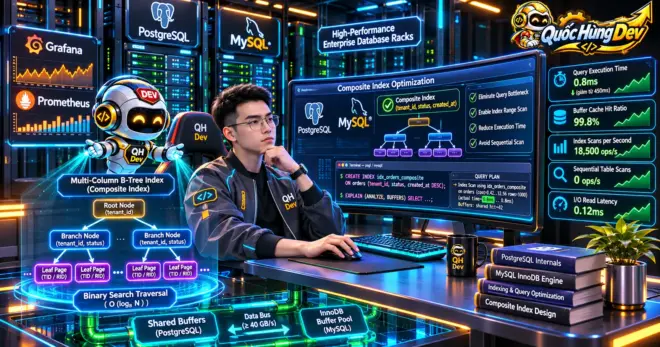
Để trả lời cặn kẽ câu hỏi composite index là gì, kỹ sư backend cần xuất phát từ cấu trúc phân tầng của cây tìm kiếm cân bằng B-tree. Khác với chỉ mục đơn cột chỉ lưu trữ một khóa duy nhất, chỉ mục kết hợp lưu trữ một bộ khóa gồm nhiều giá trị cột nối tiếp nhau trên từng trang lá của cây.
Không gian lưu trữ bên trong một composite index được tổ chức theo quy luật sắp xếp từ điển phân cấp vô cùng nghiêm ngặt. Hệ thống sẽ căn cứ vào giá trị của cột đầu tiên được định nghĩa trong câu lệnh khởi tạo để phân nhánh từ nút gốc xuống các nút trung gian của cây chỉ mục.
Chỉ khi các bản ghi có giá trị hoàn toàn trùng khớp ở cột thứ nhất, cơ sở dữ liệu mới tiếp tục so sánh và phân nhánh dựa trên giá trị của cột thứ hai. Quá trình này tiếp tục lặp lại đối với cột thứ ba và các cột tiếp theo, tạo nên một chuỗi trật tự sắp xếp lồng nhau chặt chẽ trên không gian lưu trữ vật lý.
Phân cấp cấu trúc cây từ nút gốc đến các trang lá
Trong cấu trúc của composite index là gì, một cây B-tree đa cột tiêu chuẩn bao gồm ba tầng vật lý cơ bản: nút gốc trên cùng, các nút phân nhánh trung gian và các trang lá ở tầng đáy. Mỗi trang đĩa có kích thước cố định là 8KB trên PostgreSQL hoặc 16KB trên MySQL InnoDB, chứa các phần tử khóa kèm con trỏ liên kết đến trang cấp dưới hoặc dòng dữ liệu thực tế.
Khi tiếp nhận một câu lệnh tìm kiếm, bộ tối ưu hóa truy vấn sẽ so khớp các điều kiện lọc với các khóa dẫn đường tại nút gốc. Nhờ cấu trúc phân tầng cân bằng, hệ thống có thể loại bỏ hàng triệu nhánh dữ liệu không phù hợp chỉ sau vài phép so sánh nhị phân, duy trì độ phức tạp thời gian ở mức logarithm tối ưu.
Trong tầng lá của composite index là gì, các trang lá được liên kết với nhau thành một danh sách liên kết đôi hai chiều hoàn chỉnh. Cấu trúc danh sách liên kết này đóng vai trò quyết định trong việc hỗ trợ quét phạm vi dữ liệu liên tục, cho phép con trỏ đọc dữ liệu xuôi hoặc ngược chiều một cách nhanh chóng mà không cần duyệt lại từ nút gốc.
Cơ chế sắp xếp từ điển và tương đồng danh bạ điện thoại
Một hình ảnh so sánh kinh điển giúp chúng ta hình dung trực quan bản chất composite index là gì chính là cuốn danh bạ điện thoại truyền thống. Trong danh bạ, toàn bộ danh sách thuê bao luôn được sắp xếp ưu tiên theo họ trước, sau đó những người trùng họ mới được sắp xếp tiếp theo tên đệm và tên chính.
Nếu bạn cần tra cứu một người mang họ Nguyễn và có tên là Hùng, việc tìm kiếm diễn ra gần như tức thì. Bạn chỉ việc lật mở đúng khu vực dành riêng cho họ Nguyễn, sau đó nhanh chóng rà soát đến tên Hùng vì toàn bộ dữ liệu mục tiêu đã nằm tập trung trong một phạm vi trang liên tục.
Ngược lại, nếu bạn nhận được yêu cầu tìm tất cả những người có tên là Hùng nhưng không hề biết họ của họ là gì, cuốn danh bạ hoàn toàn mất đi lợi thế sắp xếp. Bạn buộc phải lật giở từng trang từ đầu đến cuối để kiểm tra từng dòng, hành vi này hoàn toàn tương đương với thao tác quét toàn bộ bảng trong cơ sở dữ liệu.
Khác biệt con trỏ vật lý giữa PostgreSQL heap và MySQL InnoDB
Khi tìm hiểu sâu về composite index là gì, điểm khác biệt kiến trúc then chốt giữa các hệ quản trị nằm ở cách thức các trang lá trỏ về bản ghi thực tế. Trong PostgreSQL, bảng dữ liệu được tổ chức dưới dạng cấu trúc heap không thứ tự, và mỗi mục chỉ mục sẽ chứa một con trỏ định danh bộ dữ liệu bao gồm chỉ số khối trang và số thứ tự dòng bên trong khối đó.
Đối với động cơ InnoDB của MySQL, bảng dữ liệu được tổ chức theo cấu trúc chỉ mục cụm dựa trên khóa chính. Mọi chỉ mục thứ cấp bao gồm cả composite index đều lưu trữ giá trị khóa chính làm con trỏ định vị, đòi hỏi hệ thống phải thực hiện thêm bước tra cứu thứ cấp trên cây chỉ mục chính để lấy các cột dữ liệu còn lại.
Bảng so sánh tổng quan hiệu năng truy vấn có và không có composite index
Để đánh giá tác động thực tế của việc hiểu rõ composite index là gì và áp dụng chỉ mục kết hợp, chúng ta tiến hành khảo sát trên một bảng giao dịch chứa 200.000 bản ghi đơn hàng của 5.000 khách hàng. Dữ liệu thử nghiệm phản ánh các mẫu truy vấn phổ biến trong hệ thống thương mại điện tử với các điều kiện lọc kết hợp giữa mã khách hàng, trạng thái và thời gian khởi tạo.
| Tiêu chí đánh giá | Không có composite index | Có composite index chuẩn | Mức độ cải thiện |
|---|---|---|---|
| Kiểu quét dữ liệu | Parallel Seq Scan / Full Table Scan | Bitmap Index Scan / Index Scan | Thu hẹp 99.8% phạm vi |
| Số trang đĩa I/O tiêu thụ | 1.667 pages (Shared Buffers) | 3 pages index + 13 pages heap | Giảm 99.04% dung lượng đọc |
| Số dòng quét và loại bỏ | Loại bỏ 199.987 dòng không khớp | Chỉ đọc đúng 13 dòng thỏa mãn | 0 dòng thừa bị duyệt |
| Thời gian thực thi trung bình | 7.160 miligiây | 0.042 miligiây | Tăng tốc hơn 170 lần |
| Tải trọng CPU worker | Kích hoạt đa luồng xử lý quét bảng | Chạy đơn luồng trên bộ nhớ đệm | Giải phóng hoàn toàn CPU |
| Mức độ cạnh tranh bộ nhớ đệm | Chiếm dụng lượng lớn bộ đệm I/O | Chỉ nạp các trang lá cần thiết | Bảo toàn vùng đệm buffer pool |
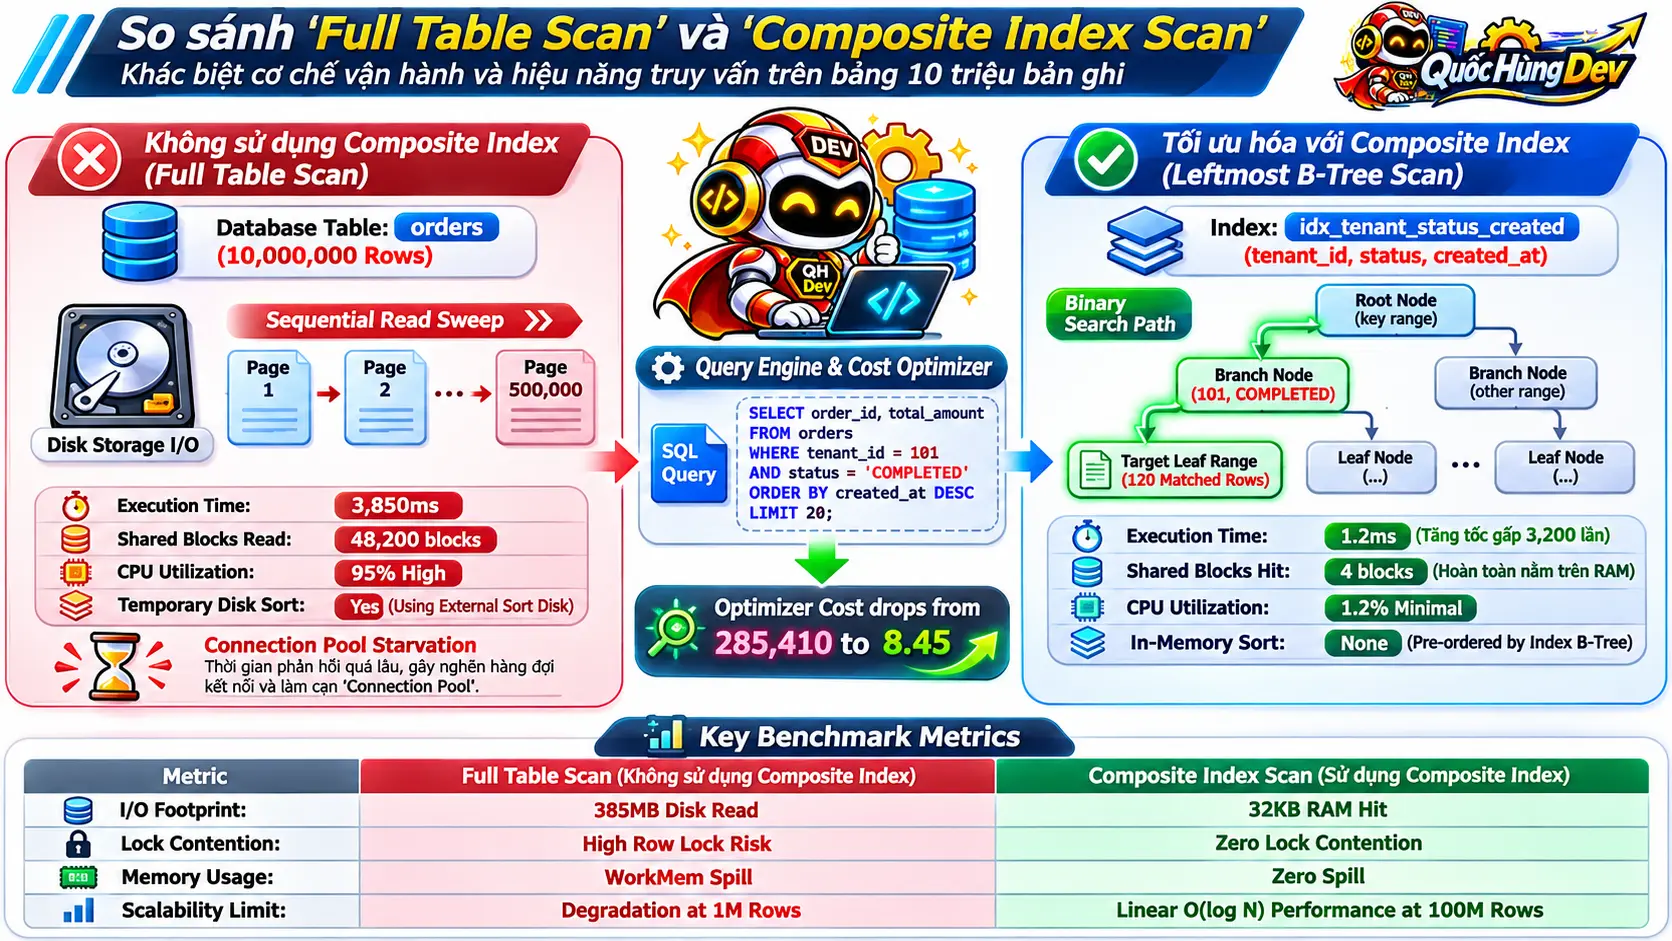
Bảng số liệu trên minh chứng rõ ràng sự vượt trội về mặt tài nguyên khi áp dụng đúng chỉ mục đa cột. Thay vì phải huy động nhiều tiến trình song song để quét qua toàn bộ 1.667 trang dữ liệu của bảng, hệ thống chỉ cần đọc vỏn vẹn 3 trang chỉ mục để định vị chính xác vị trí của 13 bản ghi thỏa mãn điều kiện.
Sự suy giảm về lưu lượng đọc đĩa giúp giảm thiểu tối đa hiện tượng cạnh tranh tài nguyên trên vùng đệm bộ nhớ dùng chung. Trong môi trường có hàng nghìn người dùng truy cập đồng thời, việc giảm số trang đọc từ hàng nghìn xuống hàng chục trang là yếu tố sống còn để ngăn chặn tình trạng nghẽn cổ chai I/O.
Nguyên tắc leftmost prefix trong database và vùng tìm kiếm chỉ mục
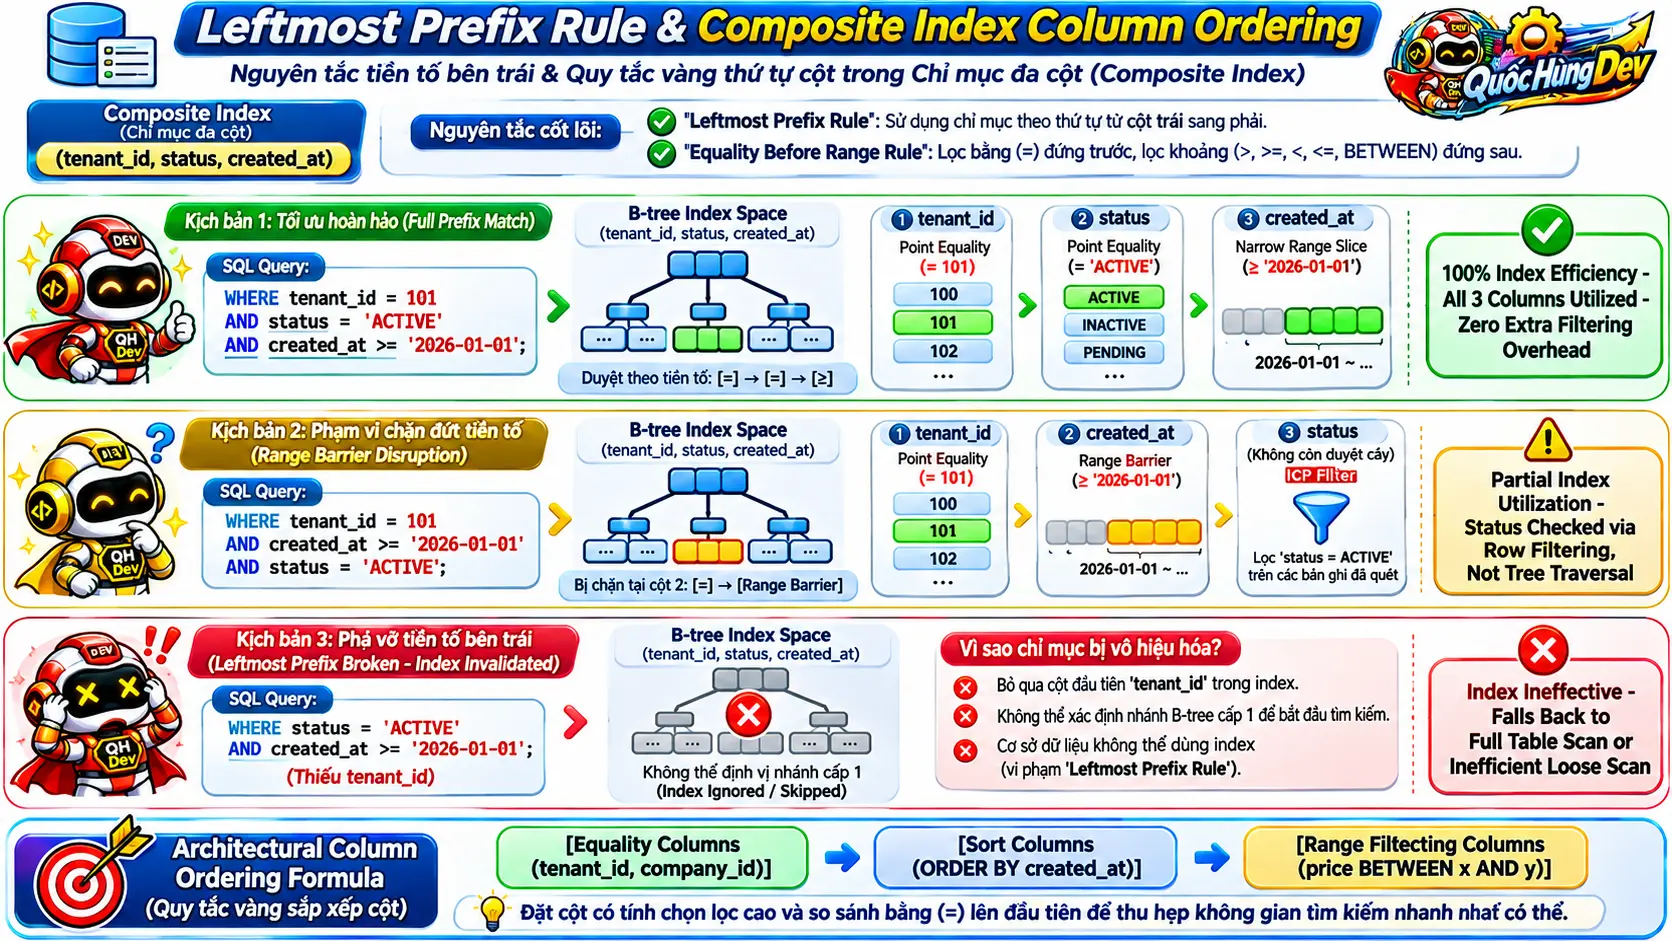
Khái niệm cốt lõi chi phối bản chất composite index là gì và khả năng hoạt động của chỉ mục nhiều cột chính là nguyên tắc leftmost prefix trong database. Quy tắc này quy định rằng một composite index được khởi tạo trên danh sách các cột (A, B, C) sẽ chỉ hỗ trợ tăng tốc cho các truy vấn có điều kiện lọc chứa tiền tố liên tục tính từ mép ngoài cùng bên trái.
Cụ thể, khi phân tích composite index là gì, chỉ mục trên bộ ba cột (A, B, C) sẽ tự động phục vụ tối ưu cho ba nhóm truy vấn: truy vấn chỉ lọc theo cột (A), truy vấn lọc kết hợp theo hai cột (A, B), và truy vấn lọc đầy đủ cả ba cột (A, B, C). Đây là lý do tại sao một chỉ mục kết hợp được thiết kế tốt có thể thay thế hoàn toàn cho các chỉ mục đơn lẻ đứng trước nó.
Ngược lại, nếu câu lệnh truy vấn của ứng dụng bỏ qua cột đầu tiên (A) mà chỉ lọc theo các cột phía sau như (B), (C) hoặc cặp (B, C), cây B-tree sẽ không thể sử dụng cấu trúc phân nhánh để định vị vùng dữ liệu. Khi đó, bộ tối ưu hóa buộc phải từ bỏ việc duyệt chỉ mục và quay trở lại phương án quét toàn bảng.
Tại sao thứ tự cột xác định ranh giới định vị vùng quét
Bản chất của việc không thể sử dụng chỉ mục khi thiếu tiền tố bên trái bắt nguồn từ sự phân mảnh không gian giá trị trên cây B-tree. Hãy xem xét cột B lưu trữ trạng thái đơn hàng bao gồm các giá trị đã thanh toán hoặc đang xử lý. Trong cây chỉ mục, các bản ghi có trạng thái đã thanh toán không hề nằm tập trung tại một vùng liên tục.
Thay vào đó, các giá trị của cột B bị phân tán nhỏ lẻ bên trong từng giá trị riêng biệt của cột A. Với mỗi khách hàng khác nhau, các đơn hàng đã thanh toán lại xuất hiện ở một nhánh con độc lập. Do không có điều kiện ràng buộc ở cột A, database engine không có cách nào nhảy thẳng tới một điểm bắt đầu duy nhất để quét một mạch qua các trang lá.
Chính sự phân tán này biến việc đọc chỉ mục trở nên vô nghĩa nếu không có tiền tố bên trái để khóa chặt phạm vi phân nhánh. Việc quét qua toàn bộ các nhánh con của cây chỉ mục để thu thập dữ liệu rải rác đôi khi còn tiêu tốn nhiều thao tác I/O ngẫu nhiên hơn so với việc quét tuần tự trực tiếp trên bảng dữ liệu chính.
Hiện tượng nhảy cóc cột trung gian và suy giảm hiệu quả chỉ mục
Một kịch bản thường gây nhầm lẫn trong thực tế là câu truy vấn có chứa cột đầu tiên và cột thứ ba, nhưng lại bỏ qua cột thứ hai ở giữa. Ví dụ tiêu biểu là trường hợp truy vấn lọc theo mã khách hàng kết hợp khoảng thời gian tạo đơn, nhưng không chỉ định trạng thái đơn hàng trên chỉ mục ba cột (customer_id, status, created_at).
Khi đối mặt với tình huống nhảy cóc này, cơ sở dữ liệu vẫn tận dụng được cột đầu tiên để thu hẹp không gian tìm kiếm về tập hợp tất cả các bản ghi thuộc về khách hàng đó. Tuy nhiên, ranh giới định vị trên cây B-tree bị chặn lại ngay tại vị trí cột trạng thái bị khuyết thiếu, khiến cột thời gian không thể tham gia vào việc thu hẹp vùng quét ban đầu.
Thay vì định vị chính xác đoạn lá cần đọc, hệ thống cơ sở dữ liệu sẽ phải duyệt qua toàn bộ các mục chỉ mục của vị khách hàng đó và áp dụng điều kiện thời gian như một bộ lọc kiểm tra nội bộ. Nếu khách hàng có số lượng đơn hàng nhỏ thì thời gian xử lý vẫn tương đối nhanh, nhưng đối với các tài khoản có hàng trăm nghìn giao dịch thì đây sẽ là một ổ nghẽn hiệu năng nghiêm trọng.
So sánh composite index và single index về chi phí I/O
Khi tiến hành so sánh composite index và single index trên các bảng dữ liệu quy mô lớn, nhiều nhà phát triển thường chọn giải pháp tạo nhiều chỉ mục đơn lẻ trên từng cột riêng biệt với hy vọng cơ sở dữ liệu sẽ tự động kết hợp chúng. Tuy nhiên, cơ chế kết hợp chỉ mục thông qua phép hợp hoặc phép giao Bitmap mang lại hiệu năng kém hơn hẳn so với chỉ mục kết hợp chuẩn.
Việc quét đồng thời hai chỉ mục đơn lẻ buộc hệ thống phải cấp phát bộ nhớ để lưu trữ hai bản đồ bit riêng biệt trong RAM, sau đó thực hiện phép toán logic AND giữa hai danh sách địa chỉ khối. Quá trình này không chỉ làm tăng tải trọng tính toán của bộ vi xử lý mà còn tạo ra lượng lớn các thao tác đọc đĩa rời rạc trên nhiều tập tin chỉ mục khác nhau.
Ngược lại, một composite index duy nhất cho phép bộ lọc tiếp cận trực tiếp các bản ghi mục tiêu chỉ qua một lần duyệt cây duy nhất, loại bỏ hoàn toàn chi phí tổng hợp trung gian. Sự khác biệt này giúp hệ thống tiết kiệm đáng kể tài nguyên bộ nhớ đệm và duy trì thời gian phản hồi ổn định dưới áp lực tải cao.
Phân tích kỹ thuật thực thi trên PostgreSQL với EXPLAIN ANALYZE
Để hiểu rõ cách thức cơ sở dữ liệu vận hành trên thực tế, công cụ chẩn đoán EXPLAIN kết hợp tùy chọn ANALYZE và BUFFERS trên PostgreSQL là phương tiện đo lường chuẩn xác nhất. Lệnh này không chỉ hiển thị kế hoạch dự kiến của trình biên dịch mà còn thực thi truy vấn để thu thập số liệu thực tế về thời gian và các trang đĩa được truy xuất.
Dưới đây là đoạn mã khởi tạo bảng dữ liệu mẫu mô phỏng hệ thống quản trị đơn hàng, sử dụng hàm sinh dữ liệu ngẫu nhiên có kiểm soát hạt giống trên PostgreSQL để tái hiện môi trường kiểm thử nhất quán:
DROP TABLE IF EXISTS orders;
CREATE TABLE orders (
  id          bigserial PRIMARY KEY,
  customer_id int         NOT NULL,
  status      text        NOT NULL,
  created_at  timestamptz NOT NULL,
  total       int         NOT NULL
);

SELECT setseed(0.42);
-- Khởi tạo 200.000 đơn hàng mẫu phân bổ cho 5.000 khách hàng
INSERT INTO orders (customer_id, status, created_at, total)
SELECT (random() * 4999)::int + 1,
       (ARRAY['pending','paid','shipped','cancelled'])[1 + (random() * 3)::int],
       now() - (random() * interval '300 days'),
       (50 + random() * 950)::int * 1000
FROM generate_series(1, 200000);

ANALYZE orders;
Kế hoạch parallel seq scan và chi phí duyệt toàn bảng
Khi bảng dữ liệu chưa được thiết lập bất kỳ chỉ mục bổ trợ nào ngoài khóa chính, việc thực thi truy vấn tìm kiếm các đơn hàng đã thanh toán của một khách hàng cụ thể sẽ buộc PostgreSQL phải huy động cơ chế quét tuần tự song song. Kế hoạch thực thi ghi nhận toàn bộ quá trình duyệt qua từng khối dữ liệu trên đĩa vật lý:
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, SUMMARY OFF)
SELECT * FROM orders WHERE customer_id = 42 AND status = 'paid';

-- Kết quả trả về từ PostgreSQL engine:
Gather (actual time=2.039..7.160 rows=13 loops=1)
  Workers Planned: 1
  Workers Launched: 1
  Buffers: shared hit=1667
  ->  Parallel Seq Scan on orders (actual time=1.802..4.130 rows=6 loops=2)
        Filter: ((customer_id = 42) AND (status = 'paid'::text))
        Rows Removed by Filter: 99994
        Buffers: shared hit=1667
Thông số kỹ thuật trên phơi bày rõ sự lãng phí tài nguyên của câu lệnh: để tìm ra vỏn vẹn 13 bản ghi thỏa mãn, hệ thống phải huy động 2 luồng công nhân song song, duyệt qua toàn bộ 1.667 trang bộ nhớ đệm và loại bỏ tới 99.994 dòng dữ liệu không liên quan trên mỗi luồng xử lý.
Cơ chế bitmap index scan kết hợp bitmap heap scan
Ngay sau khi chúng ta thiết lập một composite index bao gồm ba cột liên kết thông qua lệnh DDL chuẩn, hành vi thực thi của PostgreSQL thay đổi hoàn toàn sang mô hình quét bản đồ bit tối ưu:
CREATE INDEX idx_orders_customer_status_created
    ON orders (customer_id, status, created_at);

EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, SUMMARY OFF)
SELECT * FROM orders WHERE customer_id = 42 AND status = 'paid';

-- Kế hoạch thực thi sau khi tạo composite index:
Bitmap Heap Scan on orders (actual time=0.027..0.042 rows=13 loops=1)
  Recheck Cond: ((customer_id = 42) AND (status = 'paid'::text))
  Heap Blocks: exact=13
  Buffers: shared hit=13 read=3
  ->  Bitmap Index Scan on idx_orders_customer_status_created (actual time=0.022..0.023 rows=13 loops=1)
        Index Cond: ((customer_id = 42) AND (status = 'paid'::text))
        Buffers: shared read=3
Quá trình xử lý giờ đây chia làm hai giai đoạn mạch lạc: nút Bitmap Index Scan duyệt qua cây chỉ mục, đọc đúng 3 trang chỉ mục để xác định chính xác các con trỏ dòng phù hợp, sau đó chuyển giao bản đồ địa chỉ cho nút Bitmap Heap Scan để nạp trực tiếp 13 trang chứa dữ liệu thực tế mà không cần duyệt thêm bất kỳ dòng dư thừa nào.
Phân biệt điều kiện index cond và filter trong heap blocks
Một kỹ năng then chốt khi chẩn đoán hiệu năng là phân biệt sự khác nhau giữa hai dòng thông báo Index Cond và Filter xuất hiện trong đầu ra của EXPLAIN. Dòng Index Cond thể hiện các điều kiện được động cơ sử dụng trực tiếp để định hướng hành trình duyệt cây B-tree và giới hạn phạm vi quét các trang lá.
Ngược lại, nếu một điều kiện nằm ở dòng Filter, điều đó đồng nghĩa với việc cơ sở dữ liệu không thể sử dụng nó để thu hẹp vùng quét ban đầu. Thay vào đó, sau khi nạp bản ghi từ đĩa hoặc từ bộ nhớ heap, hệ thống mới tiến hành kiểm tra điều kiện lọc này, dẫn đến nguy cơ gia tăng lãng phí chu kỳ CPU nếu số lượng bản ghi cần lọc lại quá lớn.
Đọc hiểu EXPLAIN FORMAT TRADITIONAL trên MySQL và chỉ số key_len
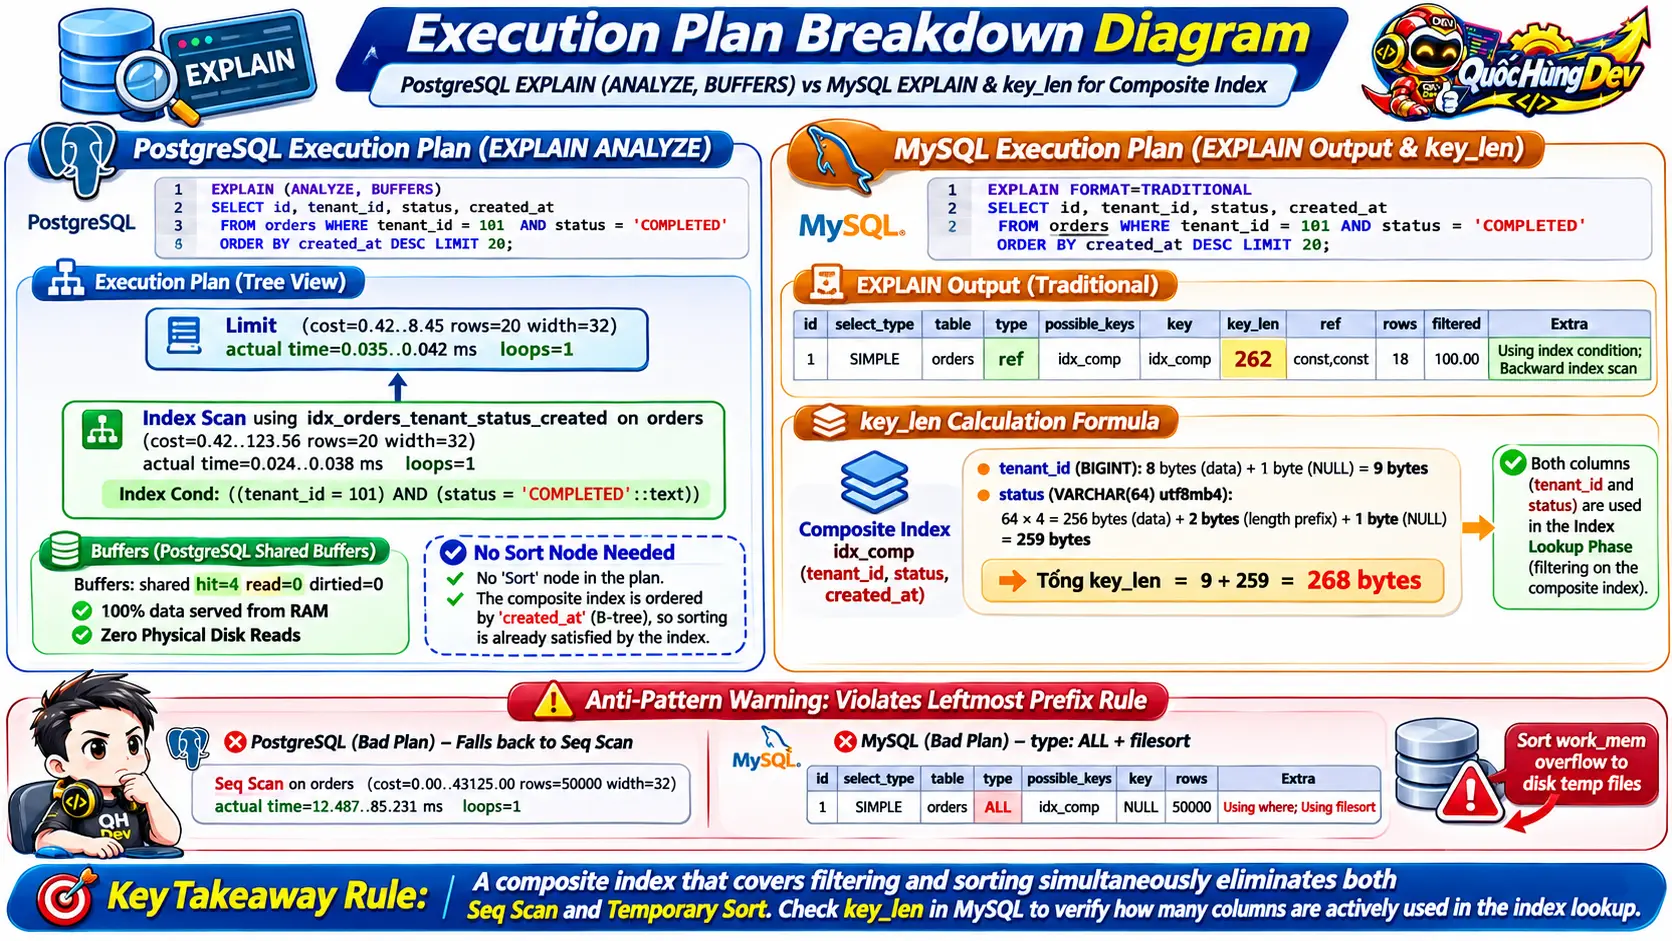
Để kiểm chứng hiệu quả của composite index là gì, trong khi PostgreSQL thể hiện các điều kiện chỉ mục thông qua dòng Index Cond chi tiết, hệ quản trị MySQL lại cung cấp một công cụ chẩn đoán cực kỳ trực quan và mạnh mẽ thông qua chỉ số độ dài khóa key_len trong câu lệnh EXPLAIN truyền thống. Chỉ số này phản ánh chính xác số byte dữ liệu mà MySQL thực sự khai thác từ cấu trúc chỉ mục.
Bằng cách đối chiếu giá trị key_len với kích thước vật lý của các cột được định nghĩa trong schema bảng, kỹ sư hệ thống có thể xác định ngay lập tức có bao nhiêu cột trong composite index đã phát huy tác dụng định tuyến, và tại cột nào thì quá trình thu hẹp vùng quét bị ngắt quãng.
Công thức giải mã dung lượng byte key_len theo từng kiểu dữ liệu
Để tính toán chính xác giá trị key_len trên MySQL InnoDB sử dụng bảng mã ký tự utf8mb4 hiện đại, chúng ta áp dụng các quy tắc định lượng kích thước vật lý chuẩn xác cho từng loại trường dữ liệu cụ thể trong bảng giao dịch orders:
Cột customer_id có kiểu số nguyên INT chuẩn với ràng buộc NOT NULL, do đó luôn chiếm dụng cố định đúng 4 byte bộ nhớ khóa. Cột created_at có kiểu thời gian DATETIME với ràng buộc NOT NULL, chiếm dụng cố định đúng 5 byte trong cấu trúc chỉ mục B-tree.
Đối với cột chuỗi ký tự status có kiểu VARCHAR(20) khai báo bảng mã utf8mb4, mỗi ký tự tối đa có thể tiêu tốn 4 byte lưu trữ. Kèm theo đó, MySQL cần thêm đúng 2 byte ở phần đầu để lưu trữ độ dài thực tế của chuỗi, dẫn đến công thức tính dung lượng là 20 nhân 4 cộng 2, cho ra tổng cộng 82 byte khóa.
-- Đo lường chỉ số key_len trên các kịch bản lọc khác nhau tại MySQL:
-- 1) Lọc theo customer_id và status:
-- key_len = 4 (INT) + 82 (VARCHAR) = 86 bytes (Dùng trọn vẹn 2 cột đầu)
EXPLAIN FORMAT=TRADITIONAL SELECT * FROM orders WHERE customer_id = 42 AND status = 'paid';

-- 2) Chỉ lọc theo customer_id:
-- key_len = 4 bytes (Chỉ dùng cột đầu tiên)
EXPLAIN FORMAT=TRADITIONAL SELECT * FROM orders WHERE customer_id = 42;

-- 3) Lọc đầy đủ cả 3 cột customer_id, status và created_at:
-- key_len = 4 + 82 + 5 = 91 bytes (Cả 3 cột đều tham gia định vị)
EXPLAIN FORMAT=TRADITIONAL SELECT * FROM orders WHERE customer_id = 42 AND status = 'paid' AND created_at >= '2026-06-01';
Kỹ thuật index condition pushdown giảm tải bus bộ nhớ
Trong trường hợp truy vấn lọc theo cột đầu tiên và cột thứ ba nhưng bỏ qua cột thứ hai, MySQL hiển thị chỉ số key_len là 4 byte, đồng thời xuất hiện dòng thông báo Using index condition tại cột Extra. Đây là biểu hiện của cơ chế tối ưu hóa Index Condition Pushdown.
Khi chưa tối ưu composite index là gì, trước khi có cơ chế này, động cơ lưu trữ InnoDB sau khi định vị các bản ghi của khách hàng số 42 sẽ phải chuyển toàn bộ các bản ghi đó lên tầng máy chủ SQL để lọc tiếp điều kiện thời gian. Điều này gây lãng phí băng thông truyền tải dữ liệu trên bus bộ nhớ giữa tầng lưu trữ và tầng máy chủ.
Với Index Condition Pushdown, máy chủ SQL sẽ đẩy trực tiếp biểu thức điều kiện thời gian xuống cho động cơ InnoDB tự kiểm tra ngay trong quá trình duyệt các trang lá chỉ mục. Chỉ những bản ghi nào thực sự thỏa mãn cả hai điều kiện mới được nạp từ bảng dữ liệu chính, giúp tiết kiệm đáng kể thời gian xử lý.
Trường hợp ngoại lệ skip scan tận dụng chỉ mục khi thiếu tiền tố
Quy tắc tiền tố bên trái khẳng định rằng việc thiếu cột đầu tiên sẽ khiến composite index bị vô hiệu hóa. Tuy nhiên, trong các phiên bản MySQL hiện đại, hệ thống đã trang bị tính năng Index Skip Scan, cho phép tận dụng chỉ mục ngay cả khi câu lệnh truy vấn hoàn toàn vắng mặt cột đứng đầu.
Khi chạy câu lệnh đếm số đơn hàng theo trạng thái mà không lọc theo mã khách hàng, MySQL có thể kích hoạt cơ chế Skip Scan nếu số lượng giá trị duy nhất ở cột đầu tiên là tương đối nhỏ. Trình tối ưu hóa sẽ tự động thực hiện phép nhảy cóc qua từng mã khách hàng một cách thông minh, rồi quét đoạn trạng thái tương ứng bên trong từng khách hàng đó.
Cần lưu ý rằng tính năng Skip Scan chỉ hoạt động khi câu truy vấn chỉ trích xuất các cột nằm sẵn bên trong chỉ mục, chỉ truy vấn trên một bảng duy nhất và không chứa các mệnh đề gom nhóm phức tạp. Do đó, đây chỉ là giải pháp cứu cánh bổ trợ chứ không thể thay thế cho việc thiết kế thứ tự chỉ mục chuẩn xác.
Hướng dẫn tối ưu composite index: quy tắc lọc bằng đứng trước khoảng đứng sau
Khi một câu truy vấn nghiệp vụ thường xuyên yêu cầu lọc đồng thời theo nhiều trường, một trong những quyết định thiết kế quan trọng nhất đối với composite index là gì trong hướng dẫn tối ưu composite index là xác định trật tự sắp xếp giữa các cột. Quy tắc vàng bất biến được áp dụng trong mọi hệ quản trị cơ sở dữ liệu là: luôn luôn đặt các cột so sánh bằng lên trước và đẩy các cột lọc theo khoảng về phía sau cùng.
Hãy xem xét câu truy vấn tìm kiếm các đơn hàng có trạng thái đã thanh toán được tạo trong khoảng thời gian xác định. Chúng ta có hai lựa chọn thiết kế chỉ mục đối nghịch nhau: Index A đặt cột thời gian lên trước theo thứ tự (created_at, status), trong khi Index B đặt cột trạng thái lên trước theo thứ tự (status, created_at).
Bản chất toán tử so sánh bằng và điểm dừng quét range scan
Để hiểu tại sao Index B lại vượt trội hoàn toàn so với Index A, chúng ta cần nhìn vào cách thức cây B-tree phản ứng trước các toán tử lọc theo khoảng như lớn hơn, nhỏ hơn hoặc toán tử BETWEEN. Khi một cột lọc theo khoảng xuất hiện ở vị trí đầu tiên, cây chỉ mục chỉ có thể dùng nó để xác định điểm bắt đầu và điểm kết thúc của một dải quét liên tục.
Bên trong dải quét thời gian rộng lớn đó, các đơn hàng thuộc đủ mọi trạng thái khác nhau như đang chờ xử lý, đã hủy hay đã giao hàng đều nằm xen kẽ lẫn nhau. Cơ sở dữ liệu buộc phải duyệt qua từng mục chỉ mục trong toàn bộ khoảng thời gian đó và tiến hành kiểm tra lại giá trị trạng thái, biến cột thứ hai thành một bộ lọc kiểm tra thụ động.
Ngược lại, khi đặt cột so sánh bằng lên đầu tiên như trong Index B, toàn bộ các đơn hàng có trạng thái đã thanh toán sẽ được gom cụm lại thành một phân vùng duy nhất trên cây chỉ mục. Bên trong phân vùng đó, các bản ghi lại được sắp xếp tuần tự theo thời gian, cho phép cơ sở dữ liệu nhảy thẳng tới mốc thời gian bắt đầu và quét một mạch đến khi đạt điểm dừng.
Thực nghiệm đo đạc độ trễ giữa hai trật tự sắp xếp cột
Thực nghiệm đo đạc kế hoạch thực thi trên PostgreSQL chứng minh sự khác biệt rõ rệt về số lượng trang chỉ mục cần phải duyệt qua giữa hai phương án cấu hình chỉ mục đối nghịch này:
-- Thực nghiệm đo đạc trên PostgreSQL với 2 trật tự chỉ mục:
-- Kịch bản Index A: Đặt cột khoảng lên trước (created_at, status)
CREATE INDEX idx_orders_created_status ON orders (created_at, status);
-- Kế hoạch đọc: Buffers: shared read=76 trang chỉ mục, thời gian 2.352 ms

-- Kịch bản Index B: Đặt cột bằng lên trước (status, created_at)
DROP INDEX idx_orders_created_status;
CREATE INDEX idx_orders_status_created ON orders (status, created_at);
-- Kế hoạch đọc: Buffers: shared read=27 trang chỉ mục, thời gian 1.698 ms
Kết quả từ kế hoạch thực thi cho thấy Index B giúp giảm số lượng trang chỉ mục cần đọc từ 76 trang xuống chỉ còn 27 trang, tức là giảm gần 3 lần dung lượng I/O chỉ mục cần xử lý. Dữ liệu thực nghiệm này là minh chứng không thể chối cãi cho việc ưu tiên cột so sánh bằng đứng ở vị trí tiền tố.
Tối ưu mệnh đề ORDER BY và loại bỏ bước sắp xếp in-memory sort
Bên cạnh việc tăng tốc cho mệnh đề WHERE khi ứng dụng composite index là gì, một composite index được sắp xếp chuẩn xác còn mang lại một giá trị kỹ thuật to lớn khác: loại bỏ hoàn toàn các tác vụ sắp xếp tốn kém trong bộ nhớ RAM cho mệnh đề ORDER BY. Đây là bí quyết giúp các API phân trang và các truy vấn lấy danh sách mới nhất duy trì độ trễ cực thấp.
Trong các ứng dụng thực tế, người dùng thường có nhu cầu xem danh sách 5 hoặc 10 giao dịch gần nhất của tài khoản. Khi truy vấn kết hợp điều kiện lọc danh tính với lệnh sắp xếp giảm dần theo thời gian, trật tự các cột trong chỉ mục sẽ quyết định cơ sở dữ liệu có cần thực hiện thao tác Sort hay không.
Cơ chế quét ngược index scan backward không tốn RAM
Khi ứng dụng hiểu rõ composite index là gì và thiết lập ba cột (customer_id, status, created_at), câu lệnh truy vấn lọc theo hai cột đầu và sắp xếp giảm dần theo cột thứ ba sẽ kích hoạt cơ chế Index Scan Backward vô cùng mạnh mẽ:
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, SUMMARY OFF)
SELECT * FROM orders WHERE customer_id = 42 AND status = 'paid'
ORDER BY created_at DESC LIMIT 5;

-- Đầu ra tối ưu không hề có bước Sort:
Limit (actual time=0.009..0.011 rows=5 loops=1)
  Buffers: shared hit=8
  ->  Index Scan Backward using idx_orders_customer_status_created on orders (actual time=0.005..0.006 rows=5 loops=1)
        Index Cond: ((customer_id = 42) AND (status = 'paid'::text))
        Buffers: shared hit=8
Nhờ danh sách liên kết đôi tại tầng trang lá của cây B-tree, cơ sở dữ liệu chỉ việc nhảy tới nút lá cuối cùng của nhóm khách hàng 42 có trạng thái đã thanh toán, sau đó lần ngược lại theo con trỏ lùi để lấy đúng 5 bản ghi đầu tiên và ngắt tiến trình ngay lập tức. Toàn bộ tác vụ chỉ tiêu tốn đúng 8 trang bộ đệm và không sử dụng bất kỳ byte bộ nhớ sắp xếp nào.
Cảnh báo suy biến sang top-N heapsort và tràn bộ nhớ đệm
Tuy nhiên, nếu câu truy vấn bỏ qua cột trạng thái ở giữa và chỉ yêu cầu lọc theo mã khách hàng rồi sắp xếp theo thời gian, chuỗi trật tự sắp xếp liền mạch trên cây B-tree sẽ lập tức bị phá vỡ. Kế hoạch thực thi sẽ bị suy biến sang giải thuật sắp xếp bộ nhớ đầy rủi ro:
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, SUMMARY OFF)
SELECT * FROM orders WHERE customer_id = 42
ORDER BY created_at DESC LIMIT 5;

-- Đầu ra bị suy biến sang bước sắp xếp bộ nhớ:
Limit (actual time=0.033..0.034 rows=5 loops=1)
  Buffers: shared hit=38
  ->  Sort (actual time=0.032..0.033 rows=5 loops=1)
        Sort Key: created_at DESC
        Sort Method: top-N heapsort  Memory: 25kB
        Buffers: shared hit=38
        ->  Bitmap Heap Scan on orders (actual time=0.008..0.027 rows=34 loops=1)
              Recheck Cond: (customer_id = 42)
              Buffers: shared hit=38
              ->  Bitmap Index Scan on idx_orders_customer_status_created
Nguyên nhân của hiện tượng này là do bên trong một mã khách hàng, các giá trị thời gian chỉ được sắp xếp tăng dần theo từng nhóm trạng thái riêng biệt, chứ không tạo thành một chuỗi liên tục cho toàn bộ khách hàng đó. Cơ sở dữ liệu buộc phải thu thập toàn bộ các bản ghi của khách hàng, nạp vào vùng nhớ work_mem và kích hoạt giải thuật top-N heapsort.
Nếu tập dữ liệu cần sắp xếp vượt quá hạn mức dung lượng cấu hình của work_mem trên PostgreSQL hoặc sort_buffer_size trên MySQL, hệ thống sẽ buộc phải ghi dữ liệu tạm thời xuống ổ đĩa thông qua giải thuật External Merge Disk Sort. Hiện tượng tràn đĩa này sẽ khiến thời gian phản hồi của truy vấn tăng vọt từ vài miligiây lên hàng giây.
Chi phí lưu trữ composite index và đánh đổi tài nguyên hệ thống
Mặc dù lợi thế của composite index là gì mang lại tốc độ đọc vượt bậc, kỹ sư hệ thống không thể bỏ qua bài toán chi phí lưu trữ composite index và những đánh đổi tài nguyên tiềm ẩn khi vận hành ở quy mô lớn. Không có giải pháp nào là hoàn hảo tuyệt đối: tốc độ đọc vượt trội luôn được đánh đổi bằng dung lượng lưu trữ và phụ tải ghi dữ liệu.
Mỗi chỉ mục kết hợp được khởi tạo sẽ chiếm dụng thêm không gian lưu trữ đáng kể trên đĩa cứng. Độ dài khóa càng lớn và số lượng cột tham gia càng nhiều thì kích thước của từng nút trang lá càng tăng, làm giảm số lượng khóa có thể đóng gói trên một trang 8KB hoặc 16KB và đẩy chiều cao của cây B-tree lên cao hơn.
Chi phí bộ nhớ đệm buffer pool và khuếch đại ghi write amplification
Khi phân tích chi phí của composite index là gì, hệ lụy trực tiếp đầu tiên của việc gia tăng kích thước chỉ mục là sự cạnh tranh gay gắt trên vùng đệm bộ nhớ buffer pool. Để duy trì hiệu năng cao, các trang chỉ mục thường xuyên truy cập phải được giữ thường trực trong RAM. Khi dung lượng chỉ mục phình to vượt quá bộ nhớ vật lý, hệ thống sẽ rơi vào tình trạng trang tráo liên tục giữa RAM và đĩa cứng.
Đồng thời, mọi thao tác ghi dữ liệu bao gồm INSERT, UPDATE và DELETE đều phải gánh chịu hiện tượng khuếch đại ghi. Khi chèn một bản ghi mới, cơ sở dữ liệu không chỉ ghi vào bảng chính mà còn phải tìm vị trí thích hợp trên mọi cây chỉ mục liên quan để chèn khóa mới, tiềm ẩn nguy cơ gây ra các thao tác tách trang chỉ mục tốn kém.
Hiện tượng phân mảnh bảng và ảnh hưởng tới tiến trình VACUUM
Đặc biệt trên hệ quản trị PostgreSQL với mô hình kiểm soát đồng thời đa phiên bản MVCC, việc cập nhật một cột nằm trong composite index sẽ phá vỡ hoàn toàn cơ chế tối ưu hóa Heap-Only Tuples. Hệ thống buộc phải tạo ra một mục chỉ mục mới trỏ đến phiên bản dòng mới, làm gia tăng nhanh chóng số lượng bản ghi chết trong cấu trúc chỉ mục.
Sự tích tụ của các mục chỉ mục chết này gây ra hiện tượng phình to chỉ mục và làm gia tăng gánh nặng đáng kể cho tiến trình dọn dẹp tự động autovacuum. Do đó, việc lạm dụng quá nhiều chỉ mục kết hợp trên các bảng có tần suất cập nhật dữ liệu liên tục sẽ trực tiếp làm suy giảm hiệu năng tổng thể của toàn bộ cụm máy chủ.
Ma trận ra quyết định thiết kế chỉ mục theo mô hình nghiệp vụ
Để giúp các đội ngũ kỹ thuật đưa ra quyết định thiết kế chỉ mục chính xác mà không rơi vào tình trạng phỏng đoán cảm tính, chúng tôi tổng hợp ma trận phân loại chiến lược thiết kế chỉ mục tương ứng với ba mô hình kiến trúc nghiệp vụ phổ biến nhất hiện nay.
Thương mại điện tử & giao dịch
Đặc trưng bởi tần suất đọc cao và các truy vấn lọc trạng thái kết hợp định danh khách hàng. Chiến lược tối ưu là áp dụng chỉ mục ba cột (customer_id, status, created_at) để phục vụ đồng thời cả điều kiện lọc và sắp xếp lịch sử đơn hàng mà không gây nghẽn bộ nhớ.
Hệ thống IoT & chuỗi thời gian
Đặc trưng bởi tải trọng ghi dữ liệu cực lớn và chỉ ghi chèn không cập nhật. Thứ tự cột tối ưu bắt buộc phải đặt mã định danh thiết bị lên đầu tiên kết hợp với cột dấu thời gian (device_id, recorded_at), hạn chế tối đa các cột chuỗi phụ để bảo vệ thông lượng ghi.
Nền tảng SaaS đa người dùng
Mô hình đa khách hàng yêu cầu cô lập dữ liệu tuyệt đối theo từng tổ chức. Khóa định danh tenant_id bắt buộc phải là cột tiền tố đứng đầu trong 100% các composite index (tenant_id, entity_type, created_at), đảm bảo không gian tìm kiếm luôn được phân vùng triệt để.
Việc định vị đúng mô hình tải trọng của ứng dụng là tiền đề để lựa chọn cấu trúc chỉ mục phù hợp. Trong quá trình xây dựng hạ tầng, kỹ sư có thể tham khảo thêm các giải pháp khắc phục lỗi thiết kế database thường gặp nhằm bảo vệ toàn vẹn cấu trúc dữ liệu ngay từ giai đoạn khởi tạo.
Checklist an toàn và lưu ý vận hành hệ thống production
Việc triển khai hoặc chỉnh sửa cấu trúc chỉ mục trên môi trường sản xuất đang chịu tải đòi hỏi sự cẩn trọng tối đa để tránh gây gián đoạn dịch vụ. Các lệnh DDL tạo chỉ mục thông thường có thể chiếm giữ khóa độc quyền trên bảng dữ liệu, khiến mọi thao tác đọc ghi của người dùng bị đóng băng.
Cảnh báo an toàn hệ thống: Tuyệt đối không thực thi các câu lệnh CREATE INDEX trực tiếp trên bảng dữ liệu có dung lượng lớn tại môi trường sản xuất trong giờ cao điểm. Việc khóa bảng kéo dài sẽ tích lũy hàng nghìn kết nối chờ, dẫn đến hiện tượng cạn kiệt connection pool và làm sụp đổ toàn bộ hệ thống API.
Kỹ thuật tạo chỉ mục trực tuyến CONCURRENTLY không khóa bảng
Để ngăn chặn triệt để nguy cơ khóa bảng, hệ quản trị PostgreSQL cung cấp từ khóa CONCURRENTLY, cho phép xây dựng cây B-tree ngầm trong nền mà không ngăn cản các thao tác chèn, cập nhật hay xóa dữ liệu đang diễn ra trên hệ thống:
-- Tạo composite index trực tuyến trên PostgreSQL không khóa ghi:
CREATE INDEX CONCURRENTLY idx_orders_customer_status_created
ON orders (customer_id, status, created_at);

-- Tạo chỉ mục trực tuyến tương đương trên MySQL InnoDB:
ALTER TABLE orders ADD INDEX idx_orders_customer_status_created (customer_id, status, created_at),
ALGORITHM=INPLACE, LOCK=NONE;
Đối với hệ quản trị PostgreSQL, quá trình tạo chỉ mục trực tuyến đòi hỏi thực hiện hai lượt quét bảng và phải chờ tất cả các giao dịch đang mở hoàn tất. Do đó, việc nắm vững quy trình cấu hình server PostgreSQL chuẩn mực về bộ nhớ bảo trì maintenance_work_mem sẽ giúp rút ngắn đáng kể thời gian tạo chỉ mục ngầm. Ngoài ra, bạn đọc có thể tham khảo tài liệu kỹ thuật chính thức từ PostgreSQL Documentation về Multicolumn Indexes và MySQL Multiple-Column Index Documentation để tìm hiểu các cờ tối ưu hóa chuyên sâu.
Rà soát chỉ mục trùng lặp tiền tố và dọn dẹp tài nguyên
Một sai lầm rất phổ biến là việc để sót các chỉ mục đơn lẻ trùng lặp sau khi đã thiết lập composite index. Nếu bảng dữ liệu của bạn đã sở hữu chỉ mục kết hợp trên bộ ba cột (A, B, C), thì bản thân nó đã hỗ trợ hoàn hảo cho các truy vấn lọc theo cột (A) và cặp cột (A, B).
Việc tiếp tục duy trì thêm một chỉ mục đứng riêng trên cột (A) là hoàn toàn dư thừa, gây lãng phí bộ nhớ đệm và làm tăng gấp đôi chi phí ghi dữ liệu khi cập nhật bản ghi. Định kỳ rà soát các chỉ mục trùng lặp tiền tố và tiến hành loại bỏ chúng là một trong những bước bảo trì quan trọng khi vận hành cụm MySQL Percona XtraDB Cluster hoặc cơ sở dữ liệu phân tán.
Đồng thời, khi tối ưu hóa các giao dịch lớn, bạn cần đối chiếu kỹ lưỡng với các tính chất ACID trong transaction để đảm bảo rằng việc tinh chỉnh chỉ mục không làm suy giảm tính nhất quán và độ bền vững của dữ liệu hệ thống.
Câu hỏi thường gặp về composite index trong database
Composite index có thay thế hoàn toàn cho các chỉ mục đơn cột không?
Chỉ mục kết hợp trên bộ cột (A, B, C) có thể thay thế hoàn toàn cho chỉ mục đơn trên cột A hoặc cặp chỉ mục trên (A, B) nhờ nguyên tắc tiền tố bên trái. Tuy nhiên, nó hoàn toàn không thể thay thế cho các chỉ mục đơn trên cột B hoặc cột C khi các câu truy vấn đứng độc lập không có điều kiện ràng buộc ở cột A đi kèm.
Khi nào nên sử dụng Covering index thay vì chỉ đánh Composite index thông thường?
Chỉ mục bao phủ Covering index nên được áp dụng khi câu truy vấn có tần suất thực thi cực cao và danh sách các cột cần lấy trong mệnh đề SELECT là cố định. Bằng cách bổ sung thêm các cột cần lấy vào mệnh đề INCLUDE trên PostgreSQL hoặc phần đuôi chỉ mục trên MySQL, hệ thống có thể thực hiện Index-Only Scan mà không cần đọc xuống bảng dữ liệu heap.
Độ chọn lọc Cardinality có quyết định thứ tự cột trong composite index không?
Trong nhóm các cột so sánh bằng, độ chọn lọc Cardinality không làm thay đổi số lượng trang chỉ mục cần đọc vì toàn bộ bộ khóa bằng nhau đều được định vị chính xác. Tuy nhiên, nếu truy vấn chứa cả cột so sánh bằng và cột lọc theo khoảng, toán tử so sánh bằng luôn luôn được ưu tiên đặt lên đầu tiên bất kể cột đó có độ chọn lọc cao hay thấp.
Tại sao câu lệnh EXPLAIN trên môi trường kiểm thử dùng Seq Scan dù đã đánh đúng chỉ mục?
Bộ tối ưu hóa truy vấn tính toán chi phí dựa trên mô hình định lượng I/O thực tế. Nếu bảng dữ liệu kiểm thử có kích thước quá nhỏ, chỉ chiếm một vài trang bộ nhớ, chi phí đọc tuần tự toàn bộ trang vào bộ nhớ đệm sẽ rẻ hơn nhiều so với việc phải đọc qua các tầng nút B-tree rồi mới trỏ xuống bảng, do đó planner sẽ chủ động chọn quét tuần tự.
Kết luận và định hướng tối ưu hóa cơ sở dữ liệu bền vững
Hiểu rõ bản chất composite index là gì cùng nguyên lý hoạt động của cây B-tree đa cột là nền tảng cốt lõi để xây dựng các hệ thống cơ sở dữ liệu có khả năng mở rộng cao. Bằng cách tuân thủ nguyên tắc tiền tố bên trái và ưu tiên đặt các cột so sánh bằng đứng trước các cột lọc theo khoảng, bạn có thể biến các truy vấn phức tạp trở nên nhẹ nhàng và tức thì.
Tối ưu hóa chỉ mục không phải là một công việc thực hiện một lần rồi bỏ mặc, mà là một quy trình kỹ thuật liên tục song hành cùng sự phát triển của sản phẩm. Việc định kỳ giám sát các truy vấn chậm thông qua nhật ký slow query log, phân tích kế hoạch thực thi EXPLAIN và loại bỏ các chỉ mục thừa sẽ bảo đảm cụm máy chủ cơ sở dữ liệu luôn vận hành ở trạng thái ổn định và hiệu quả nhất.