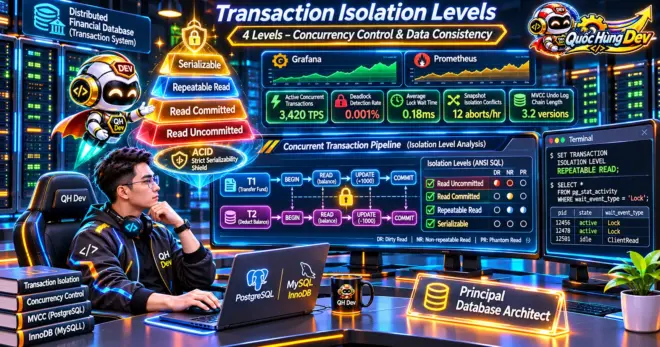
Mức cô lập transaction là cơ chế trọng yếu quyết định mức độ an toàn dữ liệu và khả năng xử lý tương tranh khi hàng nghìn phiên làm việc cùng truy cập vào cơ sở dữ liệu. Khi hệ thống mở rộng quy mô, sự bất đồng bộ giữa các luồng giao dịch song song có thể dẫn đến những sai lệch số liệu nghiêm trọng mà các bài kiểm thử đơn vị thông thường không thể phát hiện.
Nhiều đội ngũ kỹ thuật từng trải qua sự cố hai khách hàng cùng đặt mua thành công một sản phẩm tồn kho duy nhất, hoặc số dư tài khoản bị ghi đè dẫn đến thất thoát tài chính. Bản chất của các lỗi này không bắt nguồn từ thuật ngữ logic của ngôn ngữ lập trình, mà nằm ở sự hiểu lầm về mức cô lập transaction mặc định giữa hai hệ quản trị cơ sở dữ liệu phổ biến là PostgreSQL và MySQL.
Bài viết phân tích chuyên sâu kiến trúc nội bộ của 4 mức cô lập tiêu chuẩn, cơ chế kiểm soát đồng thời đa phiên bản MVCC, bản chất xung đột ghi đồng thời và giải pháp chống mất mát dữ liệu trên môi trường production. Nội dung đối chiếu chi tiết hành vi thực tế giữa PostgreSQL và MySQL InnoDB, giúp các kỹ sư phần mềm thiết kế giải pháp an toàn tuyệt đối cho hệ thống dữ liệu trọng yếu.
Định nghĩa bản chất công nghệ và nền tảng cốt lõi
Một transaction trong cơ sở dữ liệu là tập hợp của nhiều thao tác đọc và ghi được xử lý như một đơn vị công việc logic duy nhất. Mô hình kinh điển này được định nghĩa thông qua 4 tính chất ACID gồm Atomicity (tính nguyên tử), Consistency (tính nhất quán), Isolation (tính cô lập) và Durability (tính bền vững).
Trong mô hình ACID, tính chất cô lập chịu trách nhiệm xác định ranh giới hiển thị giữa các transaction chạy song song. Nếu không có mức cô lập transaction chuẩn mực, một phiên làm việc có thể nhìn thấy dữ liệu trung gian chưa hoàn tất của một phiên khác, làm phá vỡ toàn bộ tính nhất quán nghiệp vụ của toàn bộ hệ thống lưu trữ.
Trên thực tế, mỗi transaction bắt đầu bằng lệnh BEGIN, xác nhận lưu vĩnh viễn dữ liệu bằng COMMIT, hoặc hủy bỏ toàn bộ trạng thái dở dang thông qua lệnh ROLLBACK. Để tìm hiểu sâu hơn về 4 thuộc tính cơ bản của hệ thống lưu trữ, bạn có thể tham khảo bài viết transaction và ACID trong database của chúng tôi.
Sự đánh đổi cốt lõi trong kỹ thuật cơ sở dữ liệu luôn diễn ra giữa tính cô lập hoàn hảo và thông lượng xử lý hệ thống. Nếu buộc mọi transaction chạy tuần tự hoàn toàn để tránh mọi xung đột, hệ thống sẽ rơi vào tình trạng nghẽn cổ chai nghiêm trọng với độ trễ phản hồi tăng vọt khi lưu lượng truy cập gia tăng đột biến.
Bảng so sánh tổng quan và cơ chế cô lập ANSI SQL
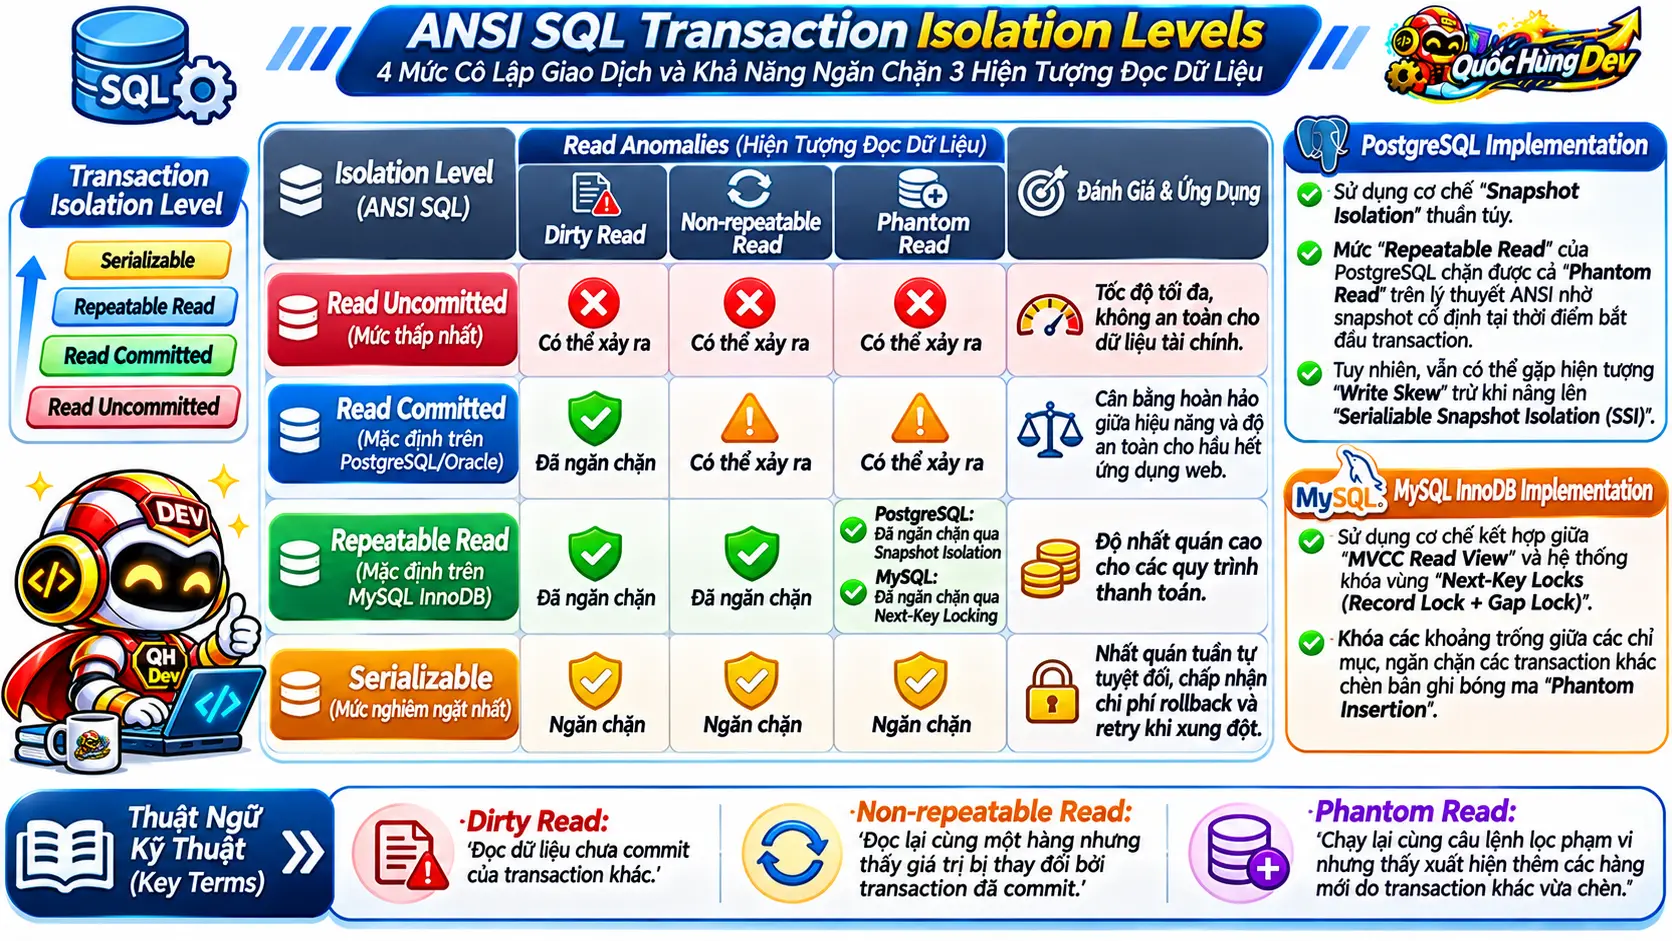
Tiêu chuẩn ANSI/ISO SQL-92 định nghĩa 4 mức cô lập transaction nhằm chuẩn hóa sự cân bằng giữa tính toàn vẹn dữ liệu và thông lượng xử lý song song. Mỗi cấp độ thiết lập một rào chắn kỹ thuật nhằm triệt tiêu các hiện tượng bất thường khi đọc dữ liệu trong môi trường nhiều kết nối đồng thời.
| Mức cô lập ANSI SQL | Hiện tượng Dirty Read | Hiện tượng Non-repeatable Read | Hiện tượng Phantom Read | Mặc định trên Engine |
|---|---|---|---|---|
| Read Uncommitted | Có thể xảy ra | Có thể xảy ra | Có thể xảy ra | Không có hệ thống nào để mặc định |
| Read Committed | Đã được ngăn chặn | Có thể xảy ra | Có thể xảy ra | Mặc định trên PostgreSQL, Oracle, SQL Server |
| Repeatable Read | Đã được ngăn chặn | Đã được ngăn chặn | Có thể xảy ra theo chuẩn ANSI | Mặc định trên MySQL InnoDB |
| Serializable | Đã được ngăn chặn | Đã được ngăn chặn | Đã được ngăn chặn | Yêu cầu cấu hình thủ công cho transaction |
Mỗi hệ quản trị cơ sở dữ liệu lại hiện thực hóa 4 cấp độ này theo những phương pháp kiến trúc hoàn toàn khác nhau. Điển hình là trên PostgreSQL, mức Read Uncommitted được đối xử đồng nhất như Read Committed vì cơ chế đa phiên bản không bao giờ cho phép một tiến trình đọc thấy bộ nhớ chưa được commit của tiến trình khác.
Điểm khác biệt cốt lõi giữa các chiến lược cô lập
Để hiện thực hóa mức cô lập transaction, ngành khoa học máy tính chia làm hai trường phái lớn: trường phái dựa trên khóa truyền thống và trường phái đa phiên bản (Multiversion Concurrency Control – MVCC). Trường phái khóa sử dụng các khóa chia sẻ và khóa độc quyền để điều phối quyền đọc ghi, dẫn đến việc người đọc phải chờ người ghi và người ghi phải chờ người đọc.
Ngược lại, mô hình kiểm soát đồng thời đa phiên bản MVCC áp dụng triết lý tiến bộ: người đọc không bao giờ chặn người ghi, và người ghi không bao giờ chặn người đọc. Khi một câu lệnh sửa đổi dữ liệu diễn ra, hệ thống không ghi đè trực tiếp lên ô nhớ vật lý ban đầu mà tạo ra một bản sao mới, đồng thời duy trì các phiên bản cũ để phục vụ các truy vấn đang diễn ra.
Cơ chế cô lập ảnh chụp (Snapshot Isolation) chính là nền tảng cốt lõi của MVCC hiện đại. Khi một truy vấn hoặc transaction được khởi tạo, hệ quản trị cơ sở dữ liệu sẽ cung cấp một bức ảnh chụp trạng thái nhất quán của toàn bộ dữ liệu tại đúng thời điểm đó, cô lập hoàn toàn phiên làm việc khỏi mọi biến động bên ngoài.
Tuy nhiên, sự tự do của mô hình MVCC cũng mở ra những thách thức mới về quản trị tài nguyên. Khi các phiên bản cũ tích tụ theo thời gian, dung lượng lưu trữ trên đĩa cứng và bộ nhớ đệm sẽ phình to nhanh chóng, đòi hỏi các thuật toán dọn rác nền vận hành liên tục để thu hồi không gian bộ nhớ.
Phân tích kỹ thuật chuyên sâu về các lỗi đọc dữ liệu transaction
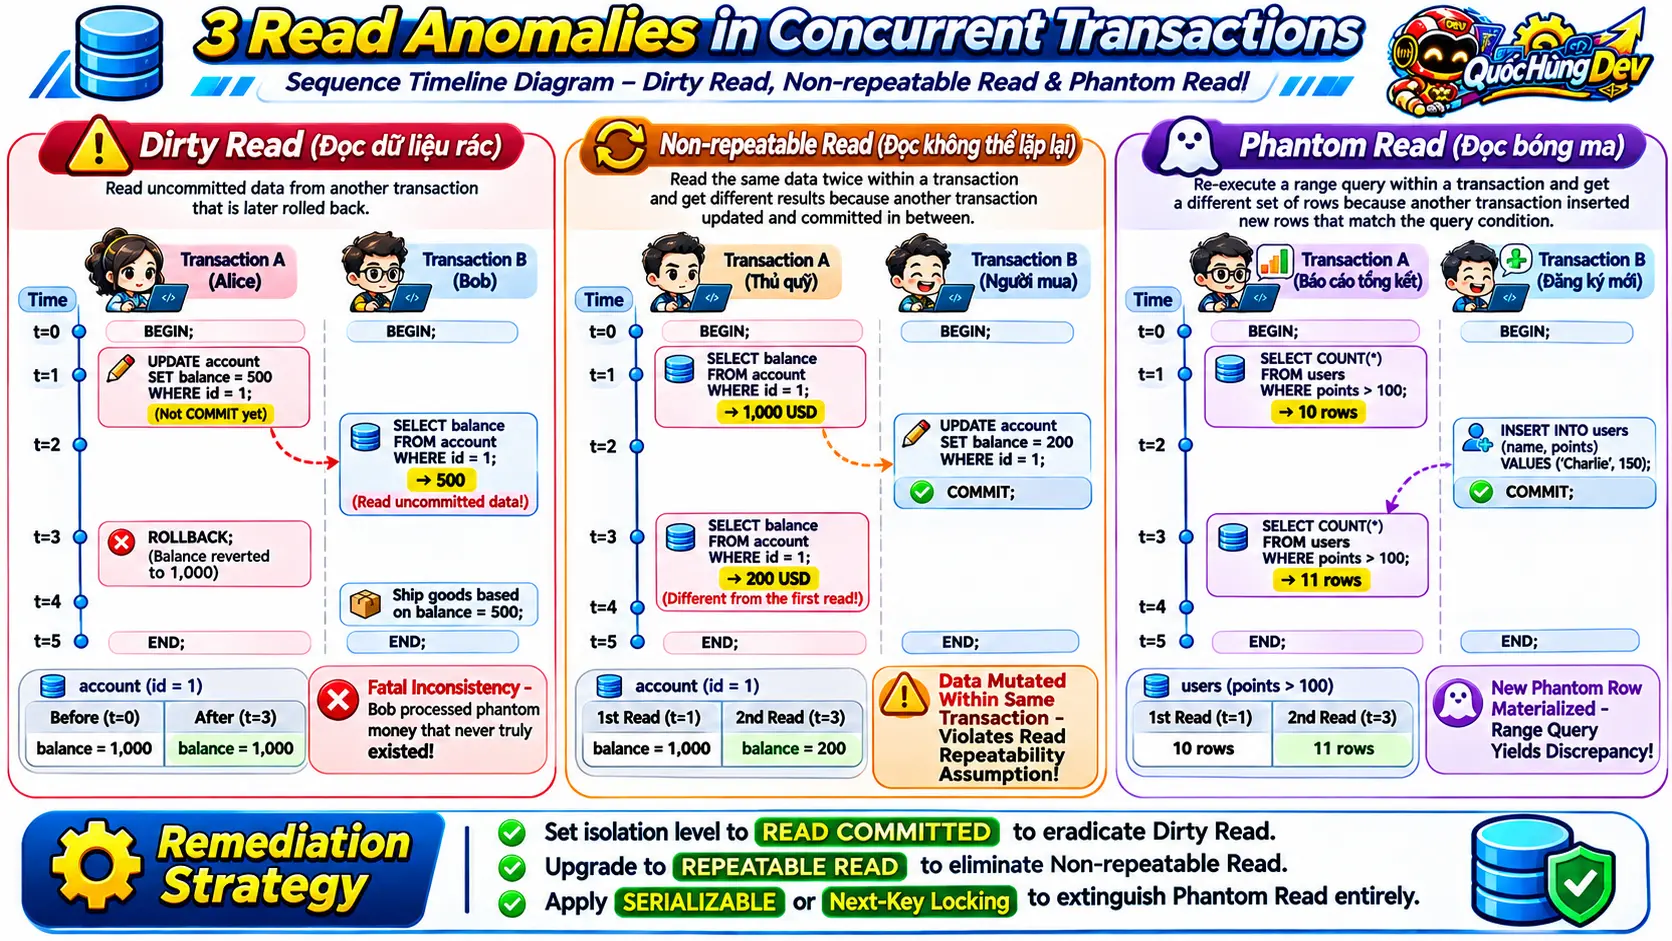
Trong các hệ thống xử lý giao dịch trực tuyến (OLTP), việc hiểu rõ bản chất của các lỗi đọc dữ liệu transaction là điều kiện tiên quyết để phòng ngừa rủi ro. Ba hiện tượng đọc dị thường kinh điển bao gồm dirty read, non-repeatable read và phantom read, mỗi loại phản ánh một mức độ rò rỉ trạng thái giữa các phiên làm việc song song.
Hiện tượng đọc dữ liệu chưa xác nhận (dirty read)
Dirty read xảy ra khi phiên giao dịch A đọc một giá trị được sửa đổi bởi phiên giao dịch B, nhưng phiên B vẫn chưa thực thi lệnh COMMIT. Nếu phiên B sau đó gặp sự cố và gọi ROLLBACK để hủy thao tác, giá trị mà phiên A đã đọc được thực chất chưa từng tồn tại hợp lệ trên hệ thống dữ liệu.
Xét tình huống thực tế trong hệ thống quản lý kho hàng: Sản phẩm có tồn kho bằng 10. Phiên B mở transaction và cập nhật tồn kho về 0 nhưng chưa xác nhận. Nếu phiên A chạy ở mức Read Uncommitted trên MySQL, phiên A sẽ đọc được tồn kho bằng 0 và trả về thông báo hết hàng cho người mua.
-- Kịch bản mô phỏng lỗi dirty read trên MySQL
-- Phiên B:
BEGIN;
UPDATE products SET stock = 0 WHERE id = 1; -- Chưa gọi COMMIT

-- Phiên A (Cấu hình Read Uncommitted):
SET TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
BEGIN;
SELECT stock FROM products WHERE id = 1; -- Kết quả trả về 0 (Đọc dữ liệu bẩn!)

-- Phiên B gặp sự cố logic:
ROLLBACK;

-- Phiên A đọc lại:
SELECT stock FROM products WHERE id = 1; -- Kết quả trở lại 10
COMMIT;
Hiện tượng đọc dữ liệu không lặp lại (non-repeatable read)
Non-repeatable read xuất hiện khi một transaction đọc cùng một hàng dữ liệu hai lần liên tiếp nhưng nhận về hai giá trị khác nhau. Nguyên nhân là do một transaction khác đã can thiệp vào giữa hai lần đọc đó, thực hiện lệnh UPDATE trên hàng dữ liệu và hoàn tất COMMIT thành công.
Lỗi này xảy ra rất phổ biến ở mức cô lập Read Committed. Trong mức Read Committed, mỗi câu lệnh SELECT đơn lẻ được gán một ảnh chụp độc lập tại thời điểm câu lệnh đó bắt đầu chạy. Do đó, nếu phiên khác vừa cập nhật và commit dữ liệu trước khi câu lệnh SELECT thứ hai diễn ra, phiên hiện tại sẽ lập tức nhìn thấy giá trị mới, phá vỡ tính lặp lại của dữ liệu trong cùng một transaction.
-- Kịch bản non-repeatable read trên PostgreSQL (Read Committed)
-- Phiên A:
BEGIN ISOLATION LEVEL READ COMMITTED;
SELECT stock FROM products WHERE id = 1; -- Trả về 10

-- Phiên B (Thực thi độc lập và commit):
UPDATE products SET stock = 7 WHERE id = 1;

-- Phiên A tiếp tục thực thi trong cùng transaction:
SELECT stock FROM products WHERE id = 1; -- Trả về 7 (Giá trị đã bị thay đổi!)
COMMIT;
Hiện tượng truy vấn bóng ma (phantom read)
Phantom read là hiện tượng xảy ra khi một transaction thực hiện cùng một câu truy vấn tìm kiếm theo điều kiện phạm vi hai lần, nhưng tập kết quả trả về ở lần thứ hai chứa thêm các hàng mới hoặc mất đi các hàng cũ. Khác với non-repeatable read tập trung vào sự biến đổi giá trị của một hàng đã tồn tại, phantom read liên quan đến sự xuất hiện hoặc biến mất của toàn bộ bản ghi mới trong tập hợp.
Ví dụ, khi một tiến trình tài chính tính tổng chi phí nhân sự của phòng ban có điều kiện lương trên mức định mức. Lần đếm đầu tiên ghi nhận 5 nhân sự. Trong lúc tiến trình đang tính toán, một phiên khác chèn thêm một nhân viên mới thỏa mãn điều kiện và commit. Lần đếm tiếp theo nhảy vọt lên 6 nhân sự, dẫn đến sự sai lệch nghiêm trọng trong các báo cáo tổng hợp cuối kỳ.
-- Kịch bản phantom read
-- Phiên A:
BEGIN ISOLATION LEVEL READ COMMITTED;
SELECT count(*) FROM products WHERE stock > 0; -- Trả về 2 sản phẩm

-- Phiên B chèn thêm bản ghi mới:
INSERT INTO products (id, name, stock) VALUES (3, 'Sản phẩm mới', 5);

-- Phiên A đếm lại trong cùng transaction:
SELECT count(*) FROM products WHERE stock > 0; -- Trả về 3 sản phẩm (Xuất hiện hàng bóng ma!)
COMMIT;
Cơ chế MVCC và kiến trúc lưu trữ đa phiên bản chuyên sâu
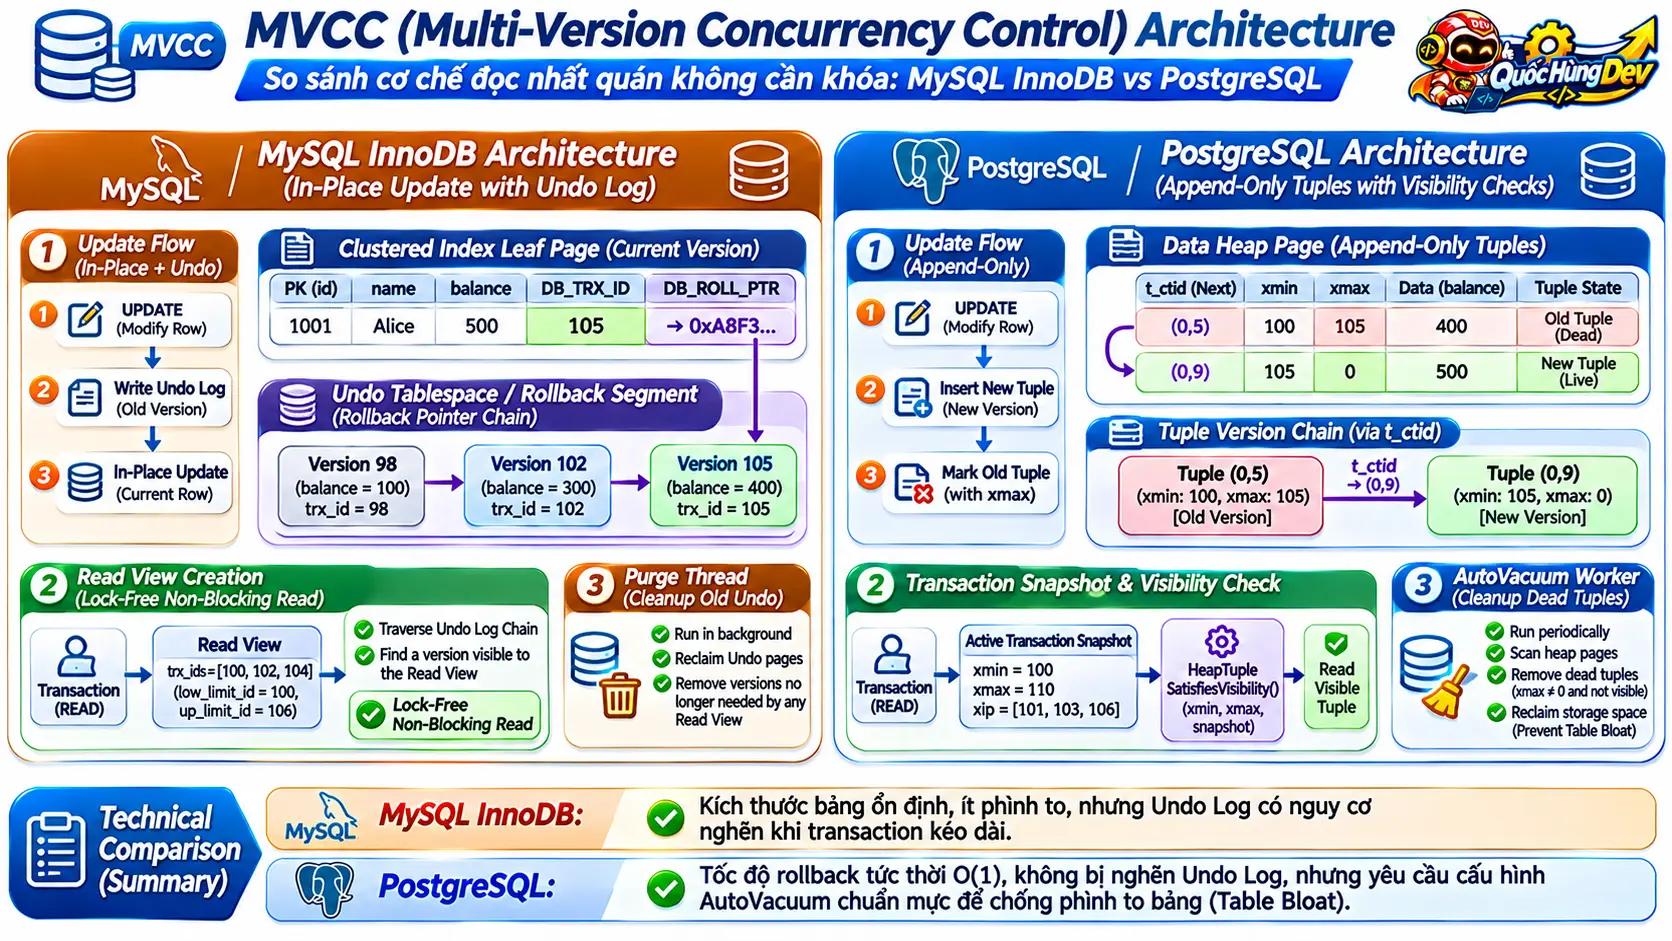
Để giải quyết triệt để các xung đột đọc ghi mà không làm suy giảm hiệu năng hệ thống, cả PostgreSQL và MySQL đều trang bị cơ chế kiểm soát đồng thời đa phiên bản MVCC. Mặc dù cùng chia sẻ mục tiêu cung cấp Snapshot Isolation cho từng mức cô lập transaction, kiến trúc vật lý bên dưới của hai hệ quản trị này lại đi theo hai con đường kỹ thuật hoàn toàn tách biệt.
Cấu trúc hàng dữ liệu xmin và xmax trong PostgreSQL
Trong hạt nhân PostgreSQL, mỗi hàng dữ liệu (Tuple) lưu trữ trên đĩa cứng đều sở hữu một phần Header đặc biệt chứa hai trường siêu dữ liệu tối quan trọng là xmin và xmax. Trường xmin lưu mã định danh Transaction ID (XID) của phiên đã tạo ra bản ghi, trong khi xmax lưu XID của phiên đã cập nhật hoặc xóa bản ghi đó.
Khi bạn thực hiện câu lệnh UPDATE trong PostgreSQL, hệ thống không bao giờ ghi đè trực tiếp lên vị trí vật lý cũ. Thay vào đó, PostgreSQL điền XID hiện tại vào trường xmax của bản ghi ban đầu để đánh dấu nó đã hết hiệu lực, rồi tạo ra một Tuple hoàn toàn mới trên vùng nhớ Heap với xmin bằng XID hiện tại.
-- Khảo sát siêu dữ liệu xmin và xmax trong PostgreSQL
SELECT xmin, xmax, id, stock FROM products WHERE id = 1;
-- Kết quả: xmin = 1050 | xmax = 0 | id = 1 | stock = 10

-- Cập nhật số lượng tồn kho:
UPDATE products SET stock = 8 WHERE id = 1;

-- Kiểm tra lại trạng thái sau khi cập nhật:
SELECT xmin, xmax, id, stock FROM products WHERE id = 1;
-- Kết quả mới: xmin = 1051 | xmax = 0 | id = 1 | stock = 8
-- Bản ghi cũ có xmin = 1050 giờ đây đã có xmax = 1051 và trở thành Dead Tuple
Khi một transaction đọc dữ liệu, PostgreSQL so sánh XID của transaction với giá trị xmin và xmax của từng Tuple theo các quy tắc hiển thị. Nhờ đó, một truy vấn chỉ đọc đúng phiên bản thuộc về quá khứ mà nó được phép thấy, giúp câu lệnh SELECT chạy hoàn toàn tự do mà không cần giữ bất kỳ ổ khóa nào trên bảng. Để tìm hiểu cách thiết lập hạ tầng PostgreSQL tối ưu từ đầu, hãy xem hướng dẫn cấu hình server PostgreSQL chuẩn của chúng tôi.
Cơ chế undo log và rollback segment trong MySQL InnoDB
Khác biệt hoàn toàn với triết lý tạo Tuple mới của PostgreSQL, động cơ InnoDB trong MySQL quản lý MVCC thông qua cấu trúc chỉ mục phân cụm và không gian nhật ký hoàn tác (undo log). Mỗi hàng trong bảng InnoDB luôn được bổ sung ba trường ẩn gồm DB_TRX_ID (mã transaction gần nhất sửa đổi), DB_ROLL_PTR (con trỏ trỏ đến bản ghi undo log tương ứng), và DB_ROW_ID.
Khi câu lệnh UPDATE diễn ra trong InnoDB, bản ghi mới được ghi đè trực tiếp tại chỗ trên trang lá của Clustered Index. Dữ liệu ban đầu được đẩy ngược vào vùng nhớ undo log, và trường DB_ROLL_PTR sẽ trỏ tới chuỗi undo log đó. Nếu một transaction quá khứ cần đọc lại phiên bản cũ, InnoDB sẽ duyệt ngược theo con trỏ DB_ROLL_PTR để tái tạo lại trạng thái dữ liệu chính xác tại thời điểm quá khứ.
Kiến trúc này giúp MySQL tiết kiệm đáng kể không gian đĩa cho bảng chính vì không sinh ra các Dead Tuple phân mảnh. Tuy nhiên, nếu các transaction đọc kéo dài thời gian mở, chuỗi undo log sẽ kéo dài không giới hạn, khiến chi phí duyệt con trỏ tái tạo dữ liệu trở nên cực kỳ đắt đỏ và làm cạn kiệt dung lượng Tablespace hệ thống.
Tình huống ứng dụng thực tế theo phòng ban và nghiệp vụ
Việc lựa chọn mức cô lập transaction không phải là bài toán lý thuyết thuần túy mà gắn liền trực tiếp với rủi ro tài chính của từng phân hệ nghiệp vụ doanh nghiệp. Hai kịch bản kinh điển dưới đây minh họa rõ nét cách thức các khiếm khuyết cô lập dẫn đến thiệt hại hữu hình trong vận hành sản phẩm.
Xử lý trừ kho hàng hóa trong thương mại điện tử
Trong các chiến dịch bán hàng trực tuyến Flash Sale, hàng chục nghìn yêu cầu mua hàng có thể cùng tập trung vào một sản phẩm duy nhất trong một giây. Nếu dịch vụ backend chỉ áp dụng mức cô lập transaction mặc định Read Committed mà không có kỹ thuật khóa bảo vệ, thảm họa Overselling (bán vượt số lượng tồn thực tế) chắc chắn sẽ bùng nổ.
Khi tồn kho chỉ còn đúng 1 sản phẩm, cả hai tiến trình của hai khách hàng A và B cùng đọc được số lượng tồn bằng 1. Cả hai tiến trình đều xác nhận còn hàng, lập tức sinh đơn hàng mới và gửi lệnh cập nhật trừ kho xuống cơ sở dữ liệu. Kết quả là hệ thống ghi nhận thành công 2 đơn hàng, trong khi số lượng thực tế trong kho chỉ đủ cung cấp cho 1 người, gây khủng hoảng chăm sóc khách hàng và tổn hại uy tín thương hiệu.
Khớp lệnh giao dịch ví điện tử và sổ cái tài chính
Trong hệ thống ví điện tử và cổng thanh toán ngân hàng, quy trình chuyển tiền luôn đòi hỏi trừ số dư tài khoản gửi và cộng số dư tài khoản nhận. Đồng thời, báo cáo kiểm toán đối soát cuối ngày phải đảm bảo tổng tiền tệ trong toàn bộ hệ thống luôn cân bằng theo nguyên lý bút toán kép.
Nếu chạy tác vụ đối soát trên mức Read Committed trong lúc hàng nghìn giao dịch đang chuyển tiền liên tục, báo cáo sẽ gặp phải hiện tượng đọc không lặp lại và bóng ma. Số tiền vừa được trừ khỏi tài khoản A nhưng chưa kịp ghi có vào tài khoản B sẽ hoàn toàn biến mất khỏi bức ảnh chụp dữ liệu, tạo ra sự chênh lệch số dư ảo khiến đội ngũ tài chính lầm tưởng hệ thống bị rò rỉ tiền tệ.
Cách sửa lỗi lost update và kỹ thuật retry đồng thời nâng cao
Hiện tượng mất mát cập nhật (lost update) là lỗi tương tranh nguy hiểm nhất vì cơ sở dữ liệu hoàn toàn không báo lỗi, cả hai giao dịch đều COMMIT thành công, nhưng kết quả tính toán cuối cùng lại bị sai lệch hoàn toàn. Nắm vững cách sửa lỗi lost update là yêu cầu sống còn đối với mọi kỹ sư phát triển backend cấp cao.
Nguyên nhân gây mất cập nhật trên mức read committed
Mẫu thiết kế tai hại nhất thường bắt đầu bằng thao tác đọc dữ liệu ra bộ nhớ ứng dụng: lập trình viên dùng câu lệnh SELECT số dư vào biến RAM, lấy biến RAM trừ đi lượng tiêu thụ trong code ứng dụng, rồi gọi câu lệnh UPDATE ghi đè giá trị mới vào bảng. Nếu hai luồng cùng đọc ra số dư 100 và cùng trừ đi 10, cả hai luồng sẽ đều tính ra 90 và lần lượt ghi đè số 90 vào cơ sở dữ liệu.
-- Mẫu code sai lầm dẫn đến lost update
-- Luồng A:
BEGIN;
SELECT stock FROM products WHERE id = 1; -- Đọc được 10, code Python tính 10 - 1 = 9

-- Luồng B cùng lúc:
BEGIN;
SELECT stock FROM products WHERE id = 1; -- Cũng đọc được 10, code Python tính 10 - 1 = 9

-- Luồng A cập nhật và commit:
UPDATE products SET stock = 9 WHERE id = 1;
COMMIT;

-- Luồng B cập nhật đè và commit:
UPDATE products SET stock = 9 WHERE id = 1;
COMMIT;
-- Kết quả trong kho là 9, dù đã bán 2 món hàng!
So sánh PostgreSQL và MySQL khi xảy ra xung đột ghi đồng thời
Khi thực hiện so sánh PostgreSQL và MySQL ở mức cô lập Repeatable Read, sự khác biệt trong tư duy thiết kế của hai hệ thống bộc lộ rõ rệt nhất. Trong cùng một kịch bản hai transaction song song cùng cố gắng cập nhật một hàng dữ liệu, hai cơ sở dữ liệu sẽ đưa ra phản ứng hoàn toàn trái ngược nhau.
Trên PostgreSQL, nếu phiên A đã cập nhật hàng dữ liệu và commit, khi phiên B (đang chạy ở Repeatable Read) cố gắng cập nhật cùng hàng dữ liệu đó, PostgreSQL sẽ lập tức ném ra mã lỗi ngoại lệ nghiêm trọng: ERROR: could not serialize access due to concurrent update (SQLSTATE 40001). PostgreSQL từ chối cho phép phiên B tiếp tục vì bức ảnh chụp ban đầu của phiên B đã không còn khớp với trạng thái thực tế của dữ liệu, buộc toàn bộ transaction của B phải ROLLBACK.
Ngược lại, trên MySQL InnoDB ở mức mặc định Repeatable Read, lệnh UPDATE không dùng Consistent Read (đọc snapshot) mà tự động chuyển sang cơ chế Current Read (đọc có khóa trực tiếp trên bản ghi mới nhất). Do đó, phiên B sẽ không bị ném lỗi, mà âm thầm lấy giá trị mới nhất vừa được commit bởi phiên A để tiếp tục trừ dồn. Đây là sự khác biệt tinh tế nhưng cực kỳ nguy hiểm khiến nhiều ứng dụng bị đổ vỡ khi chuyển dịch hạ tầng từ MySQL sang PostgreSQL mà không có cơ chế retry xử lý lỗi 40001.
Giải pháp nguyên tử và cơ chế khóa dòng có điều kiện
Để giải quyết dứt điểm lỗi lost update mà không cần nâng mức cô lập transaction lên Repeatable Read, giải pháp đơn giản và tối ưu hiệu năng nhất là chuyển giao toàn bộ phép toán số học xuống hạt nhân của database thông qua câu lệnh UPDATE nguyên tử kèm điều kiện kiểm tra biên an toàn.
-- Giải pháp 1: Câu lệnh UPDATE nguyên tử có điều kiện biên
UPDATE products
SET stock = stock - 1
WHERE id = 1 AND stock >= 1;
-- Nếu số dòng ảnh hưởng = 1 -> Mua hàng thành công
-- Nếu số dòng ảnh hưởng = 0 -> Hết hàng, giao dịch tự động dừng an toàn
Đối với các quy trình nghiệp vụ phức tạp đòi hỏi phải tính toán nhiều bước trung gian trước khi ghi, kỹ thuật khóa dòng bi quan bằng cú pháp SELECT … FOR UPDATE là tiêu chuẩn bắt buộc. Khóa này buộc mọi phiên đến sau phải xếp hàng chờ cho đến khi phiên đầu tiên gọi COMMIT hoặc ROLLBACK. Bạn có thể tham khảo thêm bài phân tích chuyên sâu về cơ chế locking database: optimistic và pessimistic locking để lựa chọn công cụ phù hợp.
-- Giải pháp 2: Khóa dòng dữ liệu bi quan (Pessimistic Locking)
BEGIN;
SELECT stock FROM products WHERE id = 1 FOR UPDATE;
-- Tại thời điểm này, không phiên nào khác có thể sửa hoặc khóa hàng id = 1
UPDATE products SET stock = stock - 1 WHERE id = 1;
COMMIT; -- Giải phóng khóa ngay khi hoàn tất
Mô hình thử lại với độ trễ lũy thừa và xáo trộn ngẫu nhiên
Khi quyết định nâng mức cô lập transaction lên Repeatable Read hoặc Serializable trên PostgreSQL, quy tắc bất di bất dịch của kỹ sư backend là phải xây dựng cơ chế bắt mã lỗi SerializationFailure (SQLSTATE 40001) và tự động thử lại toàn bộ transaction từ đầu.
Nếu hàng loạt yêu cầu cùng bị lỗi 40001 và cùng thử lại đồng thời ở đúng một khoảng thời gian cố định, hệ thống sẽ rơi vào hiện tượng bão thử lại, khiến cơ sở dữ liệu bị tê liệt hoàn toàn. Do đó, thuật toán thử lại bắt buộc phải tích hợp độ trễ tăng dần theo hàm lũy thừa kết hợp với yếu tố ngẫu nhiên (Full Jitter) để phân tán tải.
# Đoạn mã Python chuẩn mực xử lý Retry với Exponential Backoff và Jitter
import time
import random
import psycopg
from psycopg import errors

def execute_transaction_with_retry(conn_str, max_retries=5, base_delay=0.05):
    for attempt in range(1, max_retries + 1):
        try:
            with psycopg.connect(conn_str) as conn:
                with conn.transaction():
                    conn.execute("SET TRANSACTION ISOLATION LEVEL REPEATABLE READ;")
                    cur = conn.execute("SELECT stock FROM products WHERE id = %s;", (1,))
                    stock = cur.fetchone()[0]
                    if stock <= 0:
                        return "Hết hàng"
                    conn.execute("UPDATE products SET stock = %s WHERE id = %s;", (stock - 1, 1))
                    return f"Cập nhật thành công, tồn kho còn lại: {stock - 1}"
        except errors.SerializationFailure:
            if attempt == max_retries:
                raise RuntimeError("Vượt quá số lần thử lại cho phép do xung đột cao")
            # Tính toán độ trễ lũy thừa kèm xáo trộn ngẫu nhiên (Full Jitter)
            sleep_time = random.uniform(0, base_delay * (2 ** attempt))
            time.sleep(sleep_time)
    return "Thất bại"
Chi phí tài nguyên database và bài toán tối ưu ngân sách hạ tầng
Việc lựa chọn mức độ an toàn cao hơn cho dữ liệu luôn đi kèm với những đánh đổi nặng nề về chi phí phần cứng và công năng xử lý của máy chủ. Quản trị viên hệ thống cần tính toán kỹ lưỡng chi phí tài nguyên database trước khi quyết định nâng cấp mức cô lập transaction trên toàn bộ ứng dụng.
Áp lực bộ nhớ RAM và chu kỳ dọn rác vacuum
Trong môi trường PostgreSQL vận hành ở mức Repeatable Read hoặc Serializable, sự hiện diện của các transaction đọc kéo dài (như tác vụ xuất báo cáo phân tích chạy mất 30 phút) sẽ ngăn cản tiến trình AutoVacuum dọn dẹp các Dead Tuple được sinh ra trong suốt khoảng thời gian đó. Các hàng dữ liệu rác không thể bị xóa bỏ vì transaction cũ vẫn cần đọc chúng thông qua snapshot ban đầu.
Hậu quả trực tiếp là hiện tượng phình to bảng và phình to chỉ mục, khiến kích thước dữ liệu trên đĩa tăng gấp nhiều lần dung lượng thực tế. Bộ nhớ đệm Shared Buffers nhanh chóng bị tràn ngập bởi các trang dữ liệu rác, buộc ổ cứng SSD phải hoạt động hết công suất để nạp trang mới, làm suy giảm nghiêm trọng tốc độ phản hồi của toàn bộ hệ sinh thái dịch vụ. Để nhận diện các dấu hiệu suy thoái hiệu năng tương tự, bạn có thể tham khảo bài viết những sai lầm khi tối ưu cơ sở dữ liệu của chúng tôi.
Nghẽn cổ chai CPU và hiện tượng tranh chấp khóa deadlock
Khi nâng mức cô lập transaction lên Serializable hoặc lạm dụng các ổ khóa SELECT FOR UPDATE trong môi trường tải cao, số lượng phiên phải xếp hàng chờ đợi tài nguyên sẽ tăng vọt. Hàng nghìn kết nối bị treo trong trạng thái chờ giải phóng khóa khiến số lượng luồng xử lý của hệ điều hành tăng cao, kéo theo áp lực chuyển đổi ngữ cảnh CPU đè nặng lên hạ tầng máy chủ.
Nguy cơ xảy ra bế tắc dữ liệu (deadlock) cũng gia tăng theo cấp số nhân khi các transaction cùng cố gắng chiếm giữ tài nguyên chéo nhau. Mỗi khi phát hiện deadlock, cơ sở dữ liệu buộc phải kích hoạt thuật toán Deadlock Detector tốn nhiều chu kỳ xử lý CPU, rồi chủ động hy sinh một transaction để giải phóng luồng còn lại, gây lãng phí toàn bộ tài nguyên tính toán đã bỏ ra trước đó.
Ma trận ra quyết định theo quy mô hệ thống và tính chất dự án
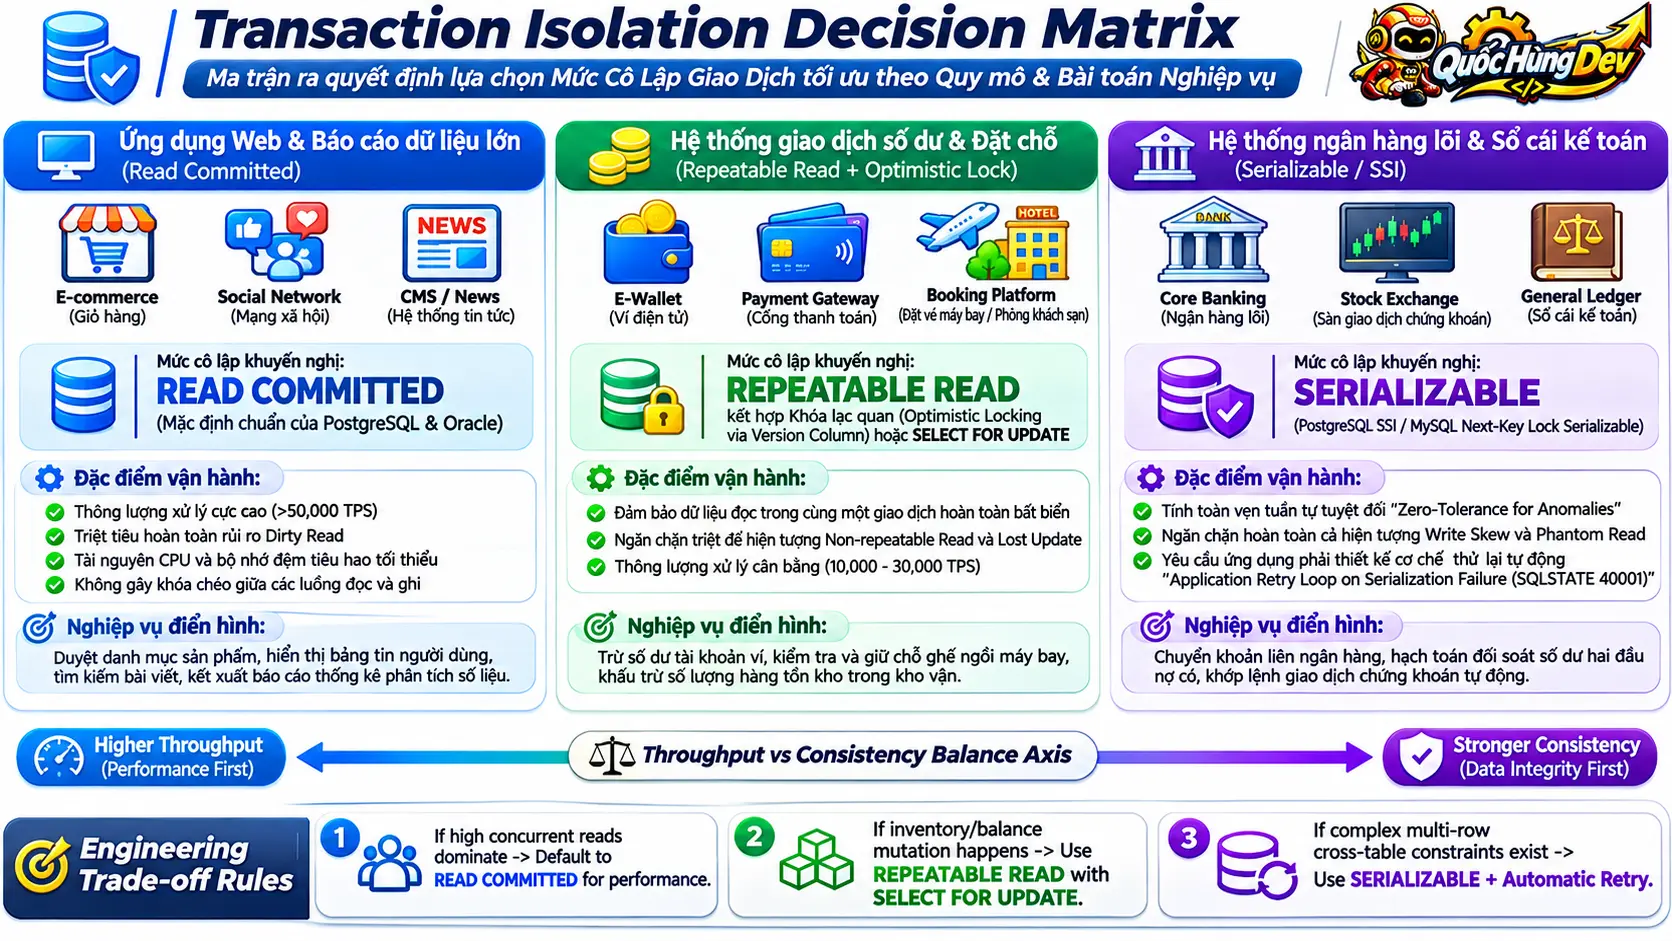
Không có một mức cô lập đơn lẻ nào là hoàn hảo cho mọi tính năng trong một ứng dụng. Kiến trúc sư hệ thống chuyên nghiệp luôn áp dụng chiến lược phân tách mức cô lập transaction linh hoạt theo từng ngữ cảnh nghiệp vụ cụ thể để tối ưu hóa đồng thời tính an toàn và chi phí vận hành.
Hệ thống khởi nghiệp và web ứng dụng thông thường
Duy trì mức mặc định Read Committed cho toàn bộ ứng dụng để đạt thông lượng cao nhất. Đối với các thao tác cộng trừ tồn kho hoặc số dư, tuyệt đối không tính toán trên RAM mà sử dụng trực tiếp các câu lệnh UPDATE nguyên tử có điều kiện kiểm tra biên.
Thương mại điện tử và cổng thanh toán quy mô lớn
Giữ cấu hình mặc định Read Committed cho các truy vấn duyệt hàng hóa. Riêng tại các endpoint xử lý trừ tiền và giỏ hàng thanh toán, kích hoạt cơ chế khóa bi quan SELECT … FOR UPDATE hoặc sử dụng Repeatable Read đi kèm bộ lọc retry chuẩn mực.
Hệ thống sổ cái ngân hàng và báo cáo tài chính
Kích hoạt mức cô lập Serializable cho các nghiệp vụ kiểm tra logic chéo phức tạp (như tránh phân bổ cùng một ca làm việc cho nhiều người). Đối với tác vụ xuất báo cáo tổng hợp, mở riêng một transaction ở mức Repeatable Read để có ảnh chụp nhất quán hoàn hảo.
Checklist an toàn và lưu ý tuân thủ tính chất ACID trên production
Trước khi đưa bất kỳ tính năng xử lý giao dịch nào lên môi trường production, đội ngũ phát triển và vận hành cần rà soát nghiêm ngặt các điểm kiểm soát an toàn dưới đây để bảo toàn tính toàn vẹn dữ liệu.
Cảnh báo kiến trúc: Không bao giờ thiết lập mức cô lập Serializable cho toàn bộ ứng dụng trên cấp độ toàn cục. Hành động này sẽ biến mọi truy vấn đơn giản thành đối tượng tranh chấp, gây bùng nổ xung đột deadlock và làm sập toàn bộ hệ thống khi lưu lượng người dùng tăng cao đột biến.
- Rà soát triệt để các vị trí đọc rồi mới ghi: Loại bỏ hoàn toàn các đoạn mã gán số dư từ câu lệnh SELECT ra biến bộ nhớ RAM rồi mới thực hiện câu lệnh UPDATE ghi đè.
- Đẩy toàn bộ phép toán số học xuống hạt nhân SQL: Áp dụng công thức nguyên tử UPDATE table SET col = col – val WHERE col >= val cho mọi thao tác trừ tồn kho và tài chính.
- Bắt buộc xây dựng vòng lặp Retry khi nâng mức cô lập: Mọi transaction chạy ở Repeatable Read hoặc Serializable trên PostgreSQL bắt buộc phải có cơ chế bắt mã lỗi 40001 và thử lại với thuật toán Exponential Backoff kèm Jitter.
- Cô lập phạm vi cho từng transaction: Giữ cấu hình mặc định mức Read Committed cho toàn bộ máy chủ, chỉ kích hoạt mức cô lập cao cho riêng transaction cụ thể thông qua cú pháp BEGIN ISOLATION LEVEL.
- Thử nghiệm thực tế khi chuyển đổi hệ quản trị: Tuyệt đối không giả định hành vi của PostgreSQL giống hệt MySQL ở cùng mức Repeatable Read, luôn kiểm thử hành vi xung đột bằng hai cửa sổ terminal chạy song song.
- Giám sát chặt chẽ thời gian sống của transaction: Cấu hình tham số idle_in_transaction_session_timeout trên PostgreSQL để tự động hủy các kết nối bị treo quên đóng, bảo vệ tiến trình AutoVacuum không bị đình trệ.
- Tối ưu hóa chỉ mục cho các câu lệnh khóa: Đảm bảo các câu truy vấn có mệnh đề FOR UPDATE luôn sử dụng chỉ mục Index chính xác để tránh việc cơ sở dữ liệu phải khóa toàn bộ bảng.
Câu hỏi thường gặp về mức cô lập transaction trong cơ sở dữ liệu
Dưới đây là phần giải đáp chi tiết cho những thắc mắc phổ biến nhất của các kỹ sư backend khi cấu hình và tối ưu hóa mức cô lập transaction trên hệ thống thực tế.
Vì sao PostgreSQL không cung cấp mức cô lập Read Uncommitted thực thụ?
Bản chất của kiến trúc PostgreSQL là vận hành trên nền tảng kiểm soát đồng thời đa phiên bản MVCC. Khi một câu lệnh sửa đổi dữ liệu diễn ra, nó tạo ra một Tuple mới trên đĩa với trường xmin lưu mã transaction hiện tại. Các câu lệnh đọc luôn tuân theo các quy tắc kiểm tra trạng thái commit của transaction tạo ra Tuple đó. Để cho phép một tiến trình đọc dữ liệu chưa commit, PostgreSQL sẽ phải phá vỡ toàn bộ cấu trúc kiểm tra tính hợp lệ của Snapshot, điều này đi ngược lại hoàn toàn triết lý bảo toàn tính toàn vẹn của hệ thống. Do đó, PostgreSQL ánh xạ mức Read Uncommitted chạy hoàn toàn giống như Read Committed.
Mức cô lập Repeatable Read có ngăn chặn hoàn toàn lỗi lost update không?
Câu trả lời phụ thuộc vào hệ quản trị bạn đang sử dụng. Trên PostgreSQL, Repeatable Read ngăn chặn hoàn toàn lỗi lost update bằng cách ném ra mã lỗi SerializationFailure (40001) khi phát hiện hai phiên cùng sửa đổi một hàng, buộc phiên thứ hai phải hủy bỏ và thử lại. Tuy nhiên, trên MySQL InnoDB, câu lệnh UPDATE lại chuyển sang chế độ Current Read và âm thầm cập nhật tiếp trên dữ liệu mới nhất, điều này có thể dẫn đến hành vi khác biệt nếu ứng dụng của bạn giả định dữ liệu không bị thay đổi bên dưới.
Khi nào nên sử dụng mức cô lập Serializable thay vì Repeatable Read?
Bạn chỉ nên cân nhắc sử dụng Serializable khi ứng dụng gặp phải hiện tượng xung đột chéo (Write Skew) hoặc đòi hỏi tính đúng đắn tuyệt đối trên nhiều bảng độc lập mà các khóa dòng đơn lẻ không thể bao quát hết. Ví dụ điển hình là quy tắc nghiệp vụ: tổng số tiền trong tài khoản chính và tài khoản tiết kiệm phải luôn lớn hơn 0, hoặc một ca trực y tế phải luôn có ít nhất một bác sĩ trực. Tuy nhiên, khi kích hoạt Serializable trên PostgreSQL, bạn bắt buộc phải trang bị cơ chế thử lại chuyên nghiệp cho mọi câu lệnh truy vấn.
Cơ chế SELECT … FOR UPDATE khác gì so với nâng mức cô lập lên Serializable?
Cú pháp SELECT … FOR UPDATE là kỹ thuật khóa bi quan cục bộ chỉ tác động lên các hàng dữ liệu cụ thể được truy vấn, cho phép các tiến trình khác vẫn đọc ghi bình thường trên các hàng dữ liệu còn lại của bảng. Trong khi đó, Serializable là một cơ chế trừu tượng ở cấp độ toàn bộ transaction, giám sát mọi quan hệ đọc ghi để đảm bảo thứ tự thực thi tương đương với việc chạy lần lượt từng tiến trình. Sử dụng SELECT … FOR UPDATE mang lại hiệu năng ổn định hơn và ít gây ra các lỗi hủy bỏ transaction bất ngờ trên môi trường chịu tải cao.
Làm thế nào để kiểm tra mức cô lập transaction hiện tại trên PostgreSQL và MySQL?
Trên PostgreSQL, bạn có thể kiểm tra mức cô lập transaction của phiên hiện tại bằng câu lệnh SQL: SHOW transaction_isolation; hoặc kiểm tra cấu hình mặc định toàn cục bằng câu lệnh: SHOW default_transaction_isolation;. Trên MySQL, bạn thực thi câu lệnh: SELECT @@transaction_isolation; (hoặc SELECT @@tx_isolation trên các phiên bản cũ hơn) để xem giá trị cấu hình tương ứng đang áp dụng cho phiên làm việc.
Kết luận và định hướng kiến trúc dữ liệu bền vững
Quản trị mức cô lập transaction là nền tảng cốt lõi định hình độ tin cậy và sự bền vững của toàn bộ hệ thống cơ sở dữ liệu doanh nghiệp. Không có một công thức chung duy nhất nào có thể giải quyết hoàn hảo mọi bài toán tải, mà đòi hỏi kỹ sư kiến trúc phải thấu hiểu sâu sắc bản chất cơ chế MVCC, sự khác biệt giữa các hệ quản trị và đặc thù của từng luồng nghiệp vụ dữ liệu.
Việc áp dụng linh hoạt nguyên tắc cập nhật nguyên tử, kết hợp hợp lý giữa khóa bi quan có chọn lọc và cơ chế thử lại lũy thừa sẽ mang lại sự cân bằng hoàn hảo giữa thông lượng xử lý cao và tính nhất quán dữ liệu tuyệt đối. Một kiến trúc dữ liệu vững chắc được tôi luyện từ những nguyên lý nền tảng chính là bệ phóng an toàn nhất giúp hệ thống của bạn mở rộng quy mô mà không phải lo sợ những sai lệch số liệu trong đêm.